Autor: redakcja

  • Cursor wprowadza scentralizowane centrum zarządzania dodatkami i integracjami

    Cursor wprowadza scentralizowane centrum zarządzania dodatkami i integracjami

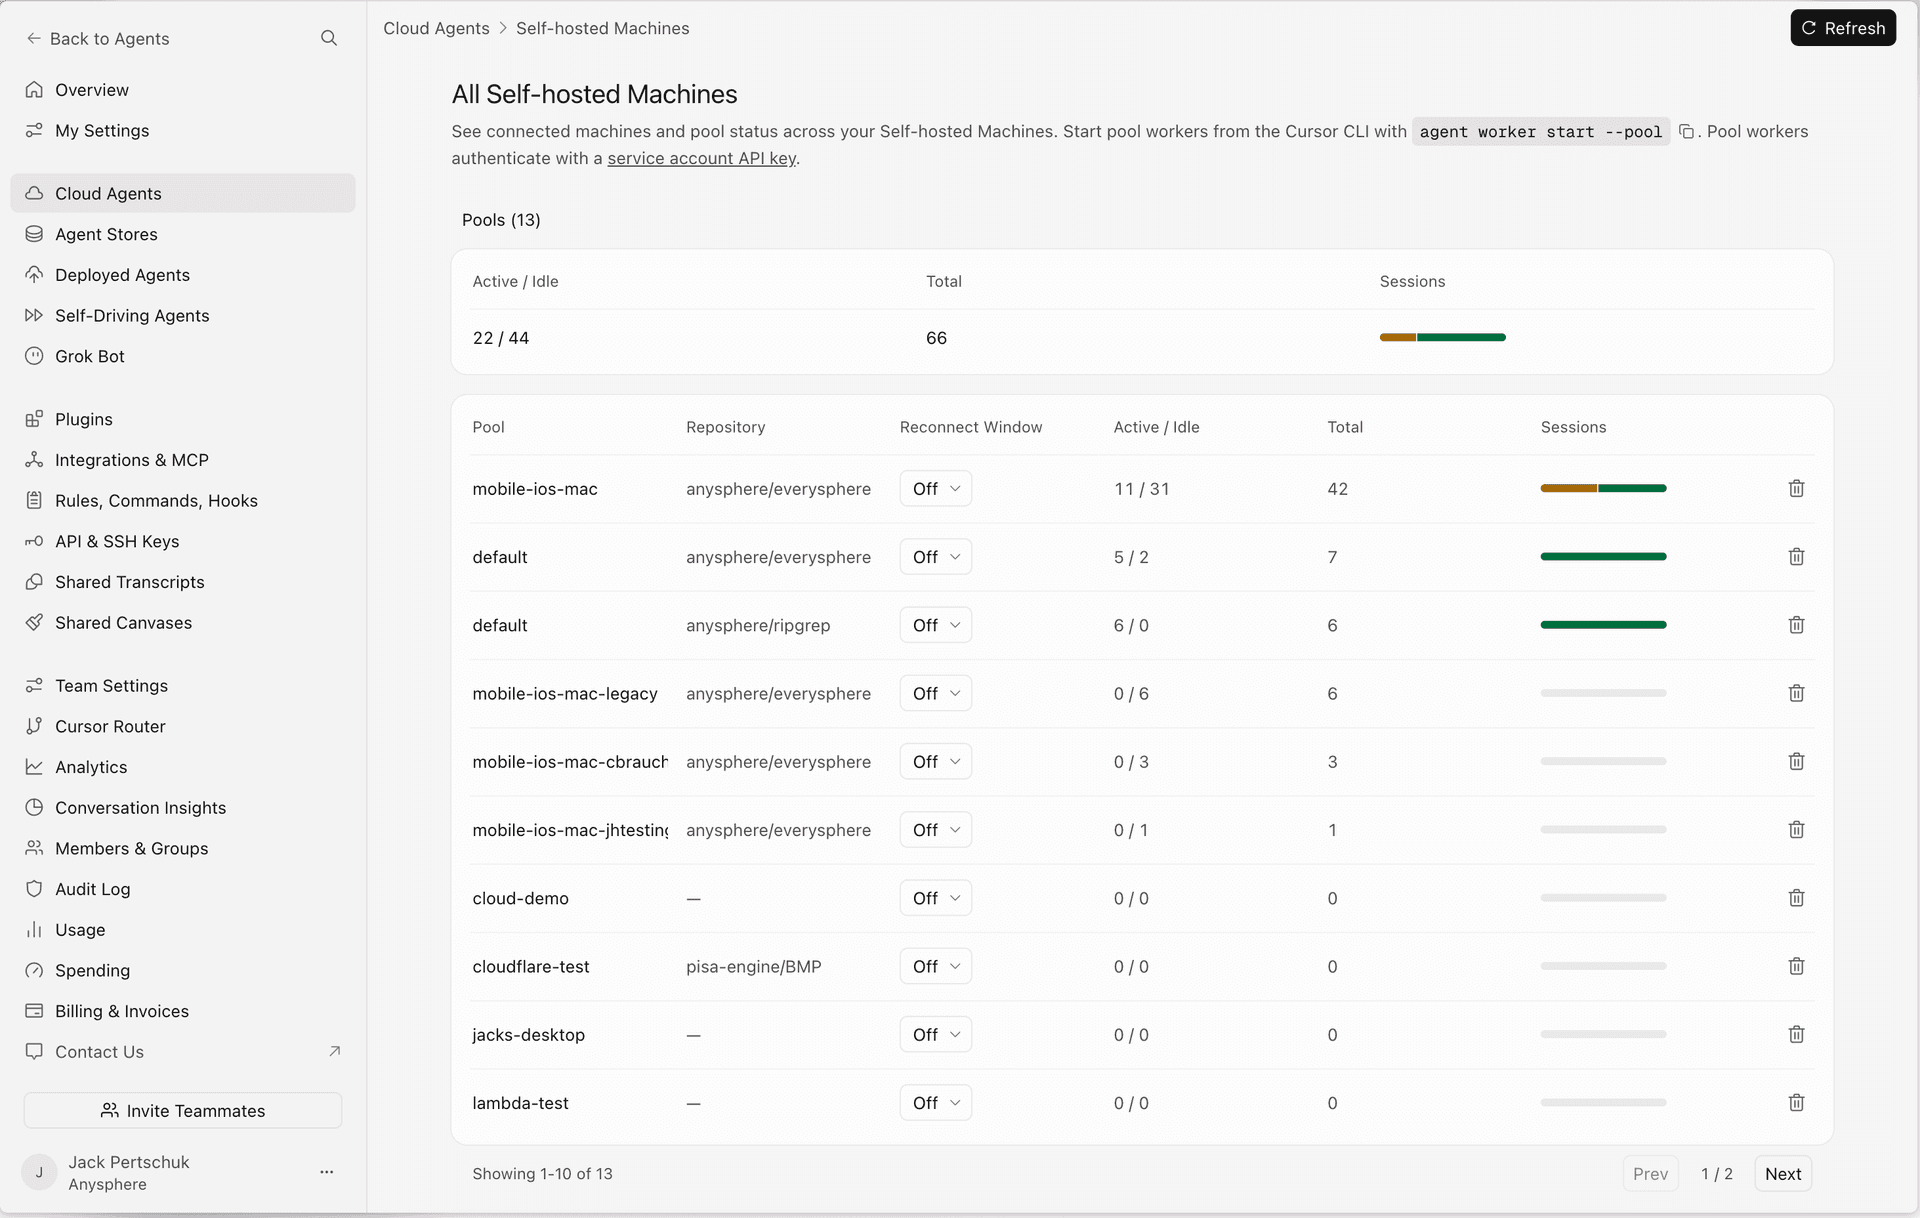
    Od lipca 2026 roku Cursor wprowadza scentralizowane centrum zarządzania dodatkami i integracjami, oferując nową stronę Customize. Ta strona łączy zarządzanie wtyczkami, umiejętnościami, serwerami MCP oraz subagentami w jednym miejscu, dostępna na poziomie użytkownika, zespołu i przestrzeni roboczej. Umożliwia to rezygnację z przeskakiwania między rozproszonymi plikami konfiguracyjnymi i ustawieniami w edytorze.

    Najważniejsze zmiany w pigułce

    • Scentralizowana strona Customize umożliwia zarządzanie wtyczkami, umiejętnościami, MCP, subagentami, regułami, komendami i hookami z jednego panelu.
    • Wtyczki jako pakiety dystrybucyjne – mogą zawierać wiele możliwości agenta jednocześnie: reguły, umiejętności, subagenty i serwery MCP w jednym pliku.
    • Zasięg zespołowy – zespoły mogą instalować wspólne serwery MCP przez domyślny marketplace, co zapewnia spójność środowisk deweloperskich.
    • Integracje z GitLab, Bitbucket i Azure DevOps rozszerzają wsparcie poza GitHub, w tym dla Bugbota i Cloud Agents.

    Koniec z fragmentacją ustawień

    Dotychczas personalizacja Cursora wymagała żonglowania plikami .cursorrules, ręcznego konfigurowania MCP oraz pamiętania, gdzie znajdowało się konkretne ustawienie. Nowa strona Customize rozwiązuje te problemy.

    Użytkownicy znajdą tam listę zainstalowanych dodatków oraz marketplace z możliwością jednego kliknięcia do instalacji. Możliwości zmian są precyzyjnie określone – coś może działać tylko na Twoim koncie, coś innego w całym zespole, a jeszcze coś wyłącznie w konkretnym projekcie. To zapewnia elastyczność przy zachowaniu kontroli.

    Szczególnie przydatna jest możliwość współdzielenia serwerów MCP na poziomie zespołu. Zamiast wysyłać każdemu członkowi zespołu instrukcje konfiguracji, lider ustawia Team MCP server raz, a reszta dostaje go automatycznie przez marketplace.

    Wtyczki, które niosą ze sobą cały ekosystem

    Nowa definicja wtyczek w Cursor wykracza poza tradycyjne rozumienie pluginów. Teraz to dystrybucyjny pakiet, który może zawierać reguły, umiejętności, komendy, subagenty, hooki oraz serwery MCP – wszystko w jednym.

    Przykładowo, można stworzyć wtyczkę "zespół backendowy", która zawiera reguły formatowania kodu, skróty do deploymentu, połączenie z firmowym serwerem MCP monitorującym staging oraz dwa subagenty do testów. Wystarczy jeden plik, aby przenieść cały ten zestaw na nową maszynę lub udostępnić nowemu członkowi zespołu.

    Subagenty działają w osobnych oknach kontekstowych, równolegle i odizolowane od głównego agenta. Można im zlecać zadania, które nie powinny zaśmiecać głównego kontekstu, lub uruchomić rój takich agentów do przetestowania aplikacji w czystych środowiskach.

    Szersze integracje dla zespołów rozproszonych
    Szersze integracje dla zespołów rozproszonych
    Źródło: cursor.com

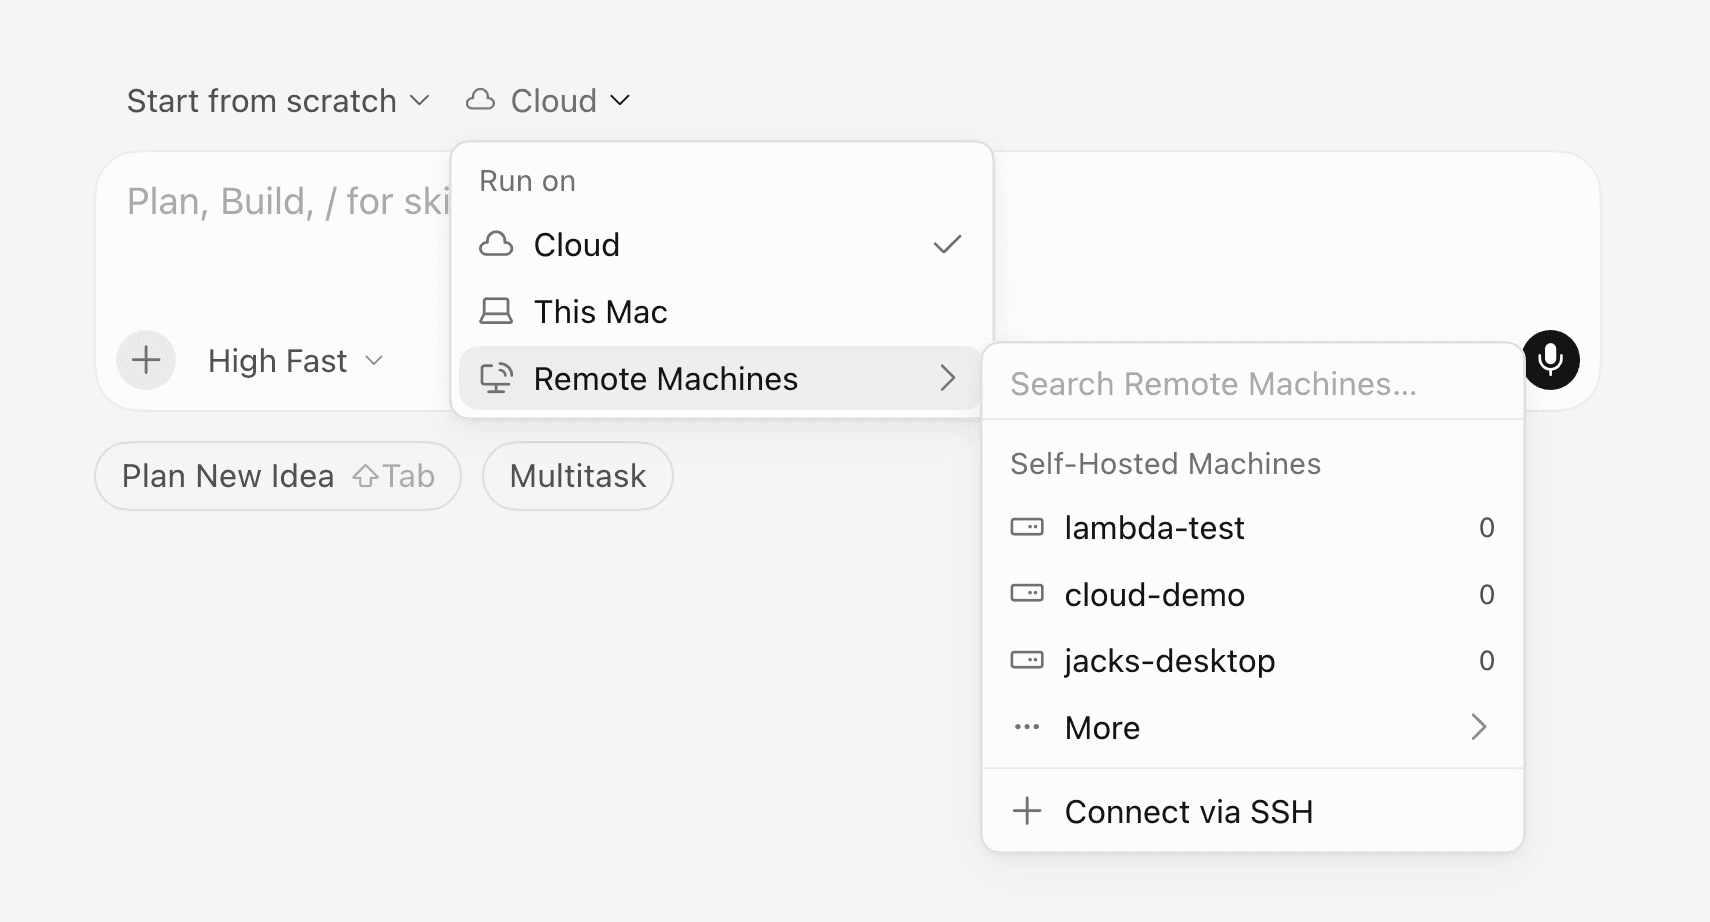
    Cursor dotychczas dobrze współpracował z GitHubem, ale nowa odsłona marketplace zespołowego otwiera możliwości dla użytkowników GitLaba, Bitbucketa i Azure DevOps. Dokumentacja potwierdza pełne wsparcie dla łączenia repozytoriów z tych platform oraz dla Bugbota, który teraz działa również w repozytoriach Bitbucket i Azure DevOps.

    Dla zespołów korporacyjnych, które korzystają z Azure DevOps ze względów compliance'owych, to istotna zmiana. Nie muszą już wybierać między polityką firmy a wygodą pracy z AI-asystentem.

    Dlaczego to ma znaczenie dla codziennej pracy
    Dlaczego to ma znaczenie dla codziennej pracy
    Źródło: cursor.com

    Zmiana ma głębsze znaczenie, niż mogłoby się wydawać. Dotychczas dostosowanie Cursora do własnych potrzeb wymagało dużej wiedzy o konfiguracji. Teraz wystarczy otworzyć Customize i kliknąć. Dla zespołów oznacza to koniec syndromu "u mnie działa" – środowisko deweloperskie można ustandaryzować na poziomie organizacji, pozostawiając programistom swobodę tam, gdzie to ma sens.

    Przenośne pakiety wtyczek ułatwiają także onboarding. Zamiast listy 20 rzeczy do skonfigurowania, nowa osoba dostaje link do firmowego pluginu i po minucie ma identyczne środowisko AI jak reszta zespołu.

    Co dalej z ekosystemem Cursora

    Choć w dokumentacji nie potwierdzono jeszcze rankingu marketplace ani gotowych szablonów wtyczek, kierunek zmian jest jasny. Cursor zmierza ku modelowi, w którym personalizacja jest centralnym elementem doświadczenia. Wraz z Origin (własnym hostingiem kodu) i Cloud Agents, tworzy się spójna platforma, gdzie kod, agenci AI i konfiguracja funkcjonują w jednym ekosystemie – z minimalnym tarciem między nimi.

    Ta aktualizacja to nie tylko kosmetyka interfejsu, ale przemyślana zmiana architektoniczna, która stawia elastyczność i współpracę zespołową w centrum doświadczenia z AI-podpowiedziami. Teraz konfiguracja Cursora przypomina w pełni umeblowane mieszkanie – z możliwością przemeblowania, gdy tylko zajdzie taka potrzeba.
    Źródła

  • Qwen-Code v0.19.1: lepsze odkrywanie serwerów MCP i garść poprawek stabilności

    Qwen-Code v0.19.1: lepsze odkrywanie serwerów MCP i garść poprawek stabilności

    Zespół QwenLM wydał 23 czerwca 2026 roku wersję v0.19.1 swojego otwartego agenta kodowania Qwen-Code. Ta aktualizacja nie wprowadza wielu nowych funkcji, ale koncentruje się na poprawkach stabilności oraz kilku ulepszeniach w interfejsie CLI związanych z protokołem MCP. Deweloperzy korzystający z narzędzia w połączeniu z zewnętrznymi źródłami danych powinni zauważyć różnice w działaniu.

    Co nowego w telegraficznym skrócie

    • MCP — uzupełnianie zasobów i wykrywanie serwerów działa sprawniej, co ułatwia konfigurację połączeń
    • Walidacja konfiguracji została poprawiona, eliminując błędy przy niestandardowych ustawieniach
    • Zarządzanie sesjami nie gubi stanu przy przełączaniu kontekstów roboczych
    • Bezpieczeństwo — załatano kilka luk związanych z obsługą poświadczeń w logach
    • Terminal UI i wewnętrzne przepływy pracy zostały usprawnione, choć nie wprowadzono znaczących zmian wizualnych

    MCP bez zbędnego klikania

    Qwen-Code od dawna wspiera Model Context Protocol jako główny mechanizm łączenia CLI z narzędziami zewnętrznymi. Umożliwia to podłączanie do plików, repozytoriów, baz danych, wewnętrznych serwisów czy API przez różne typy transportu: stdio, SSE oraz streamable HTTP. Wcześniej odkrywanie dostępnych serwerów i podpowiadanie zasobów było problematyczne.

    Wersja v0.19.1 wprowadza zmiany w tym zakresie. Polecenia takie jak qwen mcp add --transport http ... zyskują lepsze podpowiadanie składni. CLI potrafi teraz samodzielnie wykryć dostępne endpointy i zaproponować listę zasobów, co eliminuje konieczność ręcznego wpisywania ścieżek. Dla zespołów pracujących z wieloma serwerami MCP w różnych projektach to oszczędność czasu i zmniejszenie ryzyka literówek.

    Stabilność przede wszystkim

    Stabilność przede wszystkim

    Większość zmian w tym wydaniu to poprawki inżynieryjne. Deweloperzy Qwen-Code poprawili walidację konfiguracji — wcześniej niektóre kombinacje ustawień mogły prowadzić do cichych błędów lub wymuszać restart sesji. Teraz CLI natychmiast reaguje na nieprawidłowe wartości, dostarczając czytelne komunikaty.

    Zespół załatał również wycieki poświadczeń w logach. W poprzednich wersjach wrażliwe dane, takie jak klucze API czy tokeny, mogły pojawiać się w logach diagnostycznych przy włączonym debugowaniu. Po aktualizacji silnik logowania automatycznie usuwa te informacje przed zapisaniem ich na dysku.

    Zarządzanie sesjami również zostało poprawione. Wcześniej przełączanie między kontekstami roboczymi mogło prowadzić do utraty stanu połączeń MCP, co wymagało ręcznego odświeżania konfiguracji. Teraz CLI stabilnie utrzymuje kontekst nawet przy szybkim przełączaniu między projektami.

    Terminal i workflow pod maską

    Terminal i workflow pod maską

    Chociaż interfejs terminala nie przeszedł wizualnej metamorfozy, kilka mikroudogodnień poprawia codzienną pracę. Szybsze renderowanie list zasobów MCP, płynniejsze przewijanie dłuższych odpowiedzi oraz eliminacja drobnych błędów przy zmianie rozmiaru okna — te detale w sumie tworzą mniej irytujące doświadczenie.

    Wewnętrzne przepływy pracy również zostały ulepszone. Qwen-Code lepiej radzi sobie z kolejkowaniem zadań, gdy agent wykonuje wiele operacji równolegle, co zmniejsza ryzyko blokowania się zadań oczekujących na ten sam zasób.

    Kontekst i co dalej

    To wydanie wpisuje się w szerszy wzorzec rozwoju Qwen-Code: projekt nie zwalnia tempa, a kolejne wersje nocne i preview pokazują, że zespół intensywnie pracuje nad warstwą serwerową, kanałami komunikacji i integracją z workflow. Wersja v0.19.1 jest krokiem stabilizacyjnym przed większymi zmianami, które już pojawiają się w nightly buildach — m.in. wizualizacja dynamicznych przebiegów workflow czy nowy protokół nawigacji między turami sesji.

    Dla zespołów korzystających z Qwen-Code jako codziennego asystenta w kodowaniu, to wydanie jest istotne głównie ze względu na poprawki bezpieczeństwa i stabilniejsze działanie MCP. Nie wymaga migracji konfiguracji ani uczenia się nowych komend — wystarczy standardowa aktualizacja, aby uzyskać stabilniejsze środowisko pracy.


    Źródła

  • Claude Code 2.1.186 – uwierzytelnianie MCP przez SSH i filtrowanie workflowów

    Claude Code 2.1.186 – uwierzytelnianie MCP przez SSH i filtrowanie workflowów

    Anthropic wypuściło wersję 2.1.186 Claude Code, która upraszcza logowanie do serwerów MCP w środowiskach bez przeglądarki oraz wprowadza filtrowanie statusów w widoku /workflows. Aktualizacja jest skierowana głównie do deweloperów pracujących zdalnie przez SSH oraz tych, którzy zarządzają równoległymi zadaniami agentowymi.

    Kluczowe zmiany w skrócie

    • Uwierzytelnianie MCP z poziomu CLI – nowe komendy claude mcp login <name> i claude mcp logout <name> umożliwiają logowanie do serwerów MCP bez otwierania interaktywnego menu /mcp.
    • Wsparcie dla --no-browser przez SSH – flaga wypisuje URL autoryzacyjny zamiast próbować otworzyć lokalną przeglądarkę, a token przechwytuje w terminalu.
    • Filtrowanie workflow po statusie – w widoku /workflows wystarczy wcisnąć f, aby zawęzić listę zadań agentowych według ich stanu.
    • Automatyczne odpowiedzi dla poleceń bash – opcja ! bash auto-responds przyspiesza wykonywanie skryptów bez ręcznego potwierdzania.
    • Poprawki stabilności – naprawiono błędy zapytań strumieniowych po wybudzeniu maszyny ze snu oraz problemy z podsumowaniami zadań w tle.

    MCP bez przeglądarki – wygodnie przez SSH

    Jednym z głównych problemów pracy z MCP na zdalnych serwerach było dotychczasowe uwierzytelnianie. Aby skonfigurować serwer, konieczne było otwarcie interaktywnego menu /mcp, co na maszynie dostępnej tylko przez terminal było niewygodne. Wersja 2.1.186 rozwiązuje ten problem: claude mcp login <name> uruchamia proces logowania bezpośrednio z linii poleceń.

    Pracując przez SSH, można dodać flagę --no-browser. Claude Code wypisuje wtedy URL autoryzacyjny – wystarczy go skopiować, zalogować się w dowolnej przeglądarce, a kod przekierowania wkleić z powrotem w terminalu. Nie ma potrzeby stosowania X-forwarding ani tunelowania portów.

    Wylogowanie działa podobnie przez claude mcp logout <name>. Dla zespołów DevOps i osób stawiających środowiska CI to znacząca oszczędność czasu, szczególnie gdy serwerów MCP jest kilka i trzeba je rotować między sesjami.

    Zarządzanie workflowami – mniej scrollowania, więcej kontroli

    Claude Code staje się coraz bardziej narzędziem do orkiestracji agentów, a nie tylko pojedynczej sesji czatu. Dowodem jest filtrowanie statusów w widoku /workflows. Gdy uruchamiasz kilka równoległych zadań – na przykład jedno testuje endpointy API, drugie aktualizuje dokumentację, a trzecie refaktoruje komponent – lista szybko staje się nieczytelna.

    Wciśnięcie f pozwala zawęzić widok tylko do aktywnych, zakończonych lub oczekujących workflow. To niewielka zmiana, ale przy pięciu czy sześciu współbieżnych agentach ma znaczenie. Nie trzeba już przewijać całej historii, aby sprawdzić, które zadanie utknęło.

    iTerm2 i automatyczne odpowiedzi – detale, które ułatwiają życie

    Użytkownicy terminali macOS docenią lepszą integrację trybu teammate z iTerm2. Claude Code wspiera teraz jawne dzielenie paneli przez iterm2, korzystając z CLI it2 oraz Python API iTerm2. To eliminuje konieczność przesiadania się na tmux tylko po to, aby mieć agenta w sąsiednim oknie.

    Dodatkowo automatyczne odpowiedzi dla poleceń bash (! bash auto-responds) zmniejszają potrzebę ciągłego potwierdzania przy rutynowych skryptach. Opcja ta jest świadoma kontekstu – nie chodzi o ślepe akceptowanie wszystkiego, ale o zmniejszenie tarcia przy powtarzalnych operacjach.

    Stabilność po usypianiu i zadania w tle

    Każdy, kto pracuje na laptopie, zna ten moment: zamykasz klapę na przerwę, otwierasz po godzinie, a Claude Code nie może wznowić zapytań strumieniowych. Wersja 2.1.186 naprawia ten błąd – streaming wraca do działania bez konieczności restartu sesji.

    Poprawiono również obsługę podsumowań zadań w tle. Wcześniej zdarzało się, że podsumowanie zadań w tle traciło kontekst po dłuższym działaniu agenta – teraz jest to obsługiwane pewniej, co ma znaczenie przy wielogodzinnych sesjach kodowania.

    Co to oznacza dla web deweloperów i zespołów DevOps

    Anthropic przygotowuje Claude Code do pracy zdalnej i headless. Nowy flow logowania MCP, filtrowanie workflow oraz stabilność po usypianiu to oznaki, że narzędzie przestaje być wyłącznie interaktywnym asystentem terminalowym, a staje się częścią bardziej zaawansowanych pipeline'ów developerskich.

    Dla web deweloperów pracujących na zdalnych VPS-ach, administratorów kontenerów oraz każdego, kto zarządza środowiskami przez SSH, ta aktualizacja to konkretne ułatwienie. W miarę jak kolejne wydania coraz mocniej akcentują tryb bezgłowy i współpracę agentów, warto obserwować, w którą stronę Claude Code się rozwija.


    Źródła

  • OpenCode ujarzmia agentów – lepsza kontrola kroków, nowe warianty GLM-5.2 i szybsze cache’owanie promptów

    OpenCode ujarzmia agentów – lepsza kontrola kroków, nowe warianty GLM-5.2 i szybsze cache’owanie promptów

    Najnowsza aktualizacja OpenCode (v1.17.9) wprowadza zmiany w zachowaniu agentów AI oraz rozszerza obsługę modeli, co ma na celu częstsze kończenie zadań konkretną odpowiedzią, zamiast ich przerywania. Główne zmiany dotyczą zarządzania krokami agenta, konfiguracji providerów oraz mechanizmów cache’owania, co ma uczynić pracę z kodem bardziej przewidywalną.

    Co nowego – kluczowe fakty

    • Agent kończy zadanie finalną odpowiedzią tekstową, co redukuje frustrujące, niedokończone sesje.
    • GLM-5.2 zyskuje nowe warianty myślenia: high i max, umożliwiające głębszą analizę tam, gdzie to potrzebne.
    • Nagłówki providerów są teraz traktowane bez rozróżniania wielkości liter, a ustawienia łączą się warstwowo – od providera, przez model, po wariant.
    • Cache promptów działa skuteczniej, ponieważ follow-upy użytkownika nie są już opakowywane w zbędny steering reminder.
    • Subagent w tle uruchomi się tylko na serwerach wspierających sesje potomne, co eliminuje ciche błędy.

    Koniec z niedokończonymi zadaniami

    Zmiana, którą odczuje każdy, kto regularnie zleca agentowi dłuższe zadania, dotyczy sposobu finalizowania kroków. Wcześniej agent mógł utknąć w połowie skomplikowanej operacji – brak odpowiedzi, timeout lub cichy błąd. Teraz OpenCode wymusza zakończenie zadania finalną odpowiedzią tekstową. W przypadku problemów użytkownik otrzymuje komunikat, a nie pusty ekran.

    Dla zespołów pracujących w trybie vibe coding lub zlecających agentowi dziesiątki zadań dziennie, ta poprawka oszczędza godziny debugowania. Mniej przerwanych sesji to także mniejsze zużycie tokenów – agent nie próbuje bez końca kontynuować tego, co już się rozjechało.

    W release note’ach widnieje zapis, że “stop wrapping follow-up user messages in a steering reminder so prompt caching stays effective”. Oznacza to, że wiadomości follow-up nie są już sztucznie rozdmuchiwane, co sprawia, że cache promptów działa efektywniej, a odpowiedzi wracają szybciej.

    GLM-5.2 dostaje tryby myślenia – high i max

    GLM-5.2 dostaje tryby myślenia – high i max

    Drugą istotną nowością jest wsparcie dla wariantów high i max w modelu GLM-5.2. Wybór poziomu “myślenia” pozwala dostosować głębokość analizy do zadania. Jeśli potrzebujesz szybkiej odpowiedzi, pozostajesz przy standardzie. Gdy pracujesz nad architekturą lub skomplikowanym refaktorem, przełączasz na max.

    OpenCode zintegrował teraz ustawienia providera, modelu i wariantu w jedną spójną konfigurację. Dokumentacja modeli informuje, że najpierw aplikowane są wartości providera, potem modelu, a na końcu wybranego wariantu. Dla użytkowników własnych providerów (np. przez Helicone czy Cloudflare AI Gateway) to koniec z ręcznym doklejaniem nagłówków w kilku miejscach.

    Nagłówki i detekcja modeli bez zbędnego tarcia

    Nagłówki i detekcja modeli bez zbędnego tarcia

    Dla tych, którzy korzystają z niestandardowych providerów LLM, ważna jest zmiana w obsłudze nagłówków. OpenCode traktuje nazwy nagłówków bez rozróżniania wielkości liter i przepuszcza je przez konfigurację providera. Jeśli używasz zewnętrznej warstwy obserwowalności czy cache’owania (np. Helicone), nagłówki śledzące i cache’owe przechodzą bezproblemowo.

    Trwają także prace nad automatyczną detekcją modeli przez endpoint /v1/models. Dla providerów, którzy udostępniają tę ścieżkę, OpenCode sam wyciągnie listę dostępnych modeli, co eliminuje potrzebę ręcznej konfiguracji. Mniej konfiguracji na start to mniej okazji do błędów.

    Skrót do subagenta w tle (subagent: true w komendach) został ograniczony tylko do serwerów, które faktycznie wspierają wykonywanie sesji potomnych. Wcześniej próba użycia tej funkcji na niekompatybilnym serwerze kończyła się cichym błędem – teraz OpenCode po prostu nie pozwoli jej wywołać.

    Dla kogo to ma znaczenie

    Jeśli pracujesz z agentami AI na co dzień – w terminalu, IDE czy desktopie – ta aktualizacja przekłada się na mniej przerw, szybsze odpowiedzi i czytelniejsze komunikaty. Dotyczy to zwłaszcza web developmentu i vibe codingu, gdzie agenci działają niemal non-stop, a każda minuta przestoju kosztuje. Zmiany w cache’owaniu promptów mają również wymiar finansowy – skuteczniejszy cache to mniej zbędnych zapytań do API.

    Najnowsza wersja OpenCode to przede wszystkim poprawki pod maską. Nie wprowadza rewolucyjnych zmian w UI, ale oferuje wiele usprawnień, które sprawiają, że narzędzie działa bardziej przewidywalnie. W pracy z kodem przewidywalność jest kluczowa.


    Źródła

  • Claude Code 2.1.185: cichsza komunikacja z API i mniej fałszywych alarmów

    Claude Code 2.1.185: cichsza komunikacja z API i mniej fałszywych alarmów

    Anthropic wprowadziło 20 czerwca 2026 roku wersję 2.1.185 Claude Code, która wprowadza dwie istotne zmiany w systemie powiadomień dotyczących oczekiwania na odpowiedź API. Aktualizacja koncentruje się na komunikacie wyświetlanym podczas stream-stall, czyli sytuacji, gdy strumień danych z API na dłużej przestaje działać.

    • Claude Code 2.1.185 zmienia treść komunikatu o przeciągnięciu strumienia z „No response from API · Retrying in …” na „Waiting for API response · will retry in …”
    • Próg czasowy wyświetlenia ostrzeżenia zwiększono z 10 do 20 sekund ciszy ze strony API
    • Krótkie opóźnienia sieciowe lub po stronie dostawcy rzadziej będą teraz wywoływać komunikat, co ogranicza szum w terminalu
    • Zmiana dotyczy wyłącznie warstwy UX i obserwowalności — nie wpływa na działanie modelu ani mechanizm ponawiania zapytań

    Komunikat, który nie straszy

    Poprzednia wersja komunikatu — „No response from API · Retrying in …” — sugerowała, że wystąpił problem. Dla dewelopera w trakcie sesji kodowania taki tekst mógł wyglądać jak zapowiedź błędu, podczas gdy klient po prostu czekał na odpowiedź. Nowa treść lepiej oddaje rzeczywistość: klient oczekuje na dane, a ponowienie próby nastąpi, jeśli cisza się przedłuży. Choć to drobna zmiana, w narzędziu używanym przez wiele godzin dziennie takie szczegóły mają znaczenie.

    Zespół Anthropic nie zmienił mechanizmu retry — chodzi wyłącznie o to, co widzi użytkownik. Dla osób pracujących w web devie, przy automatyzacji DevOps czy w sesjach vibe codingowych oznacza to mniej fałszywych sygnałów, że sesja „wisi”.

    Dlaczego 20 sekund ma znaczenie

    Podniesienie progu z 10 do 20 sekund to odpowiedź na realia infrastruktury API. Krótkie przestoje — spowodowane chwilowym obciążeniem providera, routingiem sieciowym czy restartem usługi — zdarzają się regularnie i zwykle trwają kilka sekund. Przy 10 sekundach próg był na tyle niski, że wiele takich incydentów wywoływało ostrzeżenie. Teraz większość z nich przejdzie niezauważona.

    W praktyce oznacza to, że terminal nie będzie już co chwilę wyświetlał komunikatu o braku odpowiedzi podczas normalnych, krótkotrwałych fluktuacji latency. Deweloperzy korzystający z Claude Code w złożonych pipeline’ach — gdzie odpowiedzi API przychodzą przez kilka warstw pośrednich — powinni odczuć różnicę niemal natychmiast.

    Kontekst i wcześniejsze problemy ze stream-stall

    Problemy z przeciągającymi się odpowiedziami nie są nowe. W raportach z początku 2026 roku użytkownicy opisywali przypadki zamrożenia strumienia — długie przerwy między kolejnymi zdarzeniami, które potrafiły zakłócić rytm pracy. Wprowadzenie czytelniejszego wskaźnika było odpowiedzią na konkretne sygnały ze społeczności. Wersja 2.1.185 nie rozwiązuje samych przyczyn stallowania (to leży po stronie infrastruktury API), ale sprawia, że informowanie o tym stanie jest precyzyjniejsze i mniej inwazyjne.

    Co ciekawe, w changelogu Claude Code zmiana figuruje jako zwykła pozycja „Update”, bez osobnej sekcji czy rozbudowanego opisu. To podkreśla jej charakter — nie jest to przełom funkcjonalny, a przemyślane szlifowanie detalu.

    Znaczenie dla różnych grup użytkowników

    Dla frontendowców i full-stack deweloperów, którzy często pracują z Claude Code w trybie interaktywnym, kluczowa jest przewidywalność interfejsu. Każdy niepotrzebny alert w terminalu rozprasza. Nowy próg czasowy i poprawiony komunikat sprawiają, że narzędzie zachowuje się bardziej „dorośle” — sygnalizuje problem dopiero wtedy, gdy faktycznie może on wymagać uwagi.

    W kontekście DevOps i zautomatyzowanych workflow, gdzie Claude Code działa jako element większego łańcucha (np. w połączeniu z Cursor, Windsurf czy narzędziami CLI), rzadsze ostrzeżenia zmniejszają ryzyko, że skrypt nadrzędny błędnie zinterpretuje komunikat jako twardy błąd i przerwie przetwarzanie.

    Co dalej

    Anthropic nie zapowiedziało kolejnych zmian w tym obszarze, ale kierunek jest jasny: narzędzie ma być coraz lepiej dostosowane do rzeczywistych warunków sieciowych, w jakich pracują deweloperzy. Wersja 2.1.185 wpisuje się w szerszy trend — kolejne buildy Claude Code z czerwca i lipca 2026 roku przynoszą dziesiątki poprawek związanych z niezawodnością, proxy, timeoutami i obsługą błędów. Stream-stall to tylko jeden z wielu elementów tej układanki, ale jego poprawa pokazuje, że Anthropic reaguje na feedback z terminali.


    Źródła

  • Devin Desktop w wersji 3.2.19 łata błąd wczytywania plików umiejętności

    Devin Desktop w wersji 3.2.19 łata błąd wczytywania plików umiejętności

    Zespół Devin wydał 18 czerwca 2026 roku aktualizację swojego desktopowego edytora. Wersja 3.2.19 to niewielkie wydanie serwisowe, które koncentruje się na jednej poprawce — usunięciu błędu związane z wczytywaniem plików umiejętności korzystających z alternatywnych pól. Mimo ograniczonego zakresu zmian, łatka jest istotna dla wszystkich, którzy definiują własne zadania agentowe w środowisku desktopowym.

    Najważniejsze informacje

    • Data wydania: 18 czerwca 2026 roku — wersja 3.2.19
    • Główna poprawka: naprawiono błąd wczytywania plików umiejętności wykorzystujących alternatywne pola
    • Seria 3.2: kontynuacja dopracowywania desktopowej wersji Devin Desktop i ulepszeń Devin Local
    • Zalecenie: użytkownicy powinni zaktualizować aplikację do najnowszej wersji

    Co dokładnie poprawiono

    Problem dotyczył mechanizmu wczytywania plików umiejętności, które definiują zadania, jakie agent AI wykonuje w ramach zautomatyzowanych przepływów pracy. Gdy plik korzystał z alternatywnych pól, system nie potrafił go poprawnie przetworzyć. W praktyce oznaczało to, że niektóre niestandardowe konfiguracje nie działały zgodnie z oczekiwaniami.

    „Naprawiono błąd wczytywania plików umiejętności, które korzystają z alternatywnych pól” — informuje oficjalny dziennik zmian. To techniczna notka, ale dla programistów pracujących z agentowymi narzędziami AI taka poprawka przekłada się na niezawodność codziennej pracy.

    Seria 3.2 jako całość jest opisana przez twórców jako „ulepszenia Devin Local i kontynuacja dopracowywania Devin Desktop”. Nie wprowadzono nowych funkcji ani spektakularnych możliwości. To solidna praca u podstaw — usuwanie drobnych usterek, które w dłuższej perspektywie wpływają na stabilność narzędzia.

    Znaczenie dla web developerów i zespołów DevOps

    Dla osób pracujących z agentami AI w codziennym developmentcie niezawodność wczytywania plików konfiguracyjnych jest kluczowa. Pliki umiejętności definiują, co agent ma robić — od prostych zadań automatyzacyjnych po złożone przepływy pracy obejmujące testowanie, deployment czy analizę kodu.

    Gdy definicja nie ładuje się poprawnie, agent może wykonać niepełne zadanie albo w ogóle odmówić działania. W środowiskach, gdzie automatyzacja napędza ciągłą integrację i dostarczanie, każda taka awaria to strata czasu i potencjalne ryzyko dla jakości kodu.

    Wydanie 3.2.19 wpisuje się w szerszy kontekst dojrzewania narzędzi do vibe codingu. Coraz więcej zespołów eksperymentuje z agentami AI jako asystentami programistycznymi, a stabilność tych narzędzi staje się warunkiem ich produkcyjnego wykorzystania. Deweloperzy nie chcą się zastanawiać, czy ich plik konfiguracyjny zostanie poprawnie odczytany — chcą, żeby po prostu działał.

    Kontekst całej serii 3.2

    Warto spojrzeć na tę aktualizację w szerszym kontekście. Seria 3.2 to etap, w którym twórcy Devina skupili się na szlifowaniu doświadczeń lokalnych. Devin Local — możliwość uruchamiania agentów bezpośrednio na maszynie dewelopera — to funkcja, która odróżnia to narzędzie od rozwiązań czysto chmurowych.

    Lokalne przetwarzanie daje większą kontrolę nad danymi, krótszy czas reakcji i możliwość pracy offline. Wymaga jednak solidniejszego kodu po stronie desktopowej aplikacji. Każda łatka z serii 3.2 przybliża Devin Desktop do poziomu niezawodności, którego oczekują profesjonalni użytkownicy.

    Aktualizacja jest dostępna do pobrania z oficjalnych kanałów dystrybucji. Zespół zaleca instalację najnowszej wersji wszystkim użytkownikom — nie tylko tym, którzy bezpośrednio zetknęli się z opisanym błędem. Standardowa praktyka w świecie developmentu mówi jasno: łatki stabilności warto aplikować od razu, nawet jeśli problem dotyczy tylko określonych konfiguracji.


    Źródła

  • Codex 0.140.0: wreszcie widać, ile tokenów płonie, a sesje można bezpiecznie usuwać

    Codex 0.140.0: wreszcie widać, ile tokenów płonie, a sesje można bezpiecznie usuwać

    OpenAI wydało wersję 0.140.0 Codex, która wprowadza nowe funkcje, takie jak śledzenie zużycia tokenów w terminalu, trwałe usuwanie sesji oraz możliwość importowania konfiguracji z Claude Code. Ta aktualizacja zmienia codzienną pracę z agentowym kodowaniem — teraz można łatwo monitorować koszty na ekranie, a także skutecznie zarządzać wątkami. Dodatkowo, wprowadzono zarządzane uwierzytelnianie Amazon Bedrock oraz kilka poprawek, które poprawiają wydajność przy dużych repozytoriach.

    Kluczowe zmiany w skrócie

    • Komenda /usage pokazuje dzienne, tygodniowe i skumulowane zużycie tokenów bez potrzeby przechodzenia do panelu administracyjnego.
    • Trwałe usuwanie sesji przez codex delete <thread_id>, /delete lub API app-servera, z zabezpieczeniem przed przypadkowym usunięciem i automatycznym czyszczeniem subagentów.
    • Import z Claude Code (/import) przenosi ustawienia, konfigurację projektu i ostatnie rozmowy, co ułatwia migrację między narzędziami.
    • Amazon Bedrock zyskał zarządzane klucze API, a dane logowania CLI i MCP są teraz przechowywane w szyfrowanym magazynie lokalnym.
    • Optymalizacje dla dużych repozytoriów oraz poprawki odzyskiwania baz SQLite — mniej awarii przy pracy z rozbudowanymi codebasami.

    /usage — koniec zgadywania kosztów

    Najważniejsza zmiana to wbudowane analizy użycia. Dotychczas sprawdzenie, ile tokenów wykorzystano w sesji Codex, wymagało logowania się do zewnętrznego dashboardu. Teraz wystarczy wpisać /usage w terminalu, aby natychmiast zobaczyć aktywność dzienną, tygodniową oraz skumulowaną. Dla zespołów pracujących na limitach kredytowych to istotne narzędzie, które pozwala kontrolować budżet bez przerywania pracy.

    Dane są dostępne w tym samym interfejsie TUI, w którym piszesz kod i rozmawiasz z agentem. Nie ma potrzeby przełączania się do przeglądarki ani pamiętania o sprawdzaniu raportów po fakcie. Dla osób, które doświadczyły nieprzyjemnych rachunków po intensywnej sesji z Codex, to znacząca zmiana.

    To jedna z funkcji, które powinny były pojawić się wcześniej, ale lepiej późno niż wcale — szczególnie że wersja 0.140.0 robi to dobrze, z podziałem na modele i produkty.

    Sesje, których naprawdę już nie ma

    Kolejną istotną zmianą jest zarządzanie sesjami. Wcześniej usunięcie wątku nie zawsze oznaczało jego całkowite zniknięcie — pozostawały ślady w app-serverze, subagenty mogły wisieć w tle, a lokalne metadane mogły przetrwać restart. Teraz codex delete działa skutecznie: czyści zarówno lokalnie, jak i zdalnie, z potwierdzeniem przed wykonaniem oraz automatycznym sprzątaniem subagentów.

    To ważne dla osób pracujących z wrażliwymi danymi lub tych, którzy nie chcą mieć setek martwych wątków w historii. W projektach komercyjnych, gdzie kod źródłowy bywa objęty NDA, możliwość trwałego usunięcia całej ścieżki rozmowy z agentem AI jest wymogiem bezpieczeństwa. Dodatkowo, łatwiej się odnaleźć, gdy lista sesji jest uporządkowana.

    Import z Claude Code i szyfrowane dane logowania

    Import z Claude Code i szyfrowane dane logowania

    Ciekawym dodatkiem jest /import, który przenosi wybrane elementy z Claude Code — ustawienia, konfigurację projektu i historię ostatnich czatów. To krok w stronę użytkowników rozważających przesiadkę między platformami agentowego kodowania. Zamiast konfigurować wszystko od nowa, można przejąć to, co już działało.

    Wersja 0.140.0 poprawia również bezpieczeństwo danych logowania. Tokeny OAuth dla CLI i MCP są teraz przechowywane w szyfrowanym magazynie lokalnym lub systemowym keychainie, zamiast w plikach JSON w formacie plaintext. Dla środowisk enterprise i hostowanych workflow AI to korzystna zmiana — szczególnie w połączeniu z nowym, zarządzanym uwierzytelnianiem Amazon Bedrock, które rozszerza obsługiwane przepływy autoryzacji.

    Wydajność i stabilność przy dużym kodzie

    Wydajność i stabilność przy dużym kodzie

    Poprawki wydajnościowe dla dużych repozytoriów to coś, co doceni każdy, kto próbował uruchomić Codex w monorepo. Wersja 0.140.0 wprowadza optymalizacje związane z cache'owaniem oraz szybsze działanie przy rozbudowanych codebasach. Dodatkowo, poprawiono odzyskiwanie baz SQLite — jeśli baza uległa uszkodzeniu, Codex nie powinien już ulegać awarii bez wyjaśnienia.

    Zwiększono również niezawodność MCP (Model Context Protocol), czyli mechanizmu łączącego Codex z zewnętrznymi narzędziami i pluginami. Mniej losowych rozłączeń, stabilniejsze podtrzymywanie kontekstu oraz ogólnie mniej frustracji przy zautomatyzowanych przepływach pracy.

    Narzędzie, które dorasta

    Wersja 0.140.0 to nie rewolucja, ale solidny krok w stronę produkcyjnej dojrzałości. Codex przestaje być wyłącznie agentem do generowania kodu i staje się pełniejszym narzędziem deweloperskim: z widocznością kosztów, kontrolą nad cyklem życia sesji oraz sensownym importem konkurencyjnych konfiguracji.


    Źródła

  • Zed 1.7.2 wprowadza automatyczne odchudzanie kontekstu agenta AI i usprawnienia pracy z Git

    Zed 1.7.2 wprowadza automatyczne odchudzanie kontekstu agenta AI i usprawnienia pracy z Git

    Zed doczekał się nowej aktualizacji oznaczonej numerem 1.7.2, która została wydana na stabilnym kanale 17 czerwca 2026 roku. Edytor od zespołu Zed Industries koncentruje się na dwóch głównych obszarach: poprawie wydajności agentów sztucznej inteligencji oraz usprawnieniu obsługi repozytoriów Git. Wśród wielu poprawek wyróżniają się nowa komenda /compact oraz rozszerzone możliwości wykonywania własnych poleceń na gałęziach.

    Co nowego – kluczowe fakty

    • Automatyczne odchudzanie kontekstu zapobiega zapychaniu się limitu tokenów podczas długich sesji z agentem AI, a wszystko można również wywołać ręcznie przez /compact.
    • Wsparcie dla niestandardowych poleceń Git obejmuje gałęzie i tagi widoczne na grafie, co ułatwia pracę z wieloma worktree.
    • Odświeżony podgląd Markdown jest czystszy i bardziej czytelny – mniej wizualnego szumu przy dokumentacji.
    • Poprawki na macOS 27 beta eliminują opóźnienia kliknięć w kontrolkach paska tytułu na testowej wersji systemu.
    • Usunięto wsparcie dla 32-bitowych architektur w rozszerzeniach pobierających serwery językowe, debugery i serwery MCP.

    Agent AI bez zatykania limitu tokenów

    Dłuższe rozmowy z asystentem AI w edytorze mogą prowadzić do problemów, gdy kontekst zbliża się do limitu modelu. Zed 1.7.2 wprowadza automatyczne odchudzanie kontekstu, które działa w tle: starsze wiadomości asystenta są podsumowywane, a zwolnione miejsce pozwala kontynuować pracę bez konieczności restartowania rozmowy.

    Użytkownicy mogą również ręcznie kontrolować ten proces za pomocą komendy /compact. Wystarczy wpisać ją w interfejsie agenta, aby natychmiast skondensować dotychczasową historię. Z dyskusji na GitHubie wynika, że model otrzymuje skrót wcześniejszych interakcji, co pozwala na nowe zapytania bez blokad.

    Dla osób pracujących w nurcie vibe codingu to ważna zmiana. Sesje potrafią trwać godzinami, a limit tokenów często kończy się w najmniej oczekiwanym momencie. Automatyczne i ręczne odchudzanie kontekstu to praktyczne rozwiązanie.

    Git zyskuje elastyczność

    Git zyskuje elastyczność

    Druga istotna część aktualizacji dotyczy integracji z Gitem. Zed dodał możliwość uruchamiania własnych poleceń bezpośrednio na referencjach – gałęziach i tagach – widocznych na grafie. Do tej pory użytkownicy musieli korzystać z terminala, teraz mogą podpiąć skrypt lub alias do konkretnej gałęzi i uruchomić go bez opuszczania edytora.

    Równocześnie poprawiono zarządzanie worktree. Choć oficjalne notki nie podają szczegółów technicznych, zmiany mają na celu stabilniejszą nawigację między różnymi kopiami roboczymi repozytorium. Dla zespołów pracujących z wieloma równoległymi gałęziami, co jest powszechne w web developmencie, każda minuta zaoszczędzona na przełączaniu się ma znaczenie.

    Podgląd Markdown i drobne poprawki

    Podgląd Markdown i drobne poprawki

    Nie samym AI człowiek żyje. Odświeżony podgląd Markdown zyskał czystszy wygląd, co docenią wszyscy piszący dokumentację bezpośrednio w edytorze. Wprowadzono również mniej oczywiste zmiany.

    Na macOS 27 beta – testowej wersji systemu – naprawiono opóźnienia kliknięć w kontrolkach paska tytułu. Zniknął problem znikających konfliktów w dyfie projektu podczas edycji. Na Linuksie poprawiono renderowanie tła prompta, a ustawienie experimental.auto_microphone_volume zostało usunięte, ponieważ głośność mikrofonu jest teraz normalizowana domyślnie.

    Wsparcie dla 32-bitowych architektur w rozszerzeniach pobierających serwery językowe, debugery i serwery MCP zostało usunięte. To logiczny krok, ponieważ edytor zmierza w stronę nowoczesnych środowisk, a utrzymywanie wstecznej kompatybilności staje się niepraktyczne.

    Dlaczego to ma znaczenie

    Zed 1.7.2 nie przynosi rewolucyjnych zmian, co można uznać za pozytywne. To aktualizacja, która rozwiązuje problemy związane z długimi sesjami AI i rozszerza funkcjonalność Gita, która powinna działać od dawna. Komenda /compact będzie przydatna dla każdego, kto testuje agentowe przepływy pracy. Usprawnienia w Git będą korzystne dla zespołów pracujących z rozbudowanymi repozytoriami. Edytor staje się również szybszy i bardziej stabilny, co znacząco poprawia codzienną pracę.


    Źródła

  • Factory otwiera się na npm – nowe wsparcie dla pluginów i zabezpieczenia sesji w wersji v0.150.0

    Factory otwiera się na npm – nowe wsparcie dla pluginów i zabezpieczenia sesji w wersji v0.150.0

    Najnowsza aktualizacja Factory (v0.150.0) wprowadza wsparcie dla pluginów publikowanych jako pakiety npm. Do tej pory rozszerzenia można było dystrybuować na kilka sposobów, ale teraz dołącza do nich najpopularniejszy rejestr ekosystemu JavaScript. Zmiana jest istotna, ponieważ npm to domyślne źródło zależności dla wielu zespołów developerskich. Dodatkowo, zespół Factory wprowadził mechanizm potwierdzenia przy zamykaniu aktywnych sesji Droid, poprawki wydajności dla długich czatów oraz lepszą widoczność statusu rozliczeniowego.

    Kluczowe informacje o aktualizacji

    • npm jako źródło pluginów – w definicji marketplace’u można teraz wskazać pakiet npm wraz z opcjonalną wersją, rejestrem i tokenem do prywatnych repozytoriów.
    • Bezpieczna instalacja z wyłączonymi skryptami – Droid pobiera pluginy przez npm install z flagami --ignore-scripts --no-save --no-audit --no-fund, a kod jest kopiowany do cache’u; żaden skrypt cyklu życia się nie uruchamia.
    • Potwierdzenie przed zamknięciem – nowy monit zapobiega przypadkowemu przerwaniu pracy Droid, gdy sesja jest w toku.
    • Optymalizacja długich czatów – poprawki wydajnościowe zmniejszają opóźnienia przy rozbudowanych workflow, gdzie kontekst rośnie z każdą turą.
    • Czytelniejszy status rozliczeniowy – użytkownicy widzą teraz stan konta wyraźniej podczas korzystania z narzędzia.

    Jak działa nowe źródło pluginów

    Factory definiuje plugin przez wpis w pliku marketplace. Nowa składnia dla źródła npm jest prosta. Deweloper podaje nazwę pakietu (obsługiwane są też pakiety z zakresem, np. @firma/nazwa), opcjonalną wersję zgodną z semver lub dist-tagiem oraz – jeśli plugin znajduje się w prywatnym rejestrze – adres URL rejestru HTTPS i nazwę zmiennej środowiskowej z tokenem.

    Brak wersji oznacza, że Droid automatycznie pobierze najnowszą oznaczoną jako latest. Dla zespołów korporacyjnych to wygodne rozwiązanie – nie trzeba budować obejść, aby podłączyć prywatne repozytorium. Wystarczy podać registry i authTokenEnvVar, a Factory respektuje te ustawienia bez grzebania w globalnej konfiguracji npm.

    Zespół Factory zadbał o bezpieczeństwo – Droid wykonuje npm install w tymczasowym katalogu roboczym, a następnie kopiuje rozpakowany pakiet do cache’a. Wszystkie skrypty cyklu życia są blokowane, co oznacza, że nie uruchamiają się preinstall, install ani postinstall. W ostatnich latach ataki na łańcuch dostaw przez npm stały się powszechne – złośliwe pakiety wykorzystywały instalacyjne skrypty do kradzieży tokenów czy eksfiltracji sekretów CI/CD. GitHub ogłosił, że w npm v12 domyślnie wyłączy automatyczne wykonywanie tych skryptów. Factory podąża tą samą drogą.

    Sesje pod ochroną

    Nowy monit potwierdzenia przed zamknięciem może wydawać się drobiazgiem, ale każdy, kto przypadkowo przerwał agentowi pracę nad złożonym zadaniem, wie, jak irytujące to może być. Droid potrafi wykonywać wieloetapowe operacje: klonuje repozytoria, modyfikuje pliki, odpytuje API. Przypadkowe wciśnięcie Ctrl+C mogło zostawić projekt w niedokończonym stanie. Teraz Factory pyta, czy na pewno chcesz wyjść, gdy sesja jest aktywna. To drobna zmiana, która oszczędza nerwy.

    Dodatkowo poprawiono wydajność długich rozmów z Droidem. W rozbudowanych workflow, gdzie kontekst rośnie z każdą kolejną turą, mniejsze opóźnienia oznaczają płynniejszą pracę. Zespół Factory nie podał szczegółów technicznych, ale efekt jest odczuwalny szczególnie przy sesjach trwających przez wiele interakcji.

    Dlaczego to ma znaczenie

    Rynek narzędzi AI dla developerów staje się coraz bardziej konkurencyjny. Cursor, Windsurf, Cline – każdy szuka swojej niszy. Factory stawia na rozszerzalność. Pluginy to nie tylko komendy i umiejętności, ale też Droidy, hooki i serwery MCP, które można udostępniać między projektami i zespołami. Wsparcie dla npm eliminuje trudności związane z dystrybucją przez mniej standardowe kanały. Dla web developerów i zespołów DevOps oznacza to, że łatwiej będzie budować własne, firmowe rozszerzenia i dzielić się nimi jak z każdą inną zależnością JavaScript. Factory pokazuje, że korzysta z infrastruktury, którą developerzy już znają i której ufają.


    Źródła

  • OpenAI Codex 0.140.0: lepsze zarządzanie sesjami, widoczność tokenów i import z Claude Code

    OpenAI Codex 0.140.0: lepsze zarządzanie sesjami, widoczność tokenów i import z Claude Code

    OpenAI wypuściło wersję 0.140.0 narzędzia OpenAI Codex, wprowadzając kilka istotnych usprawnień dla programistów. Najważniejsze zmiany dotyczą kontroli nad sesjami, śledzenia zużycia tokenów oraz migracji projektów z Claude Code. To wydanie koncentruje się na stabilności i wygodzie użytkownika.

    Kluczowe zmiany w skrócie

    • Śledzenie tokenów – widok dziennego, tygodniowego i skumulowanego zużycia tokenów bezpośrednio w CLI/TUI
    • Trwałe usuwanie sesji – możliwość kasowania wątków po ID oraz polecenia usuwania w trakcie sesji z zabezpieczeniami przed przypadkowym wykonaniem
    • Import z Claude Code – selektywne przenoszenie konfiguracji projektu, czatów i powiązanych artefaktów bez pełnej migracji
    • Uwierzytelnianie Amazon Bedrock – zarządzane klucze API z szyfrowanym lokalnym przechowywaniem poświadczeń OAuth
    • Ujednolicone menu wzmianek – jeden interfejs do wstawiania plików i wtyczek

    Kontrola nad sesjami i kosztami

    Do tej pory użytkownicy OpenAI Codex mieli ograniczony wgląd w zużycie tokenów. Wersja 0.140.0 wprowadza polecenie /usage, które pokazuje aktywność tokenową w podziale na dni, tygodnie i okresy skumulowane. Dla zespołów pracujących w środowiskach produkcyjnych to oszczędność czasu, eliminująca potrzebę przeskakiwania do zewnętrznych paneli w celu sprawdzenia kosztów.

    Drugą istotną zmianą jest trwałe usuwanie sesji. Wcześniej wątki mogły zalegać na serwerach bez wyraźnej opcji ich usunięcia. Teraz dostępne są polecenia codex delete, /delete oraz thread/delete po stronie app-servera. Każda operacja wymaga potwierdzenia, co zmniejsza ryzyko przypadkowej utraty danych. To szczególnie przydatne w przypadku wrażliwych projektów oraz porządkowania przestrzeni roboczej po dłuższych sesjach.

    Przeprowadzka z Claude Code bezboleśnie

    Nowością jest polecenie /import, które umożliwia selektywne przenoszenie elementów z Claude Code. Użytkownicy mogą wybrać, co chcą przenieść, w tym konfigurację projektu, ustawienia na poziomie użytkownika, ostatnie czaty oraz powiązane artefakty.

    To podejście ułatwia życie deweloperom korzystającym z obu narzędzi, eliminując konieczność ręcznego odtwarzania ustawień oraz utraty kontekstu rozmów z agentem. OpenAI udostępnia również ścieżkę przez wtyczkę Claude Code, co pozwala na kontynuowanie sesji między ekosystemami. Firma stawia na interoperacyjność, co jest korzystne dla użytkowników.

    Amazon Bedrock i bezpieczeństwo poświadczeń

    W nowej wersji dodano wsparcie dla zarządzanego uwierzytelniania Amazon Bedrock. Poświadczenia OAuth, zarówno dla CLI, jak i MCP, są teraz przechowywane lokalnie w formie szyfrowanej. Dla zespołów korzystających z modeli przez AWS to rozszerza możliwości wdrożeniowe, nie rezygnując z bezpieczeństwa.

    Warto również zauważyć poprawki stabilności. SQLite, wykorzystywane przez OpenAI Codex do lokalnego przechowywania stanu, otrzymało aktualizacje eliminujące błędy przy dłuższych sesjach. Dodatkowo, poprawiono niezawodność MCP, co zmniejsza liczbę awarii przy integracji narzędzi i agentów, co ma znaczenie podczas długich sesji developerskich.

    Ujednolicenie interfejsu

    Menu wzmianek (@) zostało scalone w jeden mechanizm dla plików i wtyczek. Użytkownicy wpisując @, widzą wszystkie opcje w jednym miejscu, co oszczędza czas podczas przełączania się między kontekstami.

    Co to oznacza dla web developerów

    Dla programistów pracujących w paradygmacie szybkiego prototypowania aplikacji webowych, zmiany w wersji 0.140.0 przekładają się na mniejsze przestoje i większą kontrolę. Lepsza ciągłość sesji, szyfrowane poświadczenia oraz selektywny import z konkurencyjnego narzędzia sprawiają, że OpenAI Codex staje się bardziej elastyczny w środowiskach, gdzie liczy się każda minuta.

    Zespół OpenAI inwestuje w bezpieczniejszy obieg danych uwierzytelniających oraz bardziej przewidywalny cykl życia sesji. Dla deweloperów pracujących na współdzielonych maszynach lub w środowiskach hostowanych, te zmiany realnie zmniejszają ryzyko wycieku danych i ułatwiają zarządzanie projektami rozłożonymi na wiele sesji.


    Źródła