Kategoria: Technologie

  • Claude Code nie podnosi limitów na stałe, ale propozycje zmian są na stole

    Claude Code nie podnosi limitów na stałe, ale propozycje zmian są na stole

    Anthropic nie ogłosił ani nie wdrożył planów dotyczących stałej podwyżki tygodniowych limitów w Claude Code o 50% do 13 lipca. Obecne doniesienia są prawdopodobnie wynikiem pomieszania dwóch wątków: zakończonych promocji czasowych oraz trwających dyskusji i żądań społeczności deweloperskiej. W tej chwili podstawowe limity pozostają bez zmian.

    Kluczowe fakty

    • Podwójny limit tylko tymczasowo: W marcu 2026 Anthropic zaoferował wszystkim użytkownikom, od wersji darmowej do płatnej, podwojenie limitów poza godzinami szczytu, ale akcja trwała tylko od 13 do 27 marca.
    • Żądania społeczności: Część użytkowników zgłasza na platformach takich jak GitHub postulat wprowadzenia stałego wzrostu limitów o minimum 50%, proponując nową strukturę abonamentów lub płatne boosty.
    • Obecny system limitów: Dzisiejsze restrykcje w Claude Code działają w modelu dwuwarstwowym: pięciogodzinne okno szybkiego dostępu oraz tygodniowy pułap "aktywnych godzin obliczeniowych", który różni się w zależności od modelu (Sonnet vs. Opus) i typu konta.

    Podczas krótkiej akcji promocyjnej w marcu użytkownicy mogli korzystać z podwójnych limitów, ale wyłącznie w wyznaczonych porach – w tygodniu między 5:00 a 11:00 czasu PT (czyli 14:00-20:00 czasu polskiego). Bonusowe użycie nie wliczało się przy tym do standardowego tygodniowego limitu, co było atrakcyjnym udogodnieniem, zwłaszcza dla programistów pracujących w innych strefach czasowych. Akcja została wyraźnie oznaczona jako tymczasowy "mały prezent" od Anthropic i zakończyła się zgodnie z planem 27 marca.

    Gdzie pojawia się postulat 50% wzrostu?

    Propozycja stałego zwiększenia limitów o 50% pochodzi bezpośrednio od społeczności. Na GitHubie w ramach repozytorium Claude Code istnieje otwarte zgłoszenie (issue), w którym użytkownicy domagają się rewizji systemu. Ich propozycja zakłada np. zwiększenie liczby dostępnych wiadomości z około 500 do 750 na tydzień dla warstwy Pro.

    Autorzy zgłoszenia sugerują też wprowadzenie nowych, wyższych tierów abonamentowych (np. Team czy Enterprise z dużo większymi limitami) lub opcję dokupienia boostów za dodatkową opłatą. Choć pomysł zyskał pewne poparcie, nie ma żadnych oficjalnych sygnałów od Anthropic, że został przyjęty do realizacji, a tym bardziej że miałby być wdrożony z konkretną datą końcową 13 lipca.

    Jak dziś działają limity w Claude Code?
    Jak dziś działają limity w Claude Code?

    Aby zrozumieć skalę żądań, warto przyjrzeć się obecnym zasadom. System limitów w Claude Code jest dość unikalny. Opiera się na dwóch licznikach: pięciogodzinnym, "rolling window" dla aktywności w krótkich seriach, oraz tygodniowym pułapie tzw. aktywnych godzin obliczeniowych.

    To drugie to czas, w którym Claude faktycznie przetwarza tokeny lub wykonuje kod. Przerwy na przeglądanie plików czy planowanie nie są wliczane. W praktyce oznacza to, że użytkownik warstwy Pro ma do dyspozycji około 40-80 takich aktywnych godzin tygodniowo przy użyciu modelu Sonnet, który jest domyślnym silnikiem dla Claude Code. Dostęp do potężniejszego modelu Opus jest w tym planie mocno ograniczony. Przekroczenie któregokolwiek z limitów blokuje możliwość wysyłania nowych promptów do momentu, aż licznik się zresetuje.

    Podsumowanie

    Choć plotki o znacznym i stałym zwiększeniu limitów w Claude Code okazują się nieprawdziwe, zapotrzebowanie na takie zmiany jest bardzo realne. Tymczasowa promocja z marca pokazała, że Anthropic jest gotowe testować elastyczność swojego systemu, a głosy z community jasno wskazują kierunek oczekiwań. Deweloperzy muszą optymalizować swoją pracę w ramach istniejących zasad, korzystając z krótszych sesji kodowania i planując bardziej wymagające zadania poza godzinami szczytu. Wszelkie przyszłe zmiany w limitach zależą od wewnętrznych decyzji Anthropic i będą ogłaszane przez oficjalne kanały komunikacji firmy.
  • Obniżka o 50% na GPT-5.5 w Windsurf i Devin — promocja potrwa do 14 maja

    Obniżka o 50% na GPT-5.5 w Windsurf i Devin — promocja potrwa do 14 maja

    Do 14 maja 2026 roku użytkownicy narzędzi programistycznych Windsurf i Devin mogą korzystać z modelu GPT-5.5 od OpenAI z 50% zniżką. Ta promocja ma na celu zaprezentowanie możliwości nowej technologii szerszemu gronu deweloperów. Obniżka dotyczy zarówno użycia modelu w edytorze Windsurf, jak i kosztów działania autonomicznego agenta w Devin.

    Windsurf i Devin współpracują z OpenAI, aby wprowadzić tymczasową redukcję cen. Model GPT-5.5 jest dostępny w obu produktach od ich premiery, ale teraz, przez ograniczony czas, jego cena jest znacznie niższa. To nie jest darmowy okres próbny, lecz rzeczywista obniżka stawek, która pozwala na oszczędności i testowanie modelu w codziennych zadaniach.

    Kluczowe fakty promocji

    • Okres obowiązywania: Promocyjne ceny obowiązują do 14 maja 2026 roku.
    • Zasięg oferty: Dotyczy użycia GPT-5.5 w środowisku deweloperskim Windsurf oraz w agencie Devin.
    • Mechanizm rabatu: W Windsurf model pobiera środki z puli użytkownika i nalicza opłaty za przekroczenia z 50% zniżką.
    • Wydajność w Devin: Agent w Devin, napędzany GPT-5.5, ma wykonywać prawie dwa razy więcej pracy za każdego wydanego dolara.
    • Dostępność modelu: GPT-5.5 był obecny w obu produktach od ich startu; promocja obniża jedynie jego cenę.

    Dlaczego GPT-5.5 to zmiana jakościowa?

    Promocja ma na celu nie tylko oszczędności, ale także pokazanie, jak GPT-5.5 poprawia asystencję programistyczną. W Windsurf model ten radzi sobie z niejednoznacznością na nowym poziomie, rozumiejąc intencje programisty, nawet gdy instrukcje są nieprecyzyjne. Potrafi rozłożyć skomplikowane problemy na prostsze kroki i wykonać zadania przy minimalnej liczbie dodatkowych pytań.

    Redukcja konieczności „przeciągania liny” z asystentem prowadzi do wzrostu produktywności. Programista może sformułować szerszy cel, a model samodzielnie podzieli go na logiczne kroki i zrealizuje. Nie wymaga już szczegółowego opisu każdego detalu, co przyspiesza pracę nad refaktoryzacją, pisaniem testów czy implementacją nowych funkcji.

    Devin z GPT-5.5: autonomiczny agent na sterydach

    Devin z GPT-5.5: autonomiczny agent na sterydach

    W Devin GPT-5.5 ujawnia swój potencjał jako samodzielny wykonawca. Model ten pozwala agentowi w Devin działać dłużej i z większą autonomią niż wcześniejsze wersje GPT. W praktyce przekłada się to na skuteczne rozwiązywanie trudnych zadań, z którymi inne modele nie radzą sobie.

    Na przykład, GPT-5.5 potrafi odnajdywać subtelne błędy, które umykają innym narzędziom. Model nie tylko diagnozuje problemy, ale także przeprowadza kompleksowe dochodzenie – od analizy logów po identyfikację przyczyny w kodzie – i wdraża końcową poprawkę. To oferta kompleksowego badania i naprawy problemów produkcyjnych, co dla wielu zespołów może oznaczać znaczną oszczędność czasu.

    Podsumowanie okazji

    Promocja na GPT-5.5 w Windsurf i Devin to wyjątkowa okazja, by przetestować zaawansowane możliwości AI w codziennej pracy deweloperskiej, z mniejszymi kosztami. Dla użytkowników Windsurf oznacza to realną obniżkę opłat za korzystanie z modelu. Dla osób korzystających z Devin jest to szansa na sprawdzenie agenta, który wykonuje niemal dwukrotnie więcej zadań.

    Do 14 maja warto zbadać, jak model radzący sobie z niejednoznacznością i pracujący z większą autonomią może zmienić proces programowania. To nie tylko test technologii, ale także inwestycja w sprawdzenie, jak osiągnięcia OpenAI mogą przyspieszyć i usprawnić rzeczywiste projekty.

  • Cursor wprowadza interaktywne wizualizacje Canvases

    Cursor wprowadza interaktywne wizualizacje Canvases

    Cursor, który zaktualizowano 16 kwietnia 2026 roku, wprowadza nowy sposób interakcji z asystentami AI. Zamiast tradycyjnych odpowiedzi tekstowych, agenci mogą teraz generować interaktywne wizualizacje i pulpity nawigacyjne, określane jako Canvases. Te trwałe artefakty są dostępne w panelu Agents Window, co daje programistom bardziej intuicyjny i efektywny sposób wizualizacji danych związanych z kodem.

    Nowa funkcja opiera się na bibliotece komponentów zbudowanej na React, która obejmuje tabele, diagramy, wykresy oraz istniejące komponenty Cursora, takie jak porównania diff czy listy zadań. Dzięki temu agent może stworzyć dedykowany interfejs dostosowany do konkretnego zadania – od analizy incydentu po przegląd kodu – co znacząco zwiększa przepustowość informacji między człowiekiem a AI. W tej samej aktualizacji wprowadzono również nowy, kafelkowy układ panelu agentów, poprawioną dokładność wprowadzania głosowego oraz ulepszoną obsługę gałęzi dla agentów w chmurze.

    Kluczowe fakty o Canvases

    • Interaktywne artefakty: Canvases to trwałe, interaktywne wizualizacje (np. dashboards, diagramy), które agent tworzy w odpowiedzi na zapytanie i które są na stałe osadzone w panelu bocznym Agents Window, obok terminala i przeglądarki.
    • Koniec z „ścianami tekstu”: Funkcja zastępuje trudne do przyswojenia, tekstowe zestawienia danych – jak tabele w markdown – bezpośrednimi, wizualnymi reprezentacjami, które można eksplorować i z którymi można wchodzić w interakcje.
    • Realny wpływ na pracę: Zespół Cursora użył Canvases do analizy wdrożeń modeli AI, co pozwoliło na skrócenie czasu rozwiązywania problemów podczas ostatnich dwóch wdrożeń. Zamiast budować osobną aplikację, stworzyli Skill, który generuje interaktywny interfejs analityczny.
    • Rozszerzalność przez Marketplace: Możliwość tworzenia Canvases jest rozszerzalna. Dzięki rynkowi pluginów (Marketplace) użytkownicy mogą dodawać nowe umiejętności, takie jak Docs Canvas Skill do generowania interaktywnych diagramów architektury repozytorium.
    • Wsparcie dla wielu scenariuszy: Agenci wykorzystują Canvases do przeglądu PR-ów (grupując zmiany według ważności), tworzenia dashboardów do analizy incydentów z danymi z Datadog czy Sentry, a także do wizualizacji postępu w automatycznych eksperymentach.

    Jak Canvases zmieniają współpracę z AI

    Główną zaletą Canvases jest odejście od linearnej, tekstowej komunikacji. W zadaniach intensywnie korzystających z danych, takich jak analiza logów czy przegląd rozległych zmian w kodzie, tradycyjne wyjście agenta było często nieczytelne. Teraz agent może skonsolidować dane z wielu źródeł w jeden, interaktywny wykres lub stworzyć logicznie pogrupowany interfejs do przeglądu pull requesta.

    Te wizualizacje są dynamiczne. To żywe interfejsy, które wykorzystują komponenty React, co oznacza, że mogą zawierać niestandardową logikę, umożliwiać filtrowanie, sortowanie czy drill-down w danych. Interaktywność wyróżnia Canvases na tle tradycyjnych zrzutów obrazka czy kodu HTML.

    Praktyczne zastosowania w pracy developera

    Zespół Cursora podaje kilka przykładów z własnej praktyki. Podczas analizy wyników ewaluacji modeli inżynierowie musieli kiedyś ręcznie przeglądać setki ID requestów, szukając wzorców błędów. Dzięki stworzeniu dedykowanego Skilla, agent teraz samodzielnie czyta dane z wdrożeń, kategoryzuje przyczyny porażek i buduje canvas z interaktywnym interfejsem do śledzenia klastrów błędów, co oszczędza godziny manualnej pracy.

    Inny przykład to przegląd dużych pull requestów. Zamiast wrzucać wszystkie zmiany w diffie jednolitym ciągiem, agent używa Canvases, by logicznie pogrupować modyfikacje, podkreślić te najważniejsze z punktu widzenia bezpieczeństwa czy architektury, a dla skomplikowanych algorytmów może nawet wygenerować ich pseudokodową reprezentację. To nowe, bardziej analityczne podejście do code review.

    Rozszerzalność i przyszłość funkcji

    Rozszerzalność i przyszłość funkcji

    Canvases nie są zamkniętą funkcją. Ich siła leży w rozszerzalności przez Cursor Marketplace. Już teraz dostępny jest plugin Docs Canvas Skill, który uczy agenta, jak generować interaktywny diagram architektury całego repozytorium, łącząc notatki, referencje API i przewodniki w nawigowalnym układzie.

    Możliwość pisania własnych Skills oznacza, że zespoły mogą tworzyć specjalizowane Canvases dostosowane do swoich unikalnych workflow’ów – do monitorowania wskaźników biznesowych, wizualizacji zależności między mikroserwisami, czy zarządzania zadaniami w projektach. To otwiera drogę do głębokiej personalizacji narzędzia.

    Więcej niż tylko wizualizacje

    Wprowadzenie Canvases to część szerszej wizji twórców Cursora, której celem jest zwiększenie przepustowości informacji między programistą a asystentem AI. Inne niedawne funkcje, jak tryb projektowania (Design Mode) czy ulepszone wprowadzanie głosowe, wspierają ten cel. Chodzi o usunięcie barier w komunikacji i danie użytkownikowi więcej sposobów wyrażania intencji niż tylko tekst.

    Canvases to nie tylko estetyczny dodatek. To istotna zmiana w interfejsie i filozofii współpracy.


    Źródła

  • Aktualizacja platformy Claude: stare modele w deprecjacji, migracja do nowszych wersji

    Aktualizacja platformy Claude: stare modele w deprecjacji, migracja do nowszych wersji

    Anthropic ogłosił planowane wycofanie modeli Claude Sonnet oraz Claude Opus, które przestaną działać 15 czerwca 2026 roku. Ta decyzja była oczekiwana przez społeczność deweloperów, którzy obserwowali szybki rozwój modeli Claude. Już 14 kwietnia 2026 roku firma oznaczyła te wersje jako przestarzałe, co sugerowało długi okres przejściowy. Teraz nadszedł czas na konkretne kroki migracyjne – twórcy aplikacji powinni przejść na nowsze wersje: Claude Sonnet oraz Claude Opus.

    W szybko rozwijającym się świecie sztucznej inteligencji zarządzanie cyklem życia API staje się kluczową umiejętnością. Wycofywanie starszych wersji to standardowa praktyka w branży, która pozwala firmom skupić się na wsparciu i rozwoju najnowszych modeli. W przypadku Anthropic ponad roczny okres na migrację daje deweloperom więcej czasu niż oferują niektórzy konkurenci, co jest korzystne dla użytkowników.

    Kluczowe fakty dotyczące zmian

    • Claude Sonnet i Opus (o ID claude-sonnet-20250514 i claude-opus-20250514) mają status deprecjacji, a ich działanie zakończy się 15 czerwca 2026 roku.
    • Rekomendowane modele docelowe to Claude Sonnet (o ID claude-sonnet) oraz Claude Opus (o ID claude-opus).
    • Migracja w Claude Code jest ułatwiona dzięki możliwości wyboru modelu z rozwijanej listy i jego zmiany w dowolnym momencie.
    • Nowy model flagowy Claude Opus został udostępniony 16 kwietnia 2026 roku, oferując zaawansowane możliwości agentowego kodowania.

    Dlaczego modele są wycofywane?

    Cykl życia modeli AI przyspiesza wraz z postępem technologicznym. Starsze wersje, takie jak Sonnet czy Opus, opierają się na architekturze i danych treningowych sprzed ponad roku. W tym czasie Anthropic poprawił wydajność, zmniejszył koszty tokenów oraz wprowadził kluczowe funkcje bezpieczeństwa i nowe możliwości, takie jak rozszerzone okna kontekstu czy lepsze wsparcie dla narzędzi.

    Wycofanie starych modeli pozwala firmie skoncentrować zasoby inżynieryjne i obliczeniowe na utrzymaniu i rozwoju najnowszych wersji. To również ważne z punktu widzenia bezpieczeństwa – zapewnienie, że wszyscy użytkownicy korzystają z modeli z najnowszymi zabezpieczeniami przed jailbreakami czy wyciekami promptów. Długi okres przejściowy daje firmom czas na przetestowanie nowych wersji, zaktualizowanie integracji i przeprowadzenie wewnętrznych audytów.

    Jak przebiega migracja w praktyce?

    Jak przebiega migracja w praktyce?

    Dokumentacja platformy Claude sugeruje, że proces przejścia na nowsze modele został zaprojektowany tak, aby był jak najmniej skomplikowany. Podstawowym mechanizmem jest zmiana parametru model w wywołaniach API. Deweloperzy korzystający z Claude Code mogą po prostu wybrać nowy model z listy dostępnych w interfejsie. W przypadku własnych integracji API, aktualizacja często sprowadza się do zmiany jednej linijki kodu, choć warto pamiętać o potencjalnych różnicach w zachowaniu modeli.

    Szczególnie ważne jest dokładne przetestowanie aplikacji po zmianie modelu. Nawet jeśli nowsze wersje są z założenia lepsze, mogą różnić się w formatowaniu odpowiedzi, długości generowanych tekstów czy interpretacji niektórych promptów. Anthropic zaleca zapoznanie się z oficjalnym przewodnikiem migracyjnym, który szczegółowo opisuje zmiany pomiędzy wersjami, w tym potencjalnie łamiące zmiany w API, które pojawiły się wraz z Claude Opus.

    Co zyskujemy na nowszych modelach?

    Co zyskujemy na nowszych modelach?

    Przejście na Claude Sonnet czy Claude Opus to nie tylko kwestia uniknięcia przerw w działaniu. To przede wszystkim dostęp do zauważalnie ulepszonych możliwości. Nowe modele oferują lepsze zrozumienie kontekstu, wydajniejsze przetwarzanie zadań wymagających rozbudowanego rozumowania oraz wsparcie dla nowych funkcji, takich jak adaptive thinking czy structured outputs.

    Claude Opus, najnowszy flagowy model, wprowadza dodatkowo nowy tokenizer i ulepszenia w generowaniu kodu agentowego. Pomimo tych udoskonaleń, ceny za przetworzenie tokenów pozostają konkurencyjne. To istotna informacja dla firm kalkulujących koszty operacyjne – migracja nie musi wiązać się z automatycznym wzrostem opłat.

    Podsumowanie i dalsze kroki

    Choć termin ostatecznego wyłączenia starszych modeli wydaje się odległy, warto rozpocząć planowanie migracji już teraz. Proaktywne podejście pozwoli uniknąć ostatniej chwili przed czerwcem 2026 roku i da czas na dogłębne przetestowanie aplikacji na nowych wersjach. Pierwszym krokiem powinno być zapoznanie się z oficjalną dokumentacją deprecjacyjną Anthropic oraz przewodnikami migracyjnymi dostępnymi na platformie.

    Deweloperzy mogą już teraz przetestować swoje aplikacje z modelami Claude Sonnet i Claude Opus w środowiskach stagingowych. Warto również rozważyć skorzystanie z nowych funkcji dostępnych w najnowszych modelach, które mogą przyczynić się do ulepszenia aplikacji.


    Źródła

  • Kimi Code CLI 1.33.0 ujednolica interfejs i rozbudowuje funkcje sesji web

    Kimi Code CLI 1.33.0 ujednolica interfejs i rozbudowuje funkcje sesji web

    Kimi Code CLI w wersji 1.33.0 wprowadza znaczące usprawnienia wizualne i funkcjonalne, skupiając się na bardziej przejrzystym interfejsie dla programistów oraz nowymi możliwościami zarządzania sesjami w przeglądarce. Kluczową zmianą jest ujednolicenie wyświetlania modelu AI jako „Kimi for Code” w terminalu, co eliminuje wcześniejsze, mylące odniesienia. Aktualizacja ta wpisuje się w szerszy kontekst rozwoju narzędzia, oferując programistom bardziej spójne i efektywne narzędzie do pracy w terminalu.

    Klucze zmiany w wersji 1.33.0

    • Ujednolicenie tożsamości modelu: W powłoce i ekranie powitalnym zastąpiono wszystkie twardo zakodowane odwołania do wcześniejszych oznaczeń modelu spójnym oznaczeniem „Kimi for Code”. To uproszczenie interfejsu ukrywa przed użytkownikiem wewnętrzne szczegóły wersjonowania.
    • Nowa funkcja w sesjach web: Dodano możliwość forkowania sesji z poziomu interfejsu webowego. Użytkownik może teraz stworzyć nową sesję, rozpoczynając od dowolnego asystenta w istniejącej sesji, co ułatwia eksperymentowanie z różnymi ścieżkami konwersacji.
    • Poprawki stabilności: Wprowadzono poprawkę dotyczącą podświetlania różnic (inline diff) w wierszach zawierających znaki tabulacji, co zapewnia ich prawidłowe wyrównanie.

    Ta wersja narzędzia koncentruje się na doświadczeniu użytkownika. Usunięcie starych nazw modeli z interfejsu redukuje szum informacyjny, pozwalając deweloperom skupić się na zadaniach, a nie na technicznych detalach backendu. Funkcja forkowania sesji web odpowiada na potrzebę elastyczności podczas pracy z asystentami AI, umożliwiając testowanie alternatywnych rozwiązań bez utraty kontekstu oryginalnej rozmowy.

    Kontekst narzędzia i integracja z modelami Moonshot AI

    Kimi Code CLI to interaktywny agent AI działający w terminalu, zaprojektowany do automatyzacji zadań programistycznych, operacji shellowych i zarządzania przepływem pracy. Obsługuje tryb powłoki, integrację z wtyczką Zsh, protokół ACP dla IDE oraz konfigurację narzędzi MCP. Jego wydajność jest ściśle powiązana z możliwościami modeli językowych Moonshot AI.

    Aktualizacja CLI wpisuje się w ciągły rozwój flagowych modeli Moonshot AI, które oferują rozszerzone możliwości kluczowe dla pracy w terminalu, takie jak obsługa długiego kontekstu, zaawansowane mechanizmy wnioskowania oraz możliwość współpracy wielu agentów. Dzięki integracji z CLI, deweloperzy mogą wykorzystywać te możliwości przy generowaniu kodu czy tworzeniu pełnych serwisów internetowych.

    Dlaczego te zmiany mają znaczenie dla programistów

    Dlaczego te zmiany mają znaczenie dla programistów

    Uproszczenie interfejsu w 1.33.0 to nie tylko kosmetyka. W środowiskach deweloperskich, gdzie czas i koncentracja są kluczowe, każda niepotrzebna informacja w terminalu może być dystraktorem. Zastąpienie wewnętrznych oznaczeń modelu jednolitą marką „Kimi for Code” sprawia, że narzędzie jest bardziej intuicyjne, zwłaszcza dla nowych użytkowników.

    Funkcja forkowania sesji web to praktyczne udogodnienie dla zaawansowanych workflow'ów. Na przykład, podczas debugowania złożonego błędu, asystent może proponować jedną ścieżkę naprawy, ale użytkownik może chcieć sprawdzić alternatywne podejście. Zamiast zaczynać nową sesję od zera i ponownie opisywać problem, można rozgałęzić istniejącą rozmowę. To narzędzie wspiera iteracyjny rozwój i eksplorację różnych rozwiązań programistycznych bez utraty stanu.

    Te udoskonalenia, choć mogą wydawać się drobne, składają się na większą całość: płynniejsze, mniej inwazyjne doświadczenie z AI w terminalu. Celem jest, aby asystent był produktywnym partnerem, który nie przeszkadza, a jego interfejs „znika” w tle, pozwalając deweloperowi skupić się na pisaniu kodu.

    Podsumowanie

    Wydanie Kimi Code CLI 1.33.0 to kolejny krok w ewolucji narzędzia w kierunku większej dojrzałości i użyteczności. Ujednolicenie interfejsu oraz dodanie funkcji forkowania sesji odpowiada na realne potrzeby społeczności deweloperskiej. Zmiany te wzmacniają pozycję CLI jako konkurencyjnego rozwiązania do AI-augmented development w terminalu, szczególnie atrakcyjnego dla zespołów pracujących nad rozbudowanymi projektami.


    Źródła

  • Kimi Code CLI 1.33.0: Ujednolicona marka i oczyszczona powłoka

    Kimi Code CLI 1.33.0: Ujednolicona marka i oczyszczona powłoka

    Kimi Code CLI, open-source'owy asystent AI działający z poziomu terminala, wydał wersję 1.33.0. Aktualizacja, która miała miejsce 13 kwietnia 2026 roku, koncentruje się na poprawie interfejsu użytkownika oraz ujednoliceniu wizerunku marki, a także na stabilności i obsłudze narzędzi MCP. Najważniejszą zmianą jest zastąpienie dotychczasowych nazw modeli ogólnym oznaczeniem "Kimi for Code" oraz usunięcie sztywnych odniesień do wersji.

    Celem tej zmiany jest zapewnienie użytkownikom bardziej spójnego wrażenia podczas korzystania z narzędzia. Zamiast technicznych identyfikatorów, takich jak kimi-k2.5, które mogły sugerować zależność od konkretnej wersji backendu, interfejs teraz prezentuje jednolitą markę. Refaktoryzacja została przeprowadzona w ramach pull requesta #1860, zgłoszonego przez kontrybutora @RealKai42. Dodatkowo, z ekranu powitalnego oraz podpowiedzi po komendzie /login usunięto informacje o wersji, co upraszcza komunikację. Wewnętrzne podbicie wersji do 1.33.0 zostało zarejestrowane w osobnym PR #1861.

    Kluczowe zmiany w wersji 1.33.0

    Aktualizacja, choć niewielka, precyzyjnie adresuje kwestie spójności wizualnej:

    • Ujednolicona prezentacja modeli: Wszystkie modele AI są teraz wyświetlane w powłoce pod marką "Kimi for Code". Eliminuje to potencjalne zamieszanie i podkreśla ogólny charakter narzędzia, niezależnie od aktualnie używanego backendu.
    • Oczyszczony interfejs: Usunięto zapisane ciągi znaków z numerami wersji (np. kimi-k2.5) z ekranu powitalnego oraz podpowiedzi logowania. Dzięki temu interfejs jest bardziej minimalistyczny i skupia się na funkcjonalności.
    • Dopracowanie po wcześniejszych stabilizacjach: Ta aktualizacja wpisuje się w ciąg poprzednich ulepszeń, które koncentrowały się na lepszym zarządzaniu wynikami narzędzi MCP (Model Client Protocol) oraz na poprawie stabilności wersji CLI. Pokazuje to podejście twórców, którzy najpierw wzmacniają rdzeń, a następnie poprawiają doświadczenia użytkownika.
    • Kim jest Kimi Code CLI i dlaczego to ważne?

    Kimi Code CLI to potężny, open-source'owy agent CLI od MoonshotAI, zaprojektowany z myślą o web development, AI coding oraz dev ops. Jego siła leży w integracji z terminalem, co umożliwia płynną, wspomaganą sztuczną inteligencją pracę nad kodem bez konieczności opuszczania konsoli. Narzędzie oferuje tryb powłoki (shell-mode) dla wykonywania asystowanych poleceń, integrację z wtyczką Zsh, wsparcie dla ACP (Agent Client Protocol) do łączenia się z IDE oraz konfigurację narzędzi MCP do komunikacji z zewnętrznymi serwisami.

    Na jego możliwości składają się również: obsługa wielu agentów jednocześnie, edycja wielu plików, automatyczne uruchamianie testów, system piaskownic i uprawnień, wejście multimodalne (obraz, głos) oraz instalacja Pythona przez uv. Wydanie Kimi Code CLI 1.33.0 zbiegło się z premierą modelu Kimi K2.6 (13 kwietnia 2026), który oferuje 256K okno kontekstowe, obsługę do 100 agentów jednocześnie (tzw. swarms) i wyniki na poziomie ~77% w teście SWE-Bench Verified, co czyni go wydajną opcją do pracy z dużymi bazami kodu.

    • Perspektywa dla programistów

    Dla społeczności developerów, zwłaszcza w Polsce, narzędzia takie jak Kimi Code CLI otwierają nowe możliwości. Integracja AI bezpośrednio w terminal oznacza mniejsze obciążenie systemu, szybsze iteracje i możliwość automatyzacji rutynowych zadań bez przełączania kontekstu na inne aplikacje. Dopracowywanie interfejsu, jak w wersji 1.33.0, jest kluczowe dla adopcji – intuicyjne i czyste środowisko zachęca do częstszego używania.

    • Podsumowanie

    Wydanie Kimi Code CLI 1.33.0 może wydawać się drobnym krokiem, ale jest świadomym posunięciem w stronę dojrzałego produktu. Przesunięcie akcentu z technicznego żargonu (kimi-k2.5) na spójną markę użytkownika (Kimi for Code) oraz oczyszczenie interfejsu pokazuje, że twórcy dbają o moc obliczeniową, jak i o wygodę dla końcowego programisty. To solidna podstawa pod dalszy rozwój, zwłaszcza w kontekście równoległej premiery modelu K2.6.


    Źródła

  • Opencode wprowadza kluczowe poprawki OAuth i nowe warianty modeli

    Opencode wprowadza kluczowe poprawki OAuth i nowe warianty modeli

    Ostatnia aktualizacja Opencode koncentruje się na zwiększeniu niezawodności współpracy z agentami AI, poprawiając obsługę interfejsu oraz rozszerzając funkcje API. Wydanie to odpowiada na problemy zgłaszane przez społeczność i stanowi kolejny krok w optymalizacji środowiska deweloperskiego. Wprowadzone zmiany wpływają na użyteczność narzędzia, które zyskuje popularność jako terminalowe środowisko dla asystentów kodujących.

    Kluczowe zmiany w aktualizacji

    • Naprawa regresji motywu systemowego w TUI: Rozwiązano problem z wyświetlaniem motywu systemowego w terminalowym interfejsie użytkownika (TUI), co przywraca spójność wizualną.
    • Dostosowanie wysokości autouzupełniania: Udoskonalono działanie funkcji autouzupełniania, aby lepiej dostosowywała wysokość wyświetlanych sugestii do zawartości.
    • Nowe endpointy HTTP API: Dodano nowe punkty końcowe API HTTP, takie jak GET /config oraz endpointy do sprawdzania statusu serwerów, co poszerza możliwości integracji i automatyzacji.
    • Poprawki importów dla Windows: Usunięto problemy związane z importowaniem modułów w środowisku Windows, co zwiększa stabilność na tej platformie.
    • Ograniczenie wariantów modeli: Wprowadzono zmiany, które ograniczają wyświetlanie wariantów do wybranego modelu, w tym modeli Opencode.

    Dopracowanie interfejsu i ekosystemu rozszerzeń

    Głównym celem tej aktualizacji jest poprawa doświadczeń użytkowników oraz rozszerzenie możliwości integracji. Naprawa regresji motywu systemowego w TUI przywraca oczekiwane, spójne zachowanie interfejsu, które wielu użytkowników preferowało. Dostosowanie logiki autouzupełniania sprawia, że praca z terminalem staje się bardziej płynna i przewidywalna.

    Dodanie nowych endpointów HTTP API, w tym możliwości sprawdzania konfiguracji i statusu serwerów, to ważny krok w kierunku lepszej automatyzacji i integracji z zewnętrznymi narzędziami. Umożliwia to administratorom i zaawansowanym użytkownikom bezpieczniejsze i bardziej elastyczne włączanie Opencode do istniejących przepływów pracy, szczególnie w środowiskach korporacyjnych.

    Poprawki związane z importami na Windowsie oraz zmiany dotyczące wyświetlania wariantów modeli świadczą o dbałości o stabilność i przejrzystość na wszystkich obsługiwanych platformach. Ograniczenie wyświetlanych wariantów do zakresu wybranego modelu pomaga uniknąć nieporozumień i upraszcza proces konfiguracji.

    To wydanie Opencode ilustruje metodyczne podejście do rozwiązywania rzeczywistych problemów użytkowników. Zamiast wprowadzać rewolucyjne nowości, dostarczono zestaw precyzyjnych poprawek, które stabilizują podstawowe funkcje – przewidywalne działanie interfejsu oraz elastyczność integracji. Taki kierunek rozwoju świadczy o dojrzałości projektu, który koncentruje się na niezawodności, będącej fundamentem produktywności w codziennej pracy deweloperskiej.


    Źródła

  • DeepSeek-V4 Preview oficjalnie live i open-sourced

    DeepSeek-V4 Preview oficjalnie live i open-sourced

    DeepSeek AI ogłosiło, że model DeepSeek-V4 będzie dostępny w pierwszym tygodniu marca 2026 roku na licencji open source. Model ten ma oferować kontekst o długości 1 miliona tokenów i będzie konkurować z wiodącymi, zamkniętymi rozwiązaniami. Firma kładzie duży nacisk na wydajność w zadaniach programistycznych oraz efektywność kosztową.

    Kluczowe fakty na początek

    • Planowana premiera: Model DeepSeek-V4 będzie dostępny w pierwszym tygodniu marca 2026 roku na licencji open source, prawdopodobnie MIT.
    • Architektura i skala: To model typu Mixture of Experts z około 1 bilionem parametrów całkowitych i 32 miliardami aktywnych.
    • Niespotykany kontekst: Długość kontekstu wynosi 1 milion tokenów, co umożliwi analizę całych repozytoriów kodu, pełnych śladów stosu czy dużych dokumentów.
    • Dostępność i wydajność: Model będzie dostępny przez API i własne platformy DeepSeek; w oczekiwanych benchmarkach ma dorównywać DeepSeek-V4, choć może nieznacznie ustępować liderom takim jak Gemini 3 Pro.
    • Przeznaczenie dla devów: Model będzie zoptymalizowany pod kątem zadań programistycznych, oferując lepszą skuteczność w niższym koszcie, co jest kluczowe dla web developmentu, AI i DevOps.

    Rewolucja w długim kontekście i architekturze

    Główną cechą tego wydania jest kontekst o długości miliona tokenów. Dla programistów oznacza to możliwość wprowadzenia do modelu całego, nawet dużego projektu, wraz z zależnościami, i poproszenia o analizę, refaktoryzację czy diagnozę skomplikowanego błędu. Architektura Mixture of Experts (MoE) w połączeniu z mechanizmami takimi jak Engram conditional memory pozwala na inteligentne zarządzanie dużą ilością danych, aktywując tylko niezbędne fragmenty sieci neuronowej dla każdego tokenu.

    Dzięki temu, mimo ogromnej liczby parametrów całkowitych (około 1T), faktycznie używanych jest ich znacznie mniej (około 32B), co przekłada się na efektywność kosztową i energetyczną. To istotna informacja dla osób hostujących modele lub intensywnie korzystających z API – według zapewnień DeepSeek, koszt inferencji może być znacznie niższy przy zachowaniu wysokiej jakości odpowiedzi w zadaniach kodowania.

    Benchmarki: twarde dane dla praktyków

    Benchmarki: twarde dane dla praktyków

    Oczekiwane wyniki benchmarków mają potwierdzić, że model nie składa się z pustych obietnic. Na HumanEval, kluczowym teście umiejętności kodowania, DeepSeek-V4 ma osiągać nawet 98%. W matematycznym teście GSM8K wynik może wynieść około 96%. Te obszary – kodowanie i rozumowanie – mają być fundamentem oferty DeepSeek.

    Na szerszym teście MMLU-Pro, DeepSeek-V4 ma dorównywać możliwościom DeepSeek-V4, choć może minimalnie ustępować aktualnym liderom, czyli Gemini 3 Pro i Claude Opus 4.5. Prawdziwy sprawdzian dla "króla kodowania" dopiero przed nami – branża czeka na wyniki w benchmarku SWE-bench, który symuluje złożone zadania z GitHub. Celem DeepSeek jest przebicie wyniku 80.9%, ustalonego przez Claude Opus 4.5.

    Co to znaczy dla programistów i zespołów DevOps?

    Co to znaczy dla programistów i zespołów DevOps?

    Dla społeczności związanej z web developmentem, AI i programowaniem, ta premiera ma konkretne znaczenie. Model z kontekstem 1M tokenów to potencjalne narzędzie do kompleksowej analizy kodu. Można mu przekazać cały stack trace, logi z wielu plików, a nawet zawartość folderu node_modules w poszukiwaniu konfliktów. Dla zespołów DevOps, które budują agentów AI automatyzujących pracę, efektywna architektura MoE oznacza niższe koszty operacyjne i szybsze odpowiedzi.

    Otwartość modelu (open source) jest równie istotna. Oznacza to możliwość uruchomienia DeepSeek-V4 na własnej infrastrukturze, dostosowania pod specyficzne potrzeby firmy czy integracji bez ograniczeń nakładanych przez zamknięte API.

    Podsumowanie

    Premiera DeepSeek-V4 to nie tylko kolejna iteracja w wyścigu modeli językowych. To strategiczny ruch, który stawia na otwartość, długość kontekstu i dominację w zadaniach programistycznych. Firma pokazuje, że można konkurować z gigantami oferującymi zamknięte modele, dostarczając narzędzie równie potężne, ale bardziej ekonomiczne i dające developerom pełną swobodę. Dla każdego, kto zajmuje się kodowaniem, web developmentem czy budowaniem systemów AI, testowanie możliwości DeepSeek-V4, zwłaszcza w analizie dużych projektów, będzie istotne po jego premierze. Era efektywnego, miliona tokenów kontekstu może właśnie nadchodzić.

  • OpenAI wprowadza GPT‑5.5: nowa klasa inteligencji do pracy i agentów

    OpenAI wprowadza GPT‑5.5: nowa klasa inteligencji do pracy i agentów

    OpenAI ogłosiło premierę modelu GPT-5.5, który ma na celu wsparcie w wykonywaniu złożonych zadań oraz zasilanie agentów. Model, dostępny już dla użytkowników ChatGPT, umożliwia realizację wieloetapowych zadań z mniejszą ingerencją człowieka. GPT-5.5 został zaprojektowany do rozumienia skomplikowanych celów, korzystania z narzędzi, weryfikacji własnej pracy oraz finalizacji procesów, takich jak analiza danych, tworzenie dokumentów, arkuszy kalkulacyjnych i obsługa oprogramowania.

    Model poprawia wiarygodność faktów, realizację instrukcji oraz zmniejsza występowanie halucynacji i nadmiernej uległości. W szczególności wyróżnia się w zadaniach związanych z pisaniem, kodowaniem oraz pracą w obszarze zdrowia. Architektura systemu łączy inteligentny model, głębsze rozumienie (nazywane GPT-5.5 thinking) oraz router w czasie rzeczywistym, który dostosowuje ścieżkę przetwarzania w zależności od złożoności zadania.

    Kluczowe informacje o GPT-5.5

    • Nowa klasa agentów: GPT-5.5 to model do "prawdziwej pracy", który potrafi zrozumieć złożone cele, korzystać z narzędzi, weryfikować wyniki i dokończyć zadania, co zmniejsza potrzebę mikro-zarządzania przez użytkownika.
    • Lepsze kodowanie i rozumienie: Model osiąga 82.7% na benchmarku Terminal-Bench 2.0, przewyższając Claude 4.7 i Gemini 3.1 Pro. W testach rozumowania (GPQA) bez użycia narzędzi ustanawia nowy rekord na poziomie 88.4%.
    • Dostępność i warstwy: GPT-5.5 jest dostępny w ChatGPT dla użytkowników planów Plus, Pro, Business i Enterprise. Wersja GPT-5.5 Pro jest zarezerwowana dla wyższych tierów: Pro, Business i Enterprise.

    Wydajność, która przekłada się na rzeczywistą pracę

    OpenAI podkreśla, że GPT-5.5 nie tylko osiąga wysokie wyniki na syntetycznych benchmarkach, ale jest również bardziej użyteczny w praktycznych zastosowaniach. Firma zwraca uwagę na postępy w kluczowych obszarach, takich jak redukcja halucynacji, lepsze podążanie za instrukcjami oraz mniejsza skłonność do nadmiernej uległości.

    W kontekście kodowania, GPT-5.5 jest określany jako najsilniejszy model agentowy OpenAI. Osiąga 58.6% na SWE-Bench Pro, który ocenia zdolność do rozwiązywania rzeczywistych problemów z GitHub. Model osiąga te wyniki, używając mniejszej liczby tokenów niż wcześniejsze wersje, co zwiększa wydajność i obniża koszty.

    Te możliwości oznaczają, że GPT-5.5 może przejąć więcej pracy inżynierskiej – od implementacji i refaktoryzacji po debugowanie, testowanie i walidację. Wczesni testerzy, tacy jak Dan Shipper z Every, zauważyli, że model wykazuje "poważną klarowność konceptualną", potrafiąc diagnozować przyczyny awarii i proponować rozwiązania na poziomie doświadczonego inżyniera.

    Nie tylko kod: praca wiedzowa i naukowa

    Nie tylko kod: praca wiedzowa i naukowa

    Możliwości GPT-5.5 wykraczają poza programowanie. Model osiąga znaczące wyniki w pracy wiedzowej i wczesnych badaniach naukowych. Na benchmarku GDPval, który testuje zdolności agentów w 44 różnych zawodach, GPT-5.5 osiąga 84.9%. Potrafi również operować w rzeczywistych środowiskach komputerowych, co potwierdza wynik 78.7% na OSWorld-Verified.

    W obszarze nauki, GPT-5.5 radzi sobie lepiej w wieloetapowych pętlach badawczych: od eksploracji pomysłu, przez zbieranie dowodów, testowanie założeń, po interpretację wyników. Na nowym benchmarku GeneBench, który koncentruje się na wieloetapowej analizie danych w genetyce, model przewyższa poprzednie wersje.

    Bezpieczeństwo i dostępność

    Bezpieczeństwo i dostępność

    OpenAI zapewnia, że GPT-5.5 został wydany z najsilniejszym zestawem zabezpieczeń do tej pory. Model przeszedł kompleksowe oceny w ramach wewnętrznych systemów bezpieczeństwa, testy red-team z udziałem zewnętrznych ekspertów oraz ukierunkowane oceny zaawansowanych możliwości w cyberbezpieczeństwie i biologii. Przed premierą opinie zebrano od blisko 200 zaufanych partnerów z wczesnego dostępu.

    Wdrożenie jest stopniowe, zaczynając od kont Pro i Enterprise, aby zapewnić stabilność usługi. GPT-5.5 jest już dostępny w interfejsie ChatGPT. Dostęp przez API wymaga dodatkowych zabezpieczeń i, jak zapowiada OpenAI, będzie dostępny wkrótce.

    Podsumowanie

    Premiera GPT-5.5 to nie tylko kolejna wersja modelu językowego, ale także krok OpenAI w kierunku budowy globalnej infrastruktury dla agentowej sztucznej inteligencji. Firma uważa, że podobnie jak AI przyspieszyło inżynierię oprogramowania, tak GPT-5.5 może wpłynąć na badania naukowe i codzienną pracę na komputerze. Z poprawioną faktualnością, głębszym rozumieniem kontekstu i zdolnością do samodzielnego działania w długich łańcuchach zadań, model ten może stać się inteligentnym partnerem w pracy.


    Źródła

  • Anthropic wprowadza narzędzie Advisor: strategiczny doradca dla agentów AI

    Anthropic wprowadza narzędzie Advisor: strategiczny doradca dla agentów AI

    Anthropic udostępniło w publicznej betie nowe narzędzie Advisor na platformie Claude, które ma na celu poprawę działania długoterminowych, autonomicznych agentów AI. Narzędzie łączy szybki model wykonawczy, taki jak Sonnet czy Haiku, z modelem doradczym, jak Opus, oferując strategiczne wskazówki podczas generowania odpowiedzi. Dzięki temu złożone zadania agentów mogą osiągać jakość porównywalną do tej, którą zapewnia Opus, przy znacznie niższych kosztach, ponieważ drogi model doradza tylko w razie potrzeby.

    Kluczowe fakty o Advisor

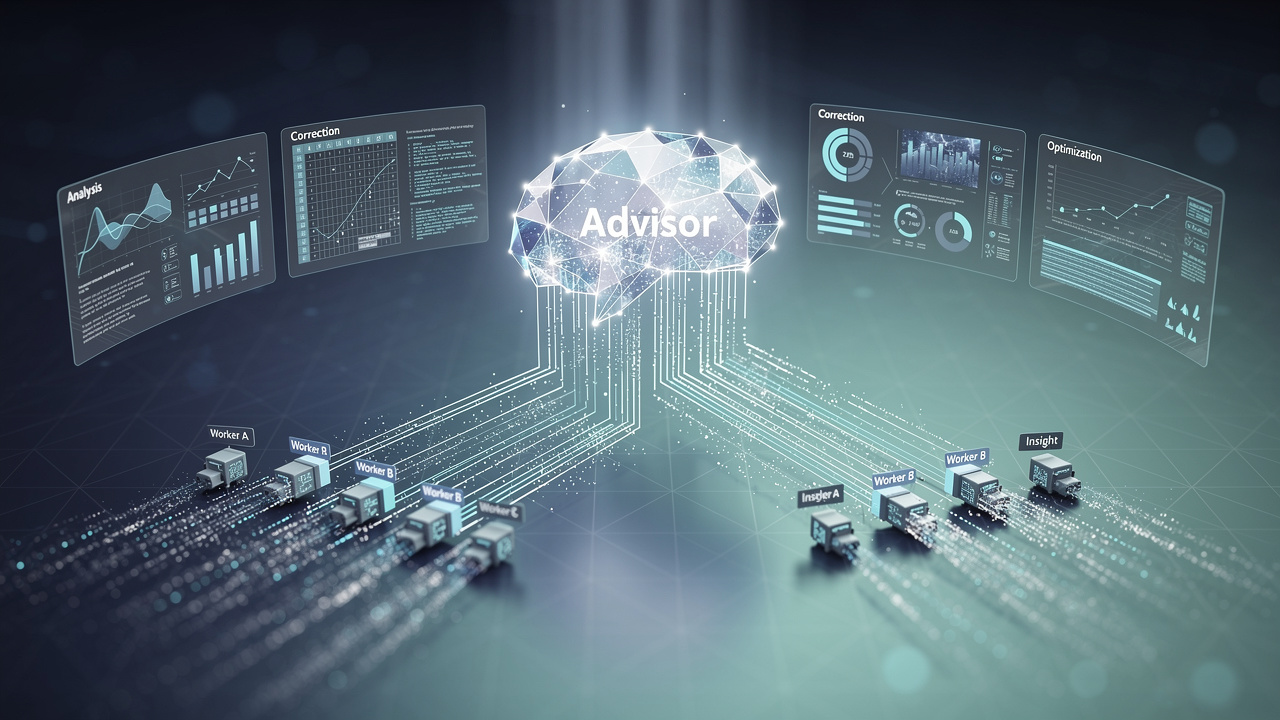
    • Mechanizm działania: Główny, szybki model wykonawczy (worker) współpracuje z modelem doradczym (advisor), który pełni rolę nadzorcy strategicznego. Doradca interweniuje w kluczowych momentach, korygując kierunek działania.
    • Korzyści ekonomiczne: Zapewnia inteligencję na poziomie Opus za ułamek kosztu, ponieważ większość tokenów generuje tańszy model wykonawczy, a droższy doradca jest konsultowany oszczędnie.
    • Integracja z ekosystemem: Narzędzie działa jako server tool na infrastrukturze Anthropic i zostało ogłoszone równolegle z Claude Managed Agents – platformą do budowy i zarządzania agentami w chmurze.
    • Cel zastosowań: Ma na celu rozwiązanie problemu agentów, które "schodzą na złą drogę" podczas długich zadań, co wymaga ręcznych poprawek i generuje dodatkowe koszty. Skupia się na złożonych automatyzacjach biznesowych.
    • Dostępność: Advisor jest dostępne na Claude Platform API. Aby z niego skorzystać, należy dodać odpowiedni nagłówek do żądań API.

    Jak działa nowy mechanizm doradczy?

    Innowacja polega na podziale ról. Wyobraźmy sobie agenta AI, który ma zaplanować i wykonać wieloetapową analizę danych, generując kod i raporty. Tradycyjnie używalibyśmy jednego, potężnego modelu (np. Opus) przez cały czas trwania zadania. Advisor zmienia tę logikę.

    W nowym podejściu codzienna praca spoczywa na szybkim i ekonomicznym modelu wykonawczym, takim jak Claude Sonnet. To on generuje kod, przetwarza dane i pisze wstępne fragmenty. W tle czuwa model Opus w roli doradcy. Gdy wykonawca napotyka punkt decyzyjny, może zwrócić się do doradcy o konsultację. Doradca analizuje sytuację, sugeruje najlepszy kierunek działania, a wykonawca kontynuuje pracę. W efekcie jakość całego procesu jest bliska tej, którą zapewnia Opus, ale koszt jest zbliżony do użycia Sonneta.

    Kontekst szerszej strategii Anthropic: zarządzani agenci

    Kontekst szerszej strategii Anthropic: zarządzani agenci

    Wprowadzenie Advisor jest częścią szerszej strategii Anthropic w obszarze infrastruktury dla agentów AI. Tydzień wcześniej firma ogłosiła publiczną betę Claude Managed Agents.

    To w pełni zarządzane środowisko, które odciąża developerów od infrastruktury. Definiują oni tylko zadanie, narzędzia i zabezpieczenia, a Anthropic zapewnia całą orchestrację: wywołania narzędzi, zarządzanie kontekstem, odzyskiwanie po błędach, bezpieczne sandboxing oraz obsługę wielogodzinnych sesji, które przetrwają nawet rozłączenie. To rozwiązanie ma umożliwić przedsiębiorstwom przejście od prototypu do produkcji w ciągu dni.

    Advisor doskonale wpisuje się w ten ekosystem. Może być używane wewnątrz Managed Agents, dodając im warstwę strategicznego nadzoru. Ceny Managed Agents są oparte na zużyciu: standardowe stawki za tokeny Claude plus opłata za każdą godzinę aktywnej sesji agenta.

    Dla kogo jest to rozwiązanie?

    Dla kogo jest to rozwiązanie?

    Advisor jest skierowane przede wszystkim do developerów i firm budujących zaawansowane automatyzacje, gdzie kluczowa jest niezawodność i redukcja błędów w długich, wieloetapowych procesach. Typowe zastosowania to:

    • Złożona generacja kodu z wieloma zależnościami i wyborami architektonicznymi.
    • Automatyczna analiza biznesowa wymagająca wnioskowania i podejmowania decyzji na podstawie danych.
    • Zaawansowane przetwarzanie dokumentów z potrzebą strategicznego planowania kolejnych kroków.

    Narzędzie odpowiada na realny problem: agenci AI czasami "gubią wątek" w długich zadaniach, co prowadzi do nieprawidłowych wyników, konieczności restartu zadania i marnowania tokenów. Dzięki punktowym interwencjom doradcy ten problem ma być znacząco ograniczony.

    Podsumowanie

    Wprowadzenie Advisor przez Anthropic to odpowiedź na wyzwania związane z ekonomią i niezawodnością agentów AI. Zamiast stawiać developerów przed wyborem: tani i szybki agent lub drogi i mądry, firma proponuje hybrydę. To podejście łączy zalety obu światów. W połączeniu z ofertą Managed Agents, Anthropic pozycjonuje się jako dostawca kompletnych, gotowych do produkcji środowisk dla zaawansowanej automatyzacji opartej na AI. Narzędzie jest już testowane w realnych warunkach, co świadczy o jego praktycznym zastosowaniu.


    Źródła