Tag: google

  • Gemini CLI z nową łatką stabilności – wersja v0.46.0-preview.1 już dostępna

    Gemini CLI z nową łatką stabilności – wersja v0.46.0-preview.1 już dostępna

    Google wypuściło nową wersję preview swojego terminalowego agenta AI – Gemini CLI v0.46.0-preview.1. Ta aktualizacja koncentruje się na usunięciu błędu, który mógł prowadzić do niespójności wersji w środowisku deweloperskim. Poprawka została wydana kilka dni po większym wydaniu v0.46.0-preview, które wprowadziło istotne zmiany w architekturze narzędzia.

    Kluczowe informacje

    • Gemini CLI v0.46.0-preview.1 to łatka naprawcza, która zapewnia spójność wersji i stabilność po poprzednim wydaniu preview.
    • Wersja v0.46.0-preview.1 wprowadziła wzmocnioną obsługę zmiany rozmiaru PTY, eliminującą krytyczne awarie natywne.
    • Naprawiono pętle spamowe w interfejsie CLI, które mogły skutecznie zablokować pracę z narzędziem.
    • Zespół Google zachęca użytkowników kanału preview do natychmiastowej aktualizacji.
    • Gemini CLI to open-source'owy agent AI, który integruje modele Gemini bezpośrednio z terminalem.

    Co konkretnie naprawiono

    Wersja v0.46.0-preview.1 jest odpowiedzią zespołu na problemy zgłaszane przez społeczność. Głównym celem łatki było załatanie luki, która powodowała rozjeżdżanie się numerów wersji między różnymi komponentami narzędzia. W praktyce oznaczało to, że niektórzy deweloperzy mieli trudności z poprawną identyfikacją zainstalowanego builda, co utrudniało diagnostykę błędów i raportowanie problemów.

    Poprzednie wydanie – v0.46.0-preview – wprowadziło znaczące zmiany. Inżynierowie Google przeprojektowali obsługę PTY (pseudo-terminali), co jest kluczowe dla komunikacji między procesami w terminalu. Wcześniej zmiana rozmiaru okna terminala mogła prowadzić do poważnych awarii. Teraz ten scenariusz jest obsługiwany w sposób bezpieczny.

    Koniec ze spamem w konsoli
    Koniec ze spamem w konsoli

    Drugim problemem, który został rozwiązany w poprzedniej wersji, były pętle spamowe. Użytkownicy zgłaszali przypadki, w których Gemini CLI wpadał w niekontrolowaną pętlę generowania komunikatów, zalewając konsolę powtarzającymi się wpisami. Problem występował głównie podczas dłuższych sesji i w specyficznych konfiguracjach narzędzia.

    Wersja v0.46.0-preview.1 wprowadziła mechanizmy zapobiegające tym zapętleniom, a obecna łatka konsoliduje te zmiany, zapewniając spójność w ramach ekosystemu wersji. To klasyczny cykl wydawniczy Google dla Gemini CLI – najpierw większa aktualizacja z nowymi funkcjami, a następnie szybka łatka eliminująca wykryte nieścisłości.

    Jak zaktualizować
    Jak zaktualizować

    Gemini CLI jest dostępne jako pakiet npm, więc aktualizacja do wersji preview sprowadza się do jednego polecenia:

    npm install -g @google/gemini-cli@preview

    Po instalacji narzędzie uruchamia się standardową komendą gemini w terminalu. Należy pamiętać, że kanał preview nie jest w pełni zweryfikowany – mogą wystąpić regresje lub inne błędy. Dlatego zespół Google prosi użytkowników o testowanie i zgłaszanie problemów. Dla środowisk produkcyjnych nadal zalecany jest kanał stable, który przechodzi pełny cykl walidacji.

    Szerszy kontekst

    Gemini CLI to interesujący projekt w ekosystemie narzędzi AI dla deweloperów. W przeciwieństwie do rozwiązań zintegrowanych z IDE, działa całkowicie w terminalu, co doceniają osoby pracujące na zdalnych serwerach lub w środowiskach bez interfejsu graficznego.

    Narzędzie rozwija się dynamicznie, a Google stosuje przejrzysty model wydawniczy: codzienne buildy "nightly", cotygodniowe promocje do preview i stabilne wydania po tygodniu testów. Dzięki temu społeczność ma stały dostęp do najnowszych funkcji, a jednocześnie istnieje bezpieczna ścieżka dla tych, którzy wolą poczekać na sprawdzone wersje.
    Źródła

  • Google Antigravity 2.0.10 załatało błąd kredytów G1 i poprawiło stabilność

    Google Antigravity 2.0.10 załatało błąd kredytów G1 i poprawiło stabilność

    Google wypuściło aktualizację Antigravity 2.0.10, która została wydana 28 maja 2026 roku. Ta wersja koncentruje się na naprawie błędów oraz poprawie niezawodności aplikacji. Zespół rozwiązał przede wszystkim krytyczny problem związany z kredytami G1, który wpływał na historię salda użytkowników.

    • Google wydało wersję 2.0.10 swojej aplikacji Antigravity 28 maja 2026
    • Główną zmianą jest poprawka błędu kredytów G1, który zniekształcał wyświetlanie salda konta
    • Dodatkowo wprowadzono szereg poprawek zwiększających ogólną niezawodność i użyteczność
    • Antigravity 2.0.10 zastąpiło wcześniejsze IDE, zmieniając podejście na aplikację desktopową skoncentrowaną na agentach AI

    Błąd G1 – co dokładnie poprawiono?

    Problem z kredytami G1 był jednym z bardziej irytujących błędów, które pojawiły się po premierze Antigravity 2.0.10. Użytkownicy zauważali różnice między rzeczywistym stanem wykorzystanych jednostek rozliczeniowych a tym, co pokazywał interfejs. W niektórych przypadkach system nie poprawnie odzwierciedlał zużycie kredytów z pakietu Google One. Ta kwestia była już częściowo rozwiązana w łatce 2.0.10, ale nie do końca skutecznie.

    Wersja 2.0.10 zamyka ten temat. Mechanizm śledzenia salda został poprawiony, aby dane wyświetlane w zakładce Models w ustawieniach zgadzały się z rzeczywistym stanem konta. Dla osób intensywnie korzystających z agentów AI ma to praktyczne znaczenie – użytkownicy mogą teraz łatwo sprawdzić, ile kredytów faktycznie zostało, bez konieczności ręcznego przeliczania.

    W changelogu nie podano szczegółów technicznych poprawki. Wpis ogranicza się do stwierdzenia „G1 credit bug fix”. Jednak na podstawie wcześniejszych problemów można przypuszczać, że chodziło o synchronizację między backendem rozliczeniowym a lokalnym stanem aplikacji.

    Niezawodność i użyteczność – zbiorcza kategoria poprawek

    Niezawodność i użyteczność – zbiorcza kategoria poprawek

    Oprócz poprawki G1, Antigravity 2.0.10 przynosi również zbiór poprawek określonych jako „różne usprawnienia niezawodności i użyteczności”. To klasyczny zbiór, w którym Google umieszcza mniejsze poprawki, które nie wymagają osobnego opisywania. W praktyce chodzi prawdopodobnie o stabilniejsze działanie przy przełączaniu konwersacji, mniej awarii przy operacjach na plikach oraz ogólne wygładzenie interfejsu.

    Wersja 2.0.10 nie wprowadza nowych funkcji. Nie ma wsparcia dla PDF-ów (to pojawiło się w 2.0.10), nie ma komendy /btw ani przeprojektowanego ekranu limitów. To inżynieryjne wydanie, które przygotowuje grunt pod późniejsze, bardziej rozbudowane aktualizacje.

    Kontekst: Antigravity 2.0.10 jako następca IDE

    Wersja 2.0.10 pojawia się nieco ponad tydzień po premierze Antigravity 2.0.10, zaprezentowanej na Google I/O 19 maja 2026 roku. Ta premiera była dużą zmianą – Google porzuciło dotychczasowe podejście w stylu IDE i zastąpiło je samodzielną aplikacją desktopową skoncentrowaną na agentach.

    Dla wielu programistów oznaczało to utratę znanych narzędzi – eksploratora plików, terminala czy kontroli wersji wbudowanych w poprzednie środowisko. Dlatego kolejne łatki, takie jak 2.0.10, są niezwykle ważne – stabilizują nowe doświadczenie, podczas gdy zespół odbudowuje funkcjonalności w nowej architekturze.

    Co ciekawe, wersja 2.0.10 dodała integrację z Antigravity IDE, co umożliwia otwieranie projektów w starym środowisku. Wygląda na to, że Google stworzyło most między starym a nowym światem, zamiast całkowicie odcinać użytkowników.

    Co dalej?

    Patrząc na dalszy ciąg changeloga – wersje 2.0.10, 2.0.10 czy 2.0.10 – widać, że tempo rozwoju jest wysokie. Kolejne wydania wprowadzają wsparcie dla PDF-ów, komendę /btw do bocznych pytań w trakcie konwersacji, a nawet odtwarzanie plików audio bezpośrednio w aplikacji.

    Dla osób śledzących rozwój narzędzi AI i środowisk pracy z agentami, Antigravity staje się interesującym przypadkiem. Google stara się zbudować pomost między klasycznym IDE a w pełni agentskim workflow – coś, co konkurencja również próbuje robić, ale na razie bez jednego spójnego produktu. Wersja 2.0.10 to mały, ale solidny krok w stronę stabilności, która jest kluczowa dla funkcji aplikacji.


    Źródła

  • Gemini CLI zyskuje stabilność: nowa wersja preview poprawia zarządzanie sesjami

    Gemini CLI zyskuje stabilność: nowa wersja preview poprawia zarządzanie sesjami

    Google wypuściło nową wersję preview swojego narzędzia Gemini CLI, oznaczoną jako v0.45.0-preview.1. Ta wersja nocna z lipca 2026 roku koncentruje się na stabilności działania oraz lepszej kontroli nad tym, co AI pamięta podczas sesji. Chociaż nie wprowadza spektakularnych nowości wizualnych, zmiany w działaniu są solidne i przemyślane.

    Co nowego w Gemini CLI v0.45.0-preview.1

    • Metadane użycia – CLI pokazuje teraz informacje o zużyciu tokenów, co ułatwia kontrolę kosztów.
    • Sekwencyjne wykonanie narzędzia update_topic – wymuszenie kolejności eliminuje błędy w złożonych sesjach.
    • Stabilność na Termuksie – naprawiono zapętlone restarty, które wcześniej uniemożliwiały pracę na Androidzie.
    • Wyciszenie błędów PTY – zmiana rozmiaru terminala nie generuje już nadmiaru komunikatów.
    • Filtrowanie historii – uproszczone zarządzanie kontekstem pozwala precyzyjniej wznawiać sesje.

    Narzędzia działają przewidywalniej

    Jedną z kluczowych poprawek jest wymuszenie sekwencyjnego wykonania dla narzędzia update_topic. W poprzednich wersjach równoległe operacje na stanie sesji prowadziły do nieprzewidywalnych rezultatów, co mogło zakłócać intensywne kodowanie. Teraz każda aktualizacja tematu czeka na swoją kolej, co pozwala na zachowanie spójności stanu sesji.

    Dla osób praktykujących vibe coding to istotna zmiana. Pracując z AI przez dłuższy czas, nawet drobny błąd kontekstu może wprowadzić chaos w projekcie. Gemini CLI stara się minimalizować takie ryzyko.

    Kolejna poprawka dotyczy wyciszenia błędów związanych ze zmianą rozmiaru okna terminala. To jedna z tych irytujących kwestii, które nie psują funkcjonalności, ale generują wiele zbędnych komunikatów. Teraz te komunikaty są stłumione.

    Lepsza kontrola nad kosztami i sesjami

    Lepsza kontrola nad kosztami i sesjami

    Wersja v0.45.0-preview.1 wprowadza możliwość podejrzenia metadanych użycia bezpośrednio w CLI, co obejmuje informacje o zużyciu tokenów i związanych z tym kosztach API.

    Dla zespołów pracujących z hostingiem AI i infrastrukturą chmurową to oszczędność czasu. Nie trzeba już przeskakiwać do zewnętrznych paneli, aby sprawdzić koszty ostatniej sesji. Wszystko jest widoczne w terminalu, co ułatwia podejmowanie decyzji i optymalizację zapytań.

    Android i MCP – mniej awarii, więcej bezpieczeństwa

    Naprawa pętli restartów na Termuksie to ważna zmiana dla deweloperów pracujących na urządzeniach z Androidem. Wcześniej CLI mogło restartować się w nieskończoność bez prawidłowego startu, co uniemożliwiało jego użycie. Teraz ten błąd został usunięty.

    Dodatkowo poprawiono bezpieczeństwo list narzędzi MCP (Model Context Protocol) oraz zoptymalizowano automatyczny routing, co wpływa na niezawodność narzędzia.

    Co to oznacza dla codziennej pracy

    Nowe wydanie Gemini CLI to zestaw przemyślanych poprawek, które sprawiają, że praca z narzędziem staje się płynniejsza. Wymuszenie sekwencyjności, filtrowanie historii sesji i metadane użycia to elementy, które będą szczególnie przydatne podczas dłuższych projektów. Niezależnie od tego, czy używasz Gemini CLI do szybkich zadań, czy wielogodzinnych sesji programistycznych, stabilność jest kluczowa.


    Źródła

  • Google wprowadza Gemini 3.5 Flash: szybki model agentowy dla programistów

    Google wprowadza Gemini 3.5 Flash: szybki model agentowy dla programistów

    Google ogłosił, że jego nowy model sztucznej inteligencji, Gemini 3.5 Flash, jest teraz dostępny dla wszystkich. Model ten, który zadebiutował 19 maja 2026 roku, jest zaprezentowany jako najszybsza i najbardziej opłacalna opcja w ofercie Google, stworzona z myślą o złożonych zadaniach agentowych oraz programistycznych. To stabilne narzędzie, gotowe do zastosowania na dużą skalę, skierowane jest głównie do deweloperów i zespołów DevOps.

    Gemini 3.5 Flash to model „Flash-tier”, co oznacza, że koncentruje się na niskich opóźnieniach i przystępnych kosztach, przy zachowaniu solidnej wydajności. Jego wyróżnikiem jest kontekst sięgający 1 miliona tokenów oraz możliwość generowania odpowiedzi o długości do 65 536 tokenów. Google zoptymalizował ten model pod kątem długich, wieloetapowych przepływów pracy, iteracyjnego debugowania kodu oraz efektywnego wykorzystywania narzędzi.

    Kluczowe informacje o modelu

    • Status i data: Model jest ogólnie dostępny (GA) od 19 maja 2026 roku.
    • Moc obliczeniowa: Obsługuje 1 048 576 tokenów kontekstu i do 65 536 tokenów wyjścia.
    • Multimodalność: Akceptuje dane wejściowe w formie tekstu, kodu, obrazów, audio, wideo i PDF, generując tekst.
    • Ograniczenia: Nie obsługuje jeszcze Gemini Live API, Content Credentials (C2PA) ani funkcji Computer Use.

    Siła w zadaniach agentowych i kodowaniu

    Podstawową filozofią Gemini 3.5 Flash jest wspieranie „agentycznego wykonywania”. Model działa jak autonomiczny asystent, który planuje, dzieli problem na etapy i używa narzędzi do znalezienia rozwiązania. Dla programistów oznacza to bardziej niezawodnego partnera do refaktoryzacji dużych fragmentów kodu, pisania testów czy analizy całego repozytorium, dzięki dużemu oknu kontekstu.

    Nowością jest funkcja „zachowania myśli” (thought preservation), która przechowuje kontekst rozumowania między kolejnymi turami konwersacji. Może to poprawić wyniki w skomplikowanych, iteracyjnych zadaniach, choć Google zauważa, że może również zwiększyć zużycie tokenów. To podejście sprawdza się w sytuacjach wymagających ciągłości rozumowania, na przykład przy poprawianiu błędów i optymalizacji kodu.

    Wydajność, szybkość i koszty

    Nieoficjalne testy wskazują, że Gemini 3.5 Flash jest znacznie szybszy od swojego poprzednika, osiągając ponad 280 tokenów wyjściowych na sekundę w niektórych konfiguracjach testowych. Jednak ta szybkość i poprawiona inteligencja wiążą się z wyższymi kosztami.

    Szacuje się, że nowy model może być nawet pięciokrotnie droższy w eksploatacji w niektórych scenariuszach benchmarkowych w porównaniu do Gemini 3.5 Flash. Wynika to z wyższej ceny bazowej oraz potencjalnie większego zużycia tokenów przez zaawansowane rozumowanie. Przewidywane ceny to 1,50 USD za 1 milion tokenów wejściowych i 9,00 USD za 1 milion tokenów wyjściowych, z 90% zniżką dla tokenów z cache’a.

    Dlaczego to ważne dla świata web dev i AI?

    Dla społeczności zajmującej się rozwojem webowym, vibe codingu i DevOps, wprowadzenie Gemini 3.5 Flash to istotna wiadomość. Bezpośrednia optymalizacja pod kątem kodowania i długich zadań agentowych czyni go potencjalnie idealnym silnikiem dla zaawansowanych asystentów programistycznych lub autonomicznych narzędzi deploymentu.

    Status GA (general availability) oraz deklarowana gotowość do skalowania w produkcji to zielone światło dla zespołów SaaS i platform hostingowych, które chcą integrować zaawansowane AI bez obaw o niestabilność wersji beta. Możliwość przetwarzania dokumentów PDF, wideo czy audio otwiera także drogę do tworzenia agentów analizujących dokumentację techniczną, logi czy nagrania ze spotkań.

    Podsumowanie

    Gemini 3.5 Flash to odpowiedź Google na rosnące zapotrzebowanie rynku na szybkie, niezawodne i myślące modele AI do zastosowań produkcyjnych. Choć wiąże się z wyższą ceną niż poprzednia generacja, oferuje znaczący postęp w inteligencji, zwłaszcza w obszarze zadań agentowych i programistycznych. Dla deweloperów i inżynierów AI stwarza nowe możliwości budowania bardziej złożonych i samodzielnych aplikacji, które potrafią nie tylko odpowiadać, ale także planować i wykonywać wieloetapowe procesy. Jego prawdziwa wartość ujawni się w praktyce, gdy zespoły zaczną wykorzystywać długi kontekst i domyślne rozumowanie do automatyzacji skomplikowanych przepływów pracy.

  • Gemini CLI v0.39.0-nightly.20260409: lepsza kontrola i wydajność dla nocnej wersji

    Gemini CLI v0.39.0-nightly.20260409: lepsza kontrola i wydajność dla nocnej wersji

    Google wydało nową nocną wersję swojego narzędzia AI działającego w terminalu — Gemini CLI v0.39.0-nightly.20260409. Aktualizacja koncentruje się na zwiększeniu kontroli użytkownika nad agentem, poprawie wydajności systemu oraz usunięciu kilku kluczowych błędów, które utrudniały pracę. Dla deweloperów i entuzjastów web devu oraz AI oznacza to bardziej stabilne i przewidywalne środowisko pracy bezpośrednio z linii poleceń.

    Wśród najważniejszych zmian widać wyraźny nacisk na bezpieczeństwo operacji. Tryb Plan, w którym AI może autonomicznie planować zadania, teraz wymaga od użytkownika ręcznego potwierdzenia przed aktywacją każdej umiejętności. To istotna zmiana, która pozwala na lepszą kontrolę nad bardziej złożonymi, automatycznymi workflow. Dopracowano także formatowanie wyjścia narzędzi oraz obsługę klawiszy w Windows Terminal, rozwiązując problem z usuwaniem całych słów za pomocą Ctrl+Backspace.

    Kluczowe zmiany w nocnej wersji 0.39.0

    • Wzmocniona kontrola w trybie Plan: Wprowadzono obowiązkowe potwierdzenie użytkownika dla aktywacji umiejętności, co daje większą władzę nad działaniami agenta.
    • Poprawki dla Windows Terminal i stabilności sesji: Naprawiono błąd uniemożliwiający usuwanie całych słów (Ctrl+Backspace) w Windows Terminal oraz problemy z wznawianiem zawieszonych sesji.
    • Wydajność i optymalizacja: Dodano nowe mechanizmy testowania zużycia pamięci i CPU, aby zapobiegać regresjom wydajności.
    • Bezpieczeństwo sandboxa: Wdrożono refaktoryzację sandboxa Seatbelt dla macOS oraz naprawiono problemy z symlinkami na Windows, co zwiększa izolację i bezpieczeństwo wykonywanych operacji.

    Ta nocna wersja to nie tylko poprawki, ale także rozwój infrastruktury testowej. Zespół dodał zaawansowane testy integracyjne mierzące zużycie pamięci i wydajność procesora, co pokazuje dbałość o długoterminową stabilność projektu.

    Dla użytkowników oznacza to bardziej responsywne działanie CLI. Szczególnie ważna dla programistów pracujących na Windowsie jest poprawka w Windows Terminal, która przywraca intuicyjne edytowanie linii poleceń.

    Rozwój ekosystemu i przyszłość

    Wydanie wpisuje się w szerszy trend rozwoju Gemini CLI jako platformy. Widać inwestycję w rozszerzalność i dalsze prace nad integracją z MCP serverami. Projekt, będący open source, aktywnie rozwija społeczność, co potwierdza długa lista pull requestów od wielu kontrybutorów.

    Choć wersja nightly jest przeznaczona dla użytkowników chcących testować najnowsze, czasem niestabilne funkcje, to wprowadzone w wersji 0.39.0 poprawki są niezwykle praktyczne. Niektóre z nich, jak naprawa Ctrl+Backspace na Windowsie, były wyczekiwane przez długi czas. To pokazuje, że zespół nie tylko dodaje nowe, eksperymentalne możliwości, ale także słucha społeczności i troszczy się o codzienny komfort pracy.

    Dla deweloperów zainteresowanych AI, web devem czy automatyzacją zadań devopsowych, Gemini CLI staje się coraz bardziej dojrzałym narzędziem. Ta nocna aktualizacja, skoncentrowana na kontroli i wydajności, to krok w kierunku zapewnienia stabilności potrzebnej do profesjonalnego wykorzystania AI w terminalu. Warto obserwować dalsze zmiany, zwłaszcza w stabilnych wydaniach, które powinny wkrótce wchłonąć te ulepszenia.


    Źródła

  • Google uwalnia potencjał sztucznej inteligencji na Macu. Gemini for Mac już oficjalnie dostępne

    Google uwalnia potencjał sztucznej inteligencji na Macu. Gemini for Mac już oficjalnie dostępne

    Google udostępniło natywną aplikację Gemini na komputery Mac. Program nie jest jedynie kopią wersji przeglądarkowej, ale został napisany od podstaw w języku Swift, co pozwala na integrację z systemem macOS. Użytkownicy mogą korzystać z darmowej wersji z limitami lub wybrać płatne pakiety, takie jak AI Plus, AI Pro czy AI Ultra.

    Aplikacja jest dostępna do pobrania na stronie gemini.google/mac/. Google zdecydowało się ominąć App Store, co pozwala firmie wydawać aktualizacje bez czekania na weryfikację Apple. Do działania wymagany jest komputer z procesorem Apple Silicon oraz system macOS 15 (Sequoia) lub nowszy. Osoby korzystające ze starszych wersji systemu lub komputerów z procesorami Intel nie mogą zainstalować tej wersji.

    Szybkość i analiza treści na ekranie

    Główną zaletą aplikacji jest łatwy dostęp, przypominający działanie systemowej wyszukiwarki Spotlight. Program można wywołać skrótem klawiaturowym Option + Spacja, co otwiera małe okno do szybkich pytań. Pełny czat uruchamia się kombinacją Option + Shift + Spacja. Ikona Gemini jest widoczna w Docku oraz na górnym pasku menu.

    Aplikacja potrafi analizować to, co aktualnie wyświetla się na monitorze. Po włączeniu odpowiednich uprawnień w ustawieniach prywatności i dostępności, Gemini widzi otwarte dokumenty PDF, arkusze kalkulacyjne czy kod w edytorze. Dzięki temu asystent może streścić tekst, wyjaśnić skomplikowane fragmenty danych lub zasugerować poprawki w projekcie graficznym bez konieczności ręcznego kopiowania treści.

    Narzędzia dla twórców i programistów

    Gemini na Maca oferuje te same funkcje, co wersja mobilna i przeglądarkowa. Użytkownicy mogą korzystać z modelu Imagen 3 do generowania obrazów oraz narzędzia Veo do tworzenia krótkich materiałów wideo. Program ułatwia pracę nad projektami kreatywnymi i technicznymi.

    Programiści i osoby pracujące z dużą ilością danych mogą przesyłać pliki bezpośrednio do aplikacji. Gemini pomaga w pisaniu kodu, tłumaczeniu tekstów i planowaniu zadań. Dzięki temu, że aplikacja działa lokalnie jako natywny program, reaguje szybciej niż interfejs w przeglądarce internetowej.

    Konkurencja na rynku

    Wprowadzenie tej aplikacji to ruch wymierzony w ChatGPT Desktop oraz Microsoft Copilot. Google postawiło na ścisłe połączenie asystenta z systemem operacyjnym, co ma przyciągnąć osoby na co dzień korzystające z komputerów Apple.

    Oficjalna premiera odbyła się 16 kwietnia 2024 roku, kończąc okres zamkniętych testów. Od pierwszych zapowiedzi aplikacja została rozbudowana o stabilną analizę ekranu i obsługę plików. Google regularnie dodaje nowe funkcje, dostosowując narzędzie do aktualnych możliwości modeli językowych.

    Dostępność i wymagania

    Gemini na Maca jest skierowane do osób, które chcą mieć dostęp do sztucznej inteligencji bez przełączania się między kartami przeglądarki. Choć wymóg posiadania najnowszego systemu i procesora Apple Silicon ogranicza grono odbiorców, zapewnia to płynne działanie programu.

    Aplikacja obsługuje język polski oraz wszystkie inne języki dostępne wcześniej w wersji mobilnej. Wybór między instalacją aplikacji a korzystaniem z przeglądarki zależy od tego, jak bardzo asystent ma być zintegrowany z codziennymi zadaniami. Google promuje rozwiązanie systemowe jako szybszy i wygodniejszy sposób pracy na Macu.

  • Google łączy siły: NotebookLM teraz głęboko zintegrowany z aplikacją Gemini

    Google łączy siły: NotebookLM teraz głęboko zintegrowany z aplikacją Gemini

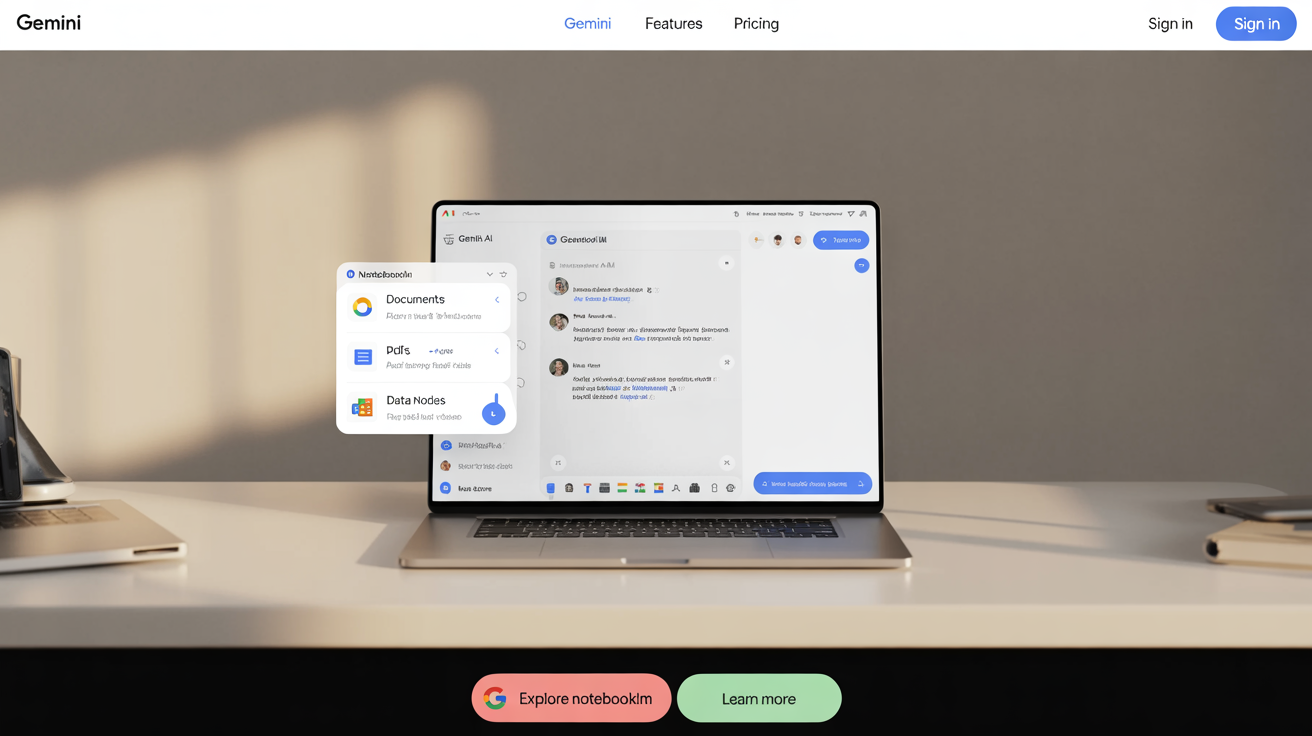
    Google wprowadziło zmianę w sposobie korzystania ze swoich narzędzi AI, łącząc NotebookLM bezpośrednio z aplikacją Gemini. NotebookLM, który do tej pory był osobnym programem do analizy dokumentów, jest teraz dostępny z poziomu głównego czatu Gemini. Dzięki temu użytkownicy nie muszą już przełączać się między różnymi kartami przeglądarki, aby pracować na swoich materiałach.

    Obsługa tej funkcji jest prosta. W oknie czatu Gemini, obok ikony dodawania plików, znajduje się przycisk NotebookLM. Po jego kliknięciu można wybrać konkretny notatnik zawierający pliki PDF, artykuły czy transkrypcje z YouTube. Od tego momentu Gemini wykorzystuje te dokumenty jako bazę do udzielania odpowiedzi. AI automatycznie uwzględnia treść źródeł przy tworzeniu streszczeń czy analiz, bez konieczności każdorazowego wklejania tekstu do czatu.

    Jak to działa w praktyce

    Główną korzyścią jest wygoda. Użytkownik rozmawia z Gemini, korzystając z możliwości modelu, a jednocześnie ma pewność, że odpowiedzi opierają się na jego własnych plikach. Aby sprawdzić konkretne źródło lub dodać nowy dokument, wystarczy kliknąć przycisk "źródła". Wszystkie dane i zmiany w notatnikach są aktualizowane na bieżąco.

    Integracja pozwala też na zarządzanie bazą wiedzy bezpośrednio z poziomu Gemini. Można tam dodawać nowe linki i pliki, a także zapisywać fragmenty rozmów bezpośrednio w strukturze notatnika.

    Różnica w sposobie działania

    To połączenie zmienia sposób, w jaki AI przetwarza informacje. Standardowy NotebookLM jest systemem zamkniętym, co oznacza, że odpowiada tylko na podstawie wgranych dokumentów. Wersja wbudowana w Gemini daje większy wybór.

    Użytkownik może zdecydować, czy AI ma trzymać się wyłącznie dostarczonych materiałów, czy może uzupełnić odpowiedź o informacje z internetu. Pozwala to na łączenie precyzyjnej analizy własnych danych z szeroką wiedzą dostępną w sieci.

    Zastosowanie w nauce i pracy

    Połączenie bazy wiedzy NotebookLM z funkcjami konwersacyjnymi Gemini ułatwia pracę osobom zajmującym się analizą danych, studentom i badaczom. Rozwiązuje to problem wyboru między narzędziem do pracy na źródłach a wszechstronnym asystentem AI.

    W edukacji rozwiązanie to wykorzystuje model Gemini z komponentami LearnLM, które są dostosowane do celów dydaktycznych. Nauczyciele mogą dzięki temu sprawniej przygotowywać materiały na podstawie konkretnych podręczników, a studenci mogą analizować literaturę przedmiotu w jednym oknie.

    Nowe możliwości dla użytkowników

    Wprowadzenie NotebookLM do Gemini upraszcza proces badania i gromadzenia informacji. Zamiast korzystać z kilku osobnych narzędzi, użytkownik otrzymuje jedno środowisko, w którym porządkuje źródła i od razu o nie pyta.

    Obecnie funkcja ta jest wdrażana stopniowo, głównie dla użytkowników korzystających z komputerów. Google dąży do ściślejszego powiązania swoich usług AI, co w praktyce oznacza mniej kopiowania danych i szybszy dostęp do własnych notatek podczas rozmowy z botem. Dla osób pracujących z dużą ilością tekstu jest to ułatwienie, które realnie przyspiesza codzienną pracę.

  • Google Gemma 4: Nowa Era Otwartych Modeli AI z Ogromną Mocą

    Google Gemma 4: Nowa Era Otwartych Modeli AI z Ogromną Mocą

    Google właśnie pokazał światu nową generację swoich flagowych, otwartych modeli AI. Gemma 4 to nie zwykła iteracja, lecz zasadniczy skok, który stawia te lekkie konstrukcje w ścisłej czołówce globalnych rankingów, pozwalając im konkurować z modelami wielokrotnie większymi. To wydanie kładzie duży nacisk na zaawansowane rozumowanie i tzw. zdolności agentowe (agentic workflows), czyli umiejętność samodzielnego planowania i wykonywania wieloetapowych zadań przez AI.

    Wydajność nowej rodziny modeli jest imponująca. Wersja 26B typu Mixture of Experts (MoE) plasuje się na 6. miejscu na światowej liście liderów LMSYS Chatbot Arena wśród modeli otwartych. Co najważniejsze, Gemma 4 potrafi wygrywać w benchmarkach z modelami aż 20 razy większymi, co ma kluczowe znaczenie dla praktycznych wdrożeń.

    Rodzina modeli i ich kluczowe możliwości

    Google oferuje Gemmę 4 w czterech precyzyjnie dopasowanych rozmiarach. Są to: Effective 2B (E2B) dla maksymalnej oszczędności pamięci, Effective 4B (E4B) jako kompromis między możliwościami a zasobami na urządzeniach brzegowych (edge devices), oraz 26B MoE (A4B), charakteryzujący się niesamowitą szybkością dzięki aktywacji tylko około 4 miliardów parametrów jednocześnie. Modele E2B i E4B mają odpowiednio około 2,3 mld i 4,5 mld aktywnych parametrów.

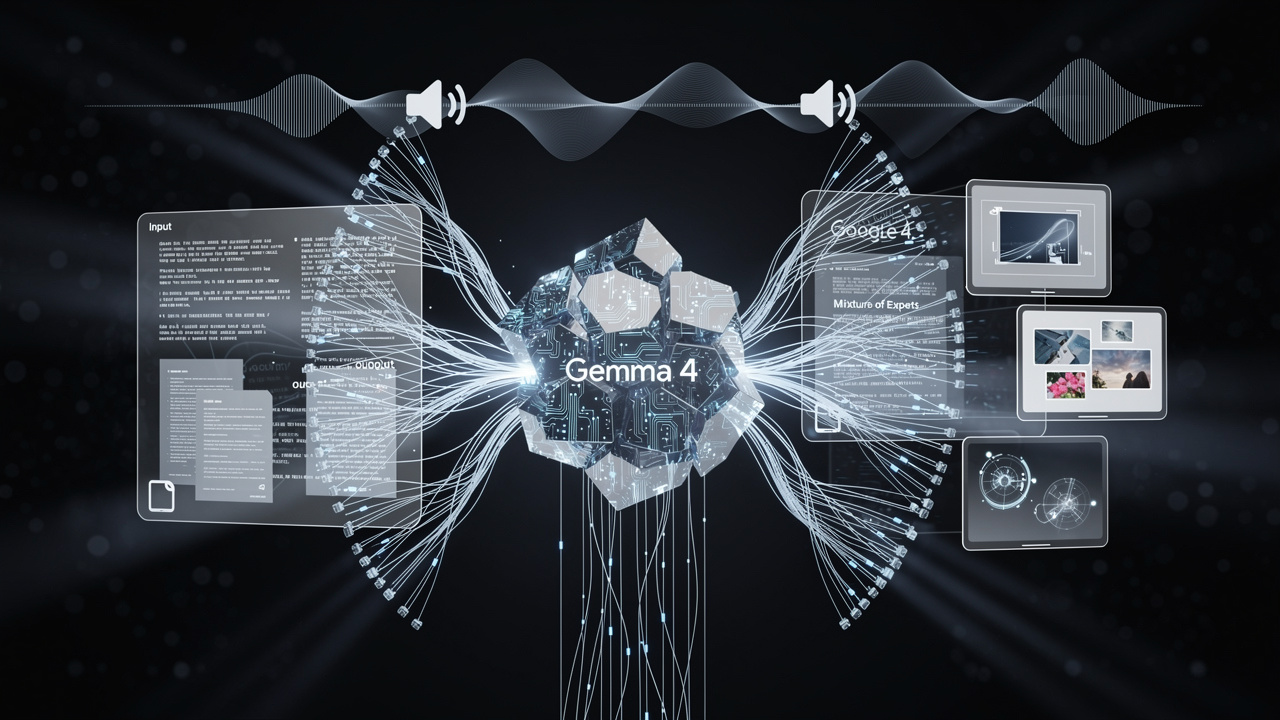
    Prawdziwa siła Gemmy 4 leży w jej uniwersalności. Wszystkie modele są natywnie multimodalne – przetwarzają zarówno tekst, jak i obrazy o zmiennym formacie. Każdy z nich radzi sobie także z wideo, a architektura wspiera również dźwięk, co otwiera drogę do zaawansowanej analizy multimodalnej.

    Kluczową nowością jest nacisk na rozumowanie i działania agentowe. Gemma 4 została zaprojektowana od podstaw jako świetny „myśliciel”, potrafiący prowadzić wieloetapowe rozumowanie i planowanie. To właśnie ta cecha, zwykle zarezerwowana dla największych, zamkniętych modeli, jest tu dostępna w lekkiej formie. Dodano też natywne wsparcie dla promptów systemowych (system prompts), co pozwala na bardziej kontrolowane i ustrukturyzowane interakcje z AI.

    Przełom w wydajności i dostępności

    Gemma 4 dokonuje prawdziwej rewolucji w zakresie wydajności na urządzeniach brzegowych. Dzięki ulepszeniom architektonicznym, takim jak Grouped Query Attention (GQA) czy przycięte osadzenia pozycyjne Rotary (p-RoPE), modele działają niezwykle sprawnie. Testy wykazują, że osiągają one wysoką wydajność nawet na ograniczonym sprzęcie. Z kolei przy wykorzystaniu akceleracji dedykowanych jednostek NPU szybkość generowania tekstu wzrasta do tysięcy tokenów na sekundę.

    Rozszerzone okna kontekstowe (context window) – do 128K dla małych modeli i 256K dla średnich – pozwalają na dynamiczną pracę z długimi dokumentami. Inżynierowie odnotowali znaczące przyspieszenie fazy przetwarzania wstępnego (prefills) w modelu E2B. Wszystko to przekłada się na realne korzyści: osiąganie poziomu modeli klasy „frontier” przy ułamku kosztów sprzętowych, możliwość pracy offline, lepszą prywatność i mniejsze opóźnienia.

    Dla programistów Gemma 4 przynosi znaczący postęp w generowaniu kodu i obsłudze wywołań funkcji (function calling), umożliwiając lokalną asystę programistyczną wysokiej jakości. Model wspiera od razu ponad 35 języków, będąc trenowanym na korpusie obejmującym ponad 140 języków, co czyni go narzędziem globalnym.

    Co to oznacza dla rynku AI?

    Wydanie Gemmy 4 na liberalnej licencji Apache 2.0 to jasny sygnał dotyczący strategii Google. Od debiutu pierwszej wersji, modele te cieszą się ogromną popularnością w społeczności, która stworzyła dziesiątki tysięcy ich wariantów. Teraz Google nie tylko dostarcza otwarte alternatywy, ale sprawia, że są one w pełni konkurencyjne pod względem możliwości.

    To posunięcie przyspiesza demokratyzację zaawansowanej sztucznej inteligencji. Firmy i deweloperzy, którzy potrzebowali mocy największych modeli, ale obawiali się kosztów, uzależnienia od chmury (vendor lock-in) lub wymogów prywatności, otrzymują potężne narzędzie do wdrożeń lokalnych i brzegowych. Gemma 4 jest już dostępna wieloma kanałami, w tym przez Hugging Face, Google AI Edge, a także w systemie Android w ramach wersji zapoznawczej AICore dla deweloperów.

    Podsumowanie

    Gemma 4 to coś więcej niż aktualizacja. To dowód na to, że era zaawansowanej sztucznej inteligencji nie musi być zarezerwowana wyłącznie dla gigantycznych, zamkniętych modeli chmurowych. Google, łącząc najnowocześniejsze techniki architektoniczne z filozofią otwartości, stworzył rodzinę modeli, które są jednocześnie potężne, wszechstronne i niezwykle efektywne. Może to zmienić reguły gry, przyspieszając innowacje i pozwalając na budowę inteligentnych aplikacji bezpośrednio na naszych urządzeniach.

  • Gemma 4 od Google: Cztery Modele Open-Weight Zmieniające Rozgrywkę w AI

    Gemma 4 od Google: Cztery Modele Open-Weight Zmieniające Rozgrywkę w AI

    Google udostępniło rodzinę modeli Gemma 4, składającą się z czterech multimodalnych systemów AI typu open-weight. Wszystkie są objęte licencją Apache 2.0, ale to nie otwartość jest ich największą bronią. Jest nią inteligencja i wydajność, która – jak pokazują benchmarki – pozwala im rywalizować ze znacznie większymi modelami. To kolejny mocny krok w stronę demokratyzacji zaawansowanej sztucznej inteligencji, szczególnie w kluczowych obszarach: AI na urządzenia brzegowe (edge) oraz agentic AI.

    Frontier-Level Performance w różnych skalach

    Nie ma jednego uniwersalnego modelu Gemma 4. Google stworzyło cztery warianty precyzynie dopasowane do różnych potrzeb i możliwości sprzętowych.

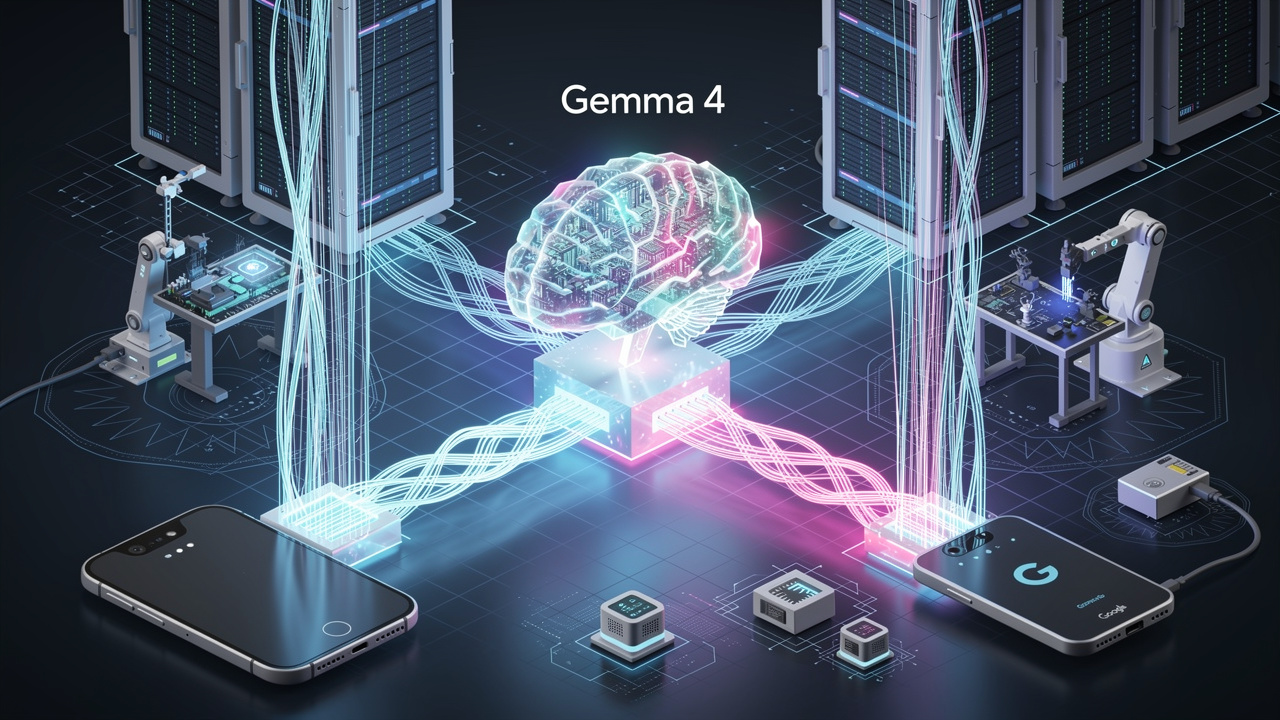
    • Effective 2B (E2B) i Effective 4B (E4B) są skrojone pod świat mobile i edge computing. Priorytetem jest tu niska latencja i multimodalność (obsługa tekstu i obrazów). Warianty te oferują również natywny odbiór audio, co umożliwia responsywne przetwarzanie mowy. Mogą działać offline na platformach takich jak Android AI Core, Google AI Edge czy nawet NVIDIA Jetson Nano.
    • 26B A4B (wariant typu Mixture of Experts) oraz 31B Dense trafiają do świata stacji roboczych i serwerów. Wykorzystują hybrydową uwagę (lokalną i globalną) oraz obsługują kontekst do 256K tokenów. Ich siła tkwi w zaawansowanym rozumowaniu logicznym i kodowaniu.

    LMSYS Chatbot Arena mówi jasno: Gemma 4 osiąga poziom „inteligencji na parametr”, który można określić jako frontier-level. Modele plasują się wśród czołowych otwartych rozwiązań na tekstowej tablicy liderów Arena. Model 31B rywalizuje z takimi jednostkami jak Qwen 2.5 72B (w specyficznych zadaniach) czy inne modele o zbliżonej skali, podczas gdy model 26B również zajmuje wysoką pozycję. Oznacza to, że modele w klasie ~30B are już gotowe do złożonych procesów biznesowych (workflows), takich jak agentic search, bez konieczności posiadania niewyobrażalnych zasobów. Modele E2B/E4B, choć małe, radzą sobie wyjątkowo dobrze w ogólnych zadaniach w benchmarkach LMArena.

    Rewolucja dla Edge Computing i Agentic AI

    Rewolucja dla Edge Computing i Agentic AI

    Dwa główne obszary, w których Gemma 4 może zmienić status quo, są ze sobą ściśle powiązane.

    • Edge computing zyskuje potężny napęd. Gemma 4, szczególnie warianty E2B/E4B, pozwala na pełną analitykę on-device AI bez konieczności wysyłania danych do chmury. To nie tylko zerowa latencja, ale fundamentalna zmiana dla przedsiębiorstw i instytucji państwowych dbających o suwerenność danych. Możliwość uruchomienia zaawansowanego modelu multimodalnego (tekst i obraz) na telefonie, Raspberry Pi lub systemie wbudowanym otwiera drogę dla aplikacji, które były dotąd zarezerwowane dla potężnych serwerów: lokalnych asystentów kodujących (vibe coding), agentów analizujących obraz wideo czy transkrypcji audio w czasie rzeczywistym.

    • Agentic AI*(zdolności agentowe) to drugi filar. Gemma 4 nie jest już tylko chatbotem. Modele zostały zaprojektowane do wieloetapowego planowania (multi-step planning) i autonomicznych akcji. Mogą planować sekwencje działań, odpytywać źródła wiedzy (np. Wikipedię) i generować interaktywne treści. To właśnie przejście od statycznej konwersacji do dynamicznego agenta jest kluczem do nowych zastosowań w web devie, DevOps czy analizie danych. Otwarte wagi pozwalają firmom i deweloperom na fine-tuning modeli pod specyficzne, wrażliwe środowiska przy zachowaniu pełnej kontroli.

    Otwarcie drzwi dla deweloperów i „Gemmaverse”

    Od czasu premiery pierwszej Gemmy jej modele zostały pobrane ponad 400 milionów razy, a społeczność stworzyła ponad 100 tysięcy różnych wariantów. Gemma 4 ma szansę rozbudować ten ekosystem – „Gemmaverse” – szczególnie w niszach agentic search i programowania. Otwartość na licencji Apache 2.0, wraz z integracją z Hugging Face i GitHubem, znosi bariery wejścia. Redukuje też koszty sprzętowe w porównaniu do zamkniętych, ogromnych modeli chmurowych.

    Pojawia się tu uzasadniony optymizm. Istnieje realna, rosnąca potrzeba budowania nowych stosów technologicznych (stacks) wokół otwartych modeli, które dają własność i kontrolę nad rozwiązaniem. Gemma 4, ze swoją zróżnicowaną rodziną zoptymalizowaną pod kątem urządzeń brzegowych i serwerów, odpowiada na tę potrzebę w sposób bardzo praktyczny.

    Wnioski

    Premiera Gemma 4 od Google to nie tylko kolejna iteracja modelu. To strategiczne rozszerzenie portfolio, które celuje w najbardziej dynamiczne segmenty rozwoju AI: efektywną pracę na urządzeniach brzegowych i przejście od chatbotów do autonomicznych agentów. Osiągając wydajność klasy frontier-level w stosunku do liczby parametrów, modele te pokazują, że przyszłość może należeć nie tylko do gigantycznych systemów, ale także do inteligentnych, wydajnych i dostępnych lokalnie alternatyw. Dla deweloperów i firm oznacza to większą swobodę, kontrolę i możliwość tworzenia innowacji tam, gdzie wcześniej bariery sprzętowe były nie do przebicia.

  • Google Podnosi Stawkę: Gemini 3.1 Pro i Modele Muzyczne Lyria 3

    Google Podnosi Stawkę: Gemini 3.1 Pro i Modele Muzyczne Lyria 3

    Google ogłosiło istotną aktualizację dla programistów i twórców, wprowadzając do wersji preview model Gemini 3.1 Pro oraz nową generację modeli generatywnych Lyria 3. Ta aktualizacja to nie tylko kolejna iteracja, ale znaczący skok w zakresie zaawansowanego rozumowania i możliwości kreatywnych AI, które bezpośrednio przekładają się na narzędzia takie jak Gemini CLI, Vertex AI czy Gemini Enterprise.

    Podwojona moc rozumowania: co potrafi Gemini 3.1 Pro?

    Sercem ogłoszenia jest Gemini 3.1 Pro, który prezentuje imponujący postęp w kluczowych benchmarkach. Najbardziej rzuca się w oczy wynik w teście ARC-AGI-2, mierzącym abstrakcyjne i logiczne rozumowanie. Model osiągnął zweryfikowany wynik 77,1%, co stanowi ponad dwukrotność możliwości poprzednika, Gemini 3 Pro (31,1%). To fundamentalna poprawa zdolności modelu do radzenia sobie z nowymi, nieznanymi wcześniej problemami.

    Ta ulepszona inteligencja znajduje praktyczne zastosowanie. Model potrafi teraz syntetyzować dane z różnych źródeł, generować złożone wizualizacje i animacje, a także tworzyć zaawansowany kod. Przykłady pokazują tworzenie immersyjnych animacji 3D, takich jak „spleciony taniec stada szpaków” z generatywną ścieżką dźwiękową, czy dynamiczne wizualizacje w czasie rzeczywistym, np. orbity Międzynarodowej Stacji Kosmicznej. Model zachowuje przy tym długie okno kontekstowe do 1 miliona tokenów, a maksymalna długość odpowiedzi wzrosła do 65 536 tokenów.

    Kreatywność napędzana dźwiękiem: rola Lyria 3

    Równolegle do ulepszeń w rozumowaniu, Google odblokowuje nowy wymiar kreatywności dzięki modelom do generowania muzyki Lyria 3. Chociaż szczegóły techniczne są na razie ograniczone, jasne jest, że modele te pozwalają na integrację generatywnego audio z workflow opartymi na Gemini.

    Oznacza to, że deweloperzy pracujący nad projektami multimedialnymi, grami czy interaktywnymi instalacjami mogą wdrożyć dynamiczne generowanie ścieżek dźwiękowych, które reagują na wizualizacje lub działania użytkownika. Przykład z animacją stada ptaków, gdzie dźwięk zmienia się wraz z ruchem grupy, pokazuje praktyczny potencjał tej technologii w tworzeniu bogatszych, bardziej spójnych doświadczeń.

    Wpływ na ekosystem deweloperski: CLI, Enterprise i Vertex AI

    Te nowe możliwości nie pozostają w sferze laboratoryjnych demo. Są już integrowane z kluczowymi narzędziami Google dla programistów i firm.

    Dla użytkowników Gemini CLI, co stanowi bezpośrednią kontynuację wcześniejszych informacji o wersji 0.36.0-nightly, oznacza to dostęp do wzmocnionych agentów. Nowy endpoint gemini-3.1-pro-preview-customtools umożliwia bardziej autonomiczne zachowania agentowe, pozwalając na samodzielne planowanie i wykonywanie złożonych sekwencji zadań.

    W środowiskach korporacyjnych Gemini Enterprise i platforma Vertex AI zyskują silnik zdolny do zaawansowanej analizy danych, syntezy informacji i wsparcia skomplikowanych procesów decyzyjnych. Bezpośrednio wpływa to na obszary takie jak DevOps, analityka biznesowa czy tworzenie zaawansowanych platform agentowych.

    Podsumowanie: nowy etap w praktycznym wykorzystaniu AI

    Wprowadzenie Gemini 3.1 Pro i Lyria 3 wyznacza wyraźny kierunek rozwoju AI w Google. Zamiast skupiać się wyłącznie na powiększaniu modeli, firma inwestuje w jakość rozumowania i ekspresję kreatywną. Dla deweloperów zajmujących się web developmentem, vibe codingiem czy multimediami otwiera to drzwi do budowania aplikacji, które nie tylko efektywnie przetwarzają informacje, ale także potrafią je w intuicyjny sposób wizualizować i uzupełniać dynamiczną, generatywną warstwą dźwiękową. Wersja preview, dostępna już dla wybranych użytkowników, daje przedsmak tego, jak te technologie mogą zrewolucjonizować workflow w nadchodzących miesiącach.