Tag: Claude 3 Opus

  • Anthropic oddaje pełną kontrolę: Claude Managed Agents do samodzielnego hostingu

    Anthropic oddaje pełną kontrolę: Claude Managed Agents do samodzielnego hostingu

    Anthropic uruchomiło prywatną betę self-hosted Claude Managed Agents – usługi, która umożliwia firmom uruchomienie całego systemu agentów na własnej infrastrukturze, eliminując potrzebę korzystania z chmury dostawcy. Ogłoszenie z 12 listopada 2026 roku odpowiada na rosnące potrzeby organizacji, które pragną przechowywać dane, sesje oraz historię działania agentów we własnych systemach, jednocześnie zachowując elastyczność w wyborze modelu AI.

    Kluczowe fakty

    • Pełna samodzielność – klient uruchamia serwer, bazę danych, workerów i sandboksy na własnej infrastrukturze, zachowując pełną kontrolę nad danymi.
    • Elastyczny routing – zapytania do modelu mogą być kierowane do Anthropic, Amazon Bedrock, Google Cloud, Microsoft Foundry lub własnej bramki.
    • Lokalne przechowywanie – definicje agentów, sesje i historia pozostają w systemach klienta.
    • Kontrola sieci – organizacja decyduje, do jakich zasobów wewnętrznych mają dostęp workery i sandboksy.
    • Prywatna beta – dostęp wymaga kontaktu z zespołem konta Anthropic.

    Co tak naprawdę działa na infrastrukturze klienta

    Aby zrozumieć tę zmianę, należy odróżnić dwa pojęcia, którymi posługuje się Anthropic. Self-hosted sandboxy – wprowadzone wcześniej – przenosiły wykonanie narzędzi na maszyny klienta, ale pętla agenta (czyli decyzje modelu i orkiestracja) wciąż działała po stronie Anthropica. Nowe rozwiązanie idzie o krok dalej: self-hosted Managed Agents to przeniesienie całej usługi – serwera, bazy danych, workerów, sandboksów i przechowywania stanu – do środowiska kontrolowanego przez klienta.

    Architektura opiera się na modelu kolejki zadań. Aplikacja tworzy sesję, worker klienta pobiera zadanie, ściąga umiejętności agenta i pamięć sesji, a następnie wykonuje wywołania narzędzi lokalnie. Model – działający po stronie Anthropica lub innego dostawcy – podejmuje decyzje, ale to klient decyduje, gdzie fizycznie wykonują się polecenia powłoki, operacje na plikach czy dostęp do wewnętrznych serwisów.

    Konfiguracja deweloperska, opisana w dokumentacji quickstart, używa Docker Compose i stawia całość na jednej maszynie z PostgreSQL, workerami i kontenerami sandboksów. Wymagania sprzętowe są skromne – minimum dwa rdzenie CPU, x86-64 lub ARM. Produkcyjne wdrożenie wymaga standardowej pracy platform engineering: skalowania workerów, hardeningu obrazów, monitoringu i zarządzania sekretami.

    Co to zmienia dla zespołów developerskich

    Dla programistów i osób zarządzających infrastrukturą nowa opcja otwiera szereg możliwości. Agenci mogą działać bezpośrednio na prywatnych repozytoriach, uruchamiać buildy, testy i migracje w kontrolowanych środowiskach, a także korzystać z wewnętrznych serwerów MCP i niestandardowych obrazów kontenerów. Sesje i historia pozostają w firmowych bazach, co ułatwia audyt i zgodność z regulacjami.

    Jednakże, przejmując usługę, zespół staje się odpowiedzialny za jej utrzymanie – od aktualizacji po izolację sesji i rotację poświadczeń. Anthropic nie zarządza już runtime’em, więc DevOps musi samodzielnie zadbać o niezawodność całego stosu.

    Granice kontroli i bezpieczeństwa

    Choć samodzielny hosting daje dużą władzę nad infrastrukturą, granica modelu wciąż ma znaczenie. W architekturze self-hosted sandboxów dane wejściowe i wyniki narzędzi wracają do Managed Agents, aby model mógł zdecydować o kolejnym kroku. Oznacza to, że organizacja musi świadomie ocenić, co – jakie wyniki komend, zawartości plików czy dane uwierzytelniające – trafia do dostawcy modelu. Samodzielne hostowanie poprawia kontrolę nad przechowywaniem i środowiskiem wykonawczym, ale nie tworzy automatycznie hermetycznej bańki informacyjnej.

    Anthropic dostarcza narzędzia do ograniczenia tego ryzyka: klient definiuje zasady ruchu sieciowego dla workerów, wybiera obrazy runtime’u i zarządza poświadczeniami. Izolacja między sesjami również leży po stronie wdrażającego.

    Trzy drogi do wyboru

    Dokumentacja Anthropica przedstawia trzy kombinacje wdrożeniowe: wszystko po stronie Anthropica, sandboksy u klienta przy zachowaniu usługi u Anthropica oraz pełny self-hosting z wyborem dostawcy modelu. Nowość z 12 listopada to właśnie ta trzecia ścieżka – organizacja przejmuje nie tylko wykonanie, ale i orkiestrację oraz przechowywanie stanu.

    Dla firm budujących wewnętrzne agenty do automatyzacji DevOps czy systemy działające na regulowanych danych, to przesunięcie oznacza więcej obowiązków, ale także znacznie większą swobodę. Anthropic dostarcza technologię i łączność z modelem – reszta leży po stronie klienta.
    Źródła

  • Trzej giganci w wyścigu agentów AI: Cursor, Claude i OpenAI wydają autorskie SDK

    Trzej giganci w wyścigu agentów AI: Cursor, Claude i OpenAI wydają autorskie SDK

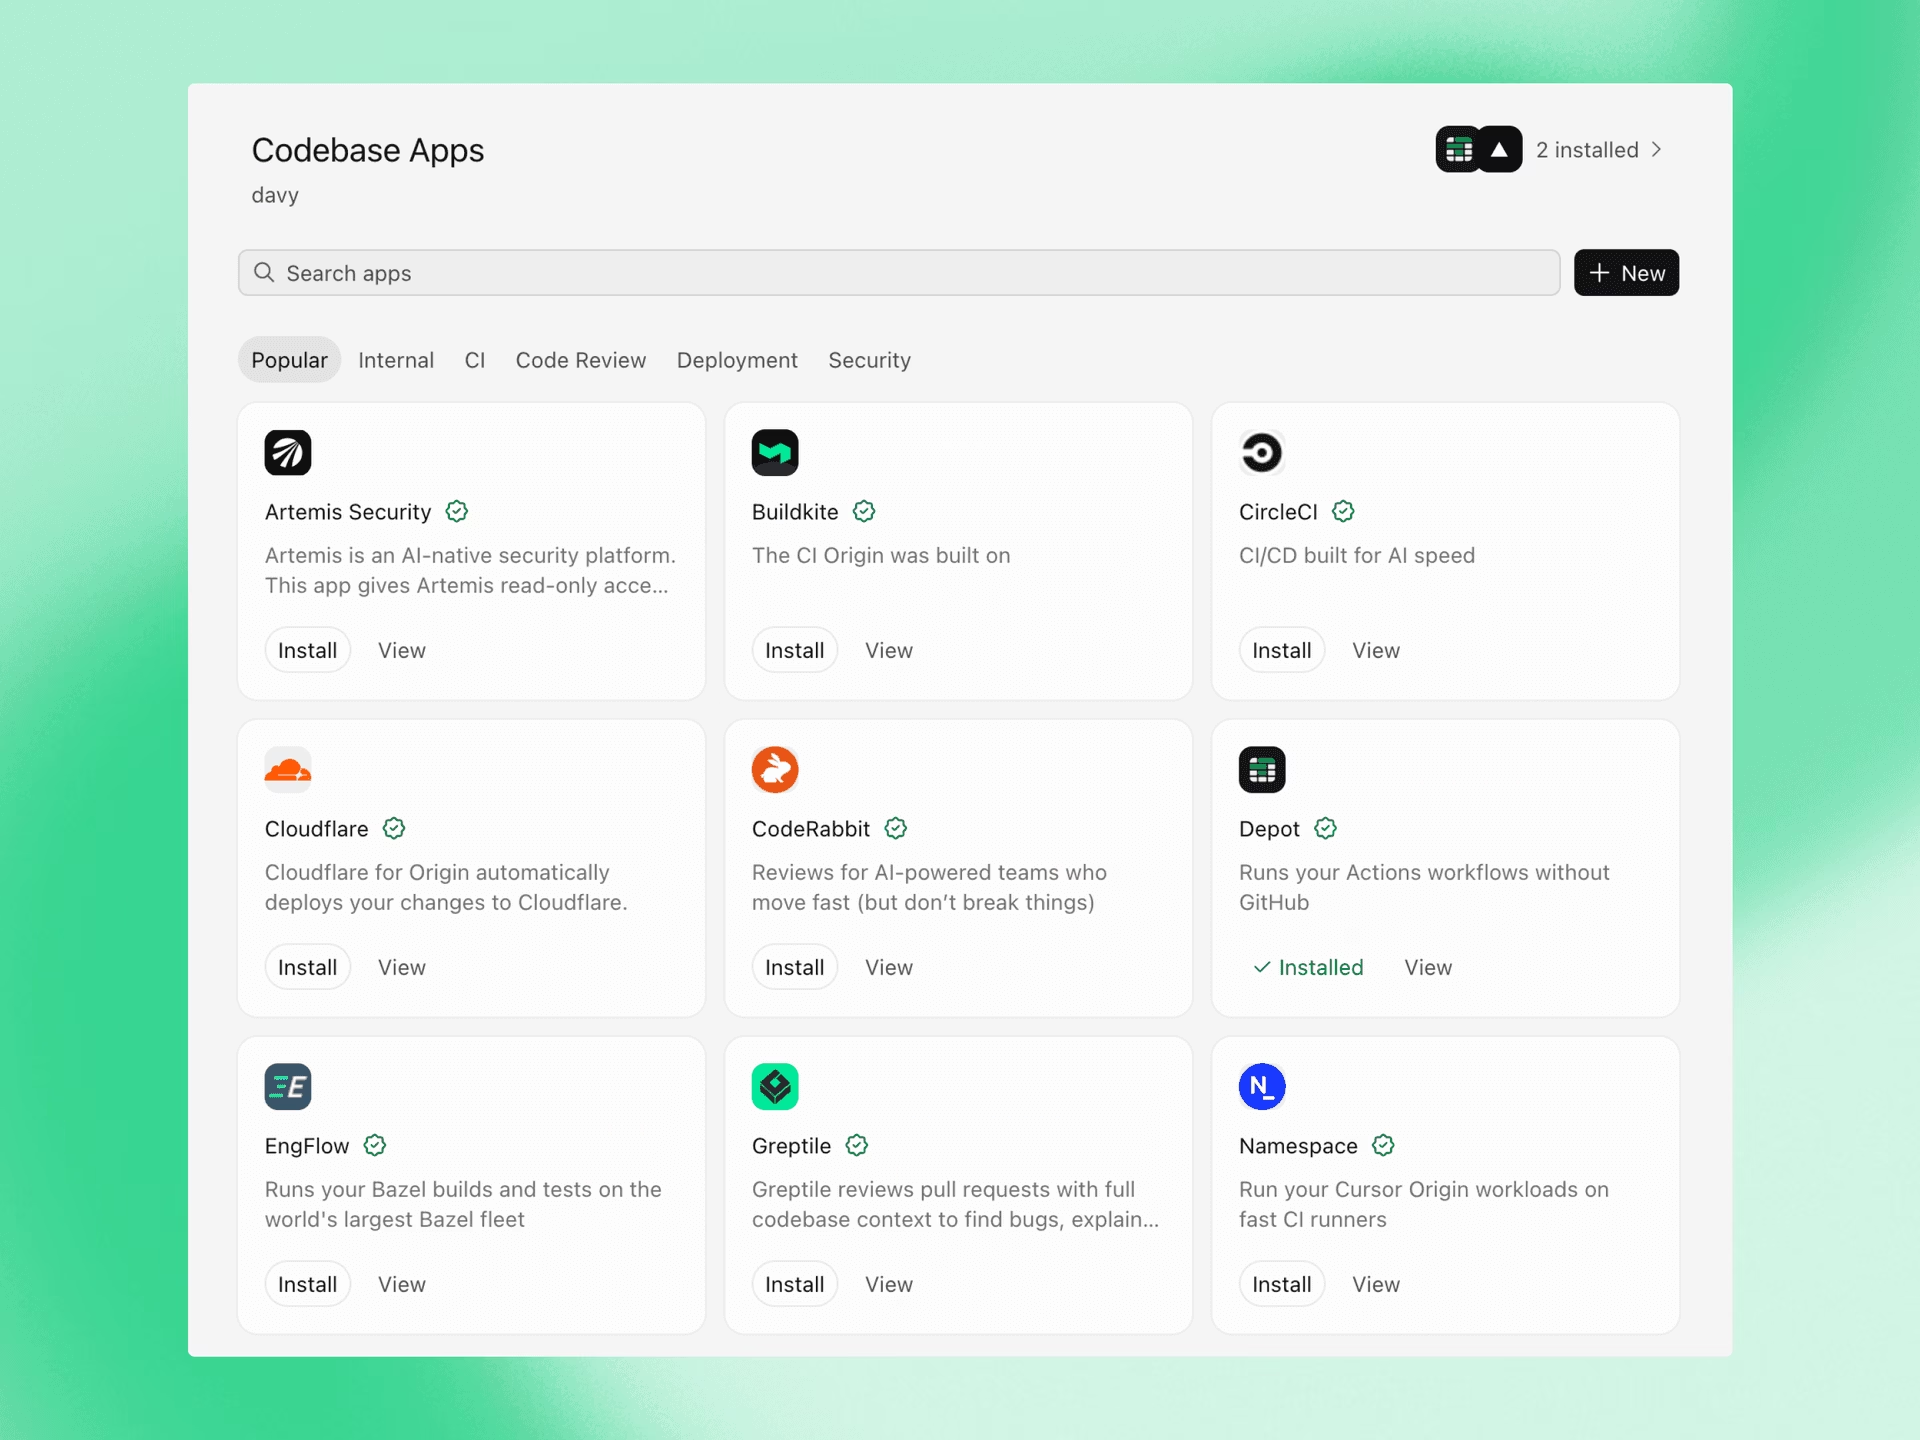
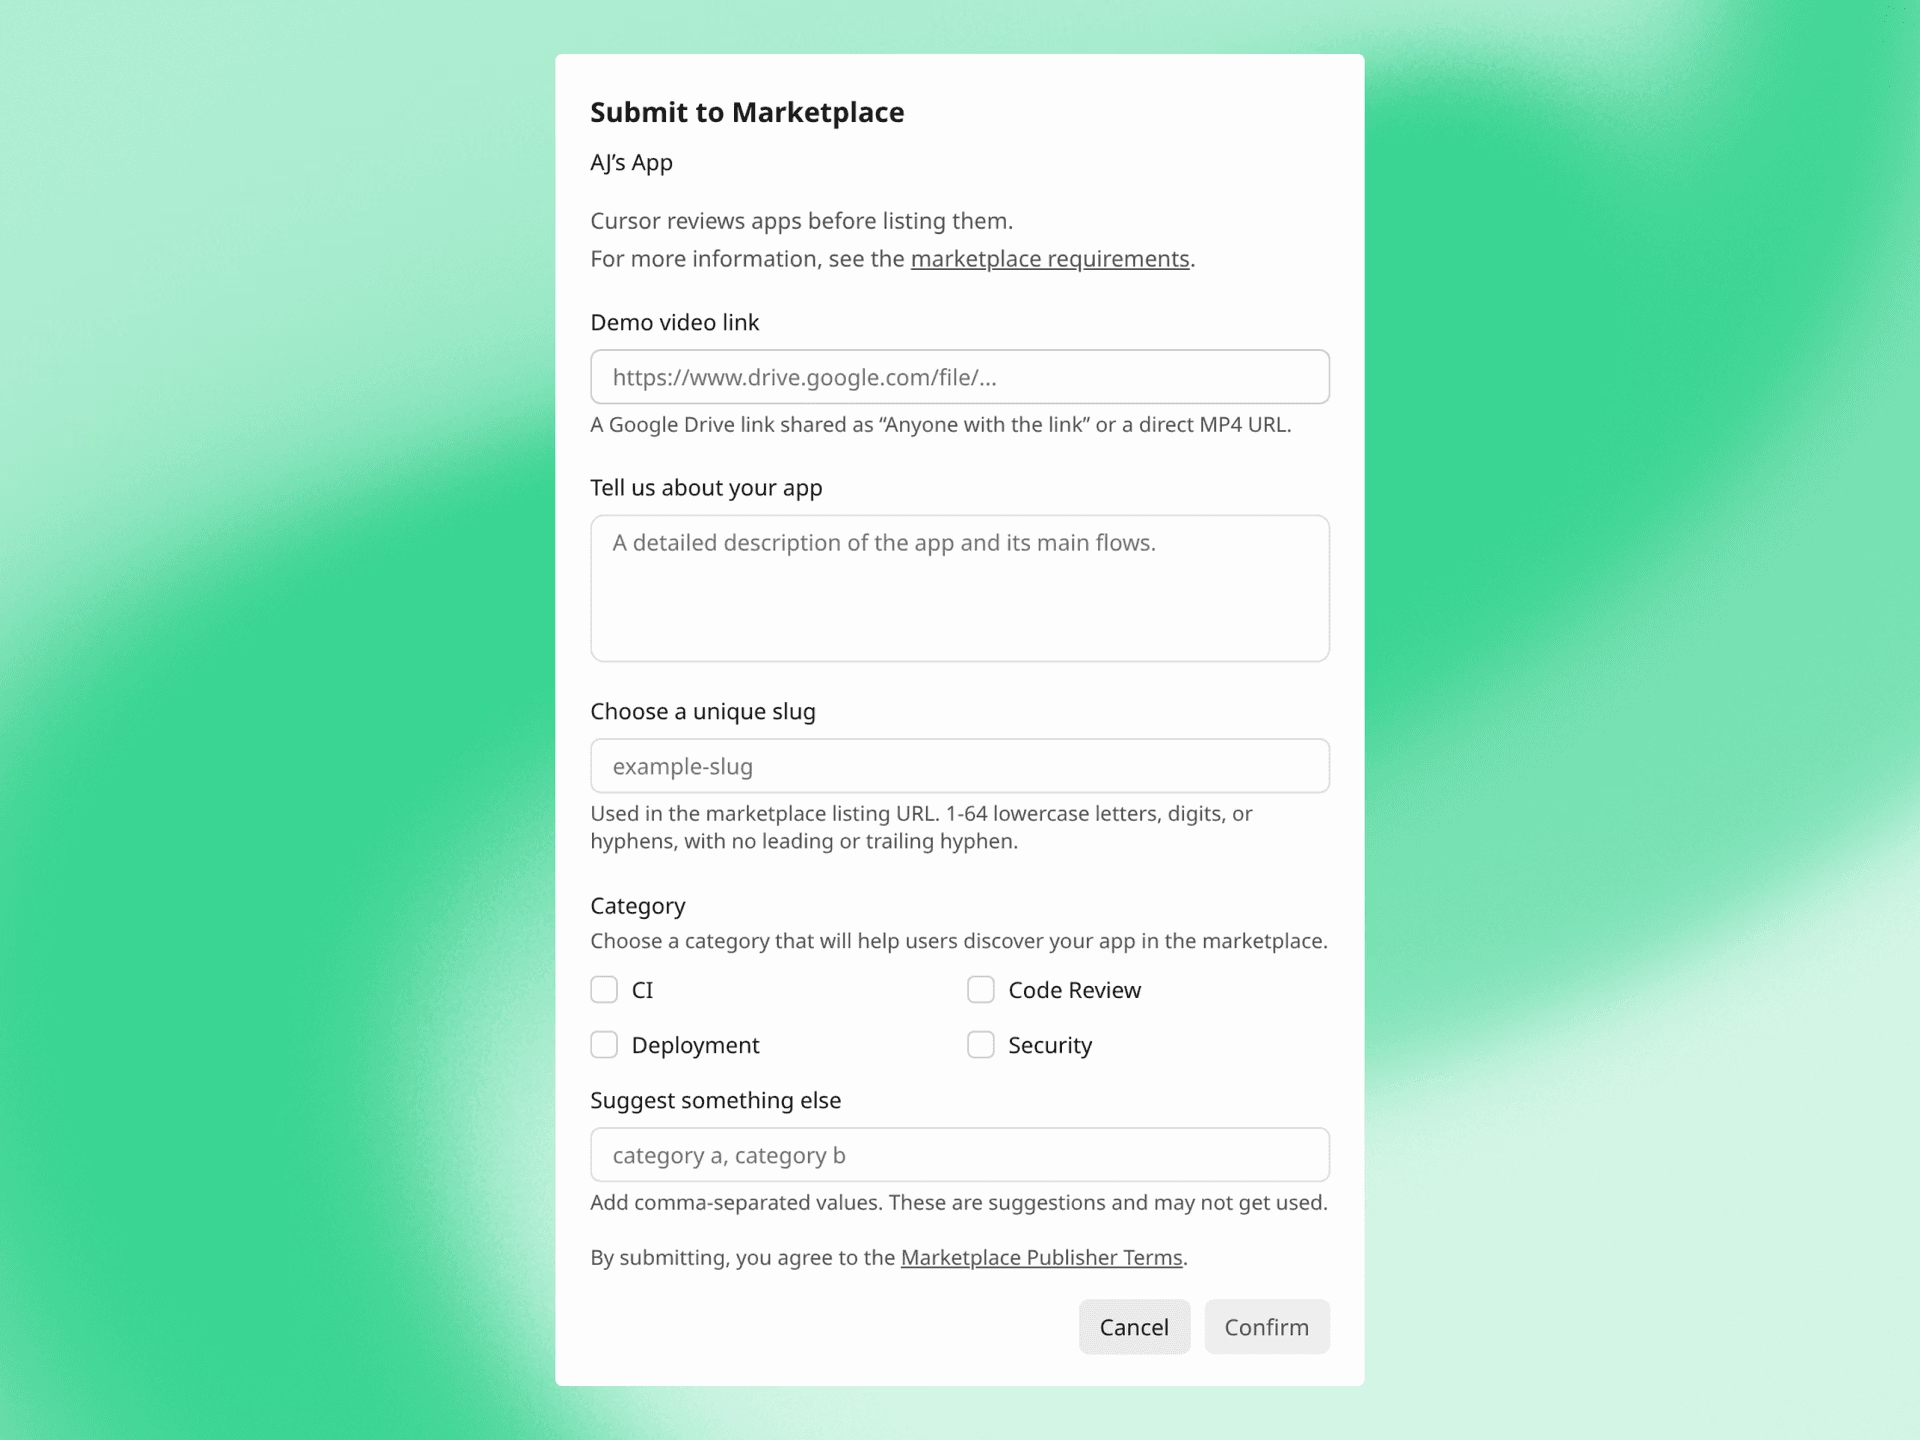
    20 października 2026 roku Cursor wprowadził publicznie Agent SDK – framework do tworzenia własnych agentów kodujących, który wcześniej był używany tylko wewnętrznie. To nie jest jedyny taki krok. W ostatnich tygodniach Anthropic oraz OpenAI również rozszerzyły swoje zestawy narzędzi dla agentów, co zmienia sposób automatyzacji procesów developerskich. Wszystkie trzy SDK mają na celu przekształcenie agenta z chatbota w długodziałającą jednostkę programistyczną osadzoną w repozytorium.

    Co się zmienia: kluczowe fakty

    • Cursor udostępnił Agent SDK, który obsługuje jego wewnętrzne boty (Bugbot, Security Reviewer, Rollouts) dla zewnętrznych zespołów.
    • Anthropic rozbudował Agent SDK dla Claude Code, dodając sesje, hooki, podagentów, MCP, uprawnienia, umiejętności i pamięć.
    • OpenAI wzbogacił swoje Agents SDK o natywne sandboxi oraz abstrakcję Manifestu, która opisuje workspace agenta.
    • Agent to folder kodu z instrukcjami, narzędziami i testami, a nie monolityczny prompt.
    • Cursor i Anthropic kładą nacisk na testowalność i odtwarzalność zachowania agenta; OpenAI również oferuje funkcje w tym zakresie.

    Agent jako projekt, nie prompt

    Agent SDK od Cursora opiera się na zasadzie, że agent to lokalny folder z kodem. W pliku instructions.md zapisany jest główny prompt, w katalogu tools/ definiuje się dostępne akcje, skills/ przechowuje procedury ładowane na żądanie, a channels/ określa źródła zdarzeń. Katalog mcp-connections/ służy do dodawania narzędzi z serwerów MCP. Deweloper uruchamia agenta lokalnie przez agent-sdk dev, testuje go za pomocą zestawu ewaluacji (agent-sdk eval), a następnie wdraża na infrastrukturę Cursora lub własną.

    Ciekawym elementem jest system ewaluacji. Eval wysyła do agenta stałą wiadomość i sprawdza nie tylko treść odpowiedzi, ale także, które narzędzia zostały wywołane, z jakimi parametrami i czy cały workflow się zakończył. Cursor potwierdza komendy agent-sdk dev, agent-sdk eval, agent-sdk validate, agent-sdk info i agent-sdk deploy, jednak funkcja odtwarzania PR-ów jako podpisanych webhooków nie została potwierdzona w oficjalnych materiałach.

    Anthropic w swoim Agent SDK dla Claude Code podąża podobną drogą, ale z innym akcentem. Duży nacisk kładzie na obserwowalność – dokumentacja potwierdza sesje, hooki, podagentów, MCP, uprawnienia, umiejętności i pamięć. Nie potwierdzono jednak w źródłach checkpointów plików, integracji z OpenTelemetry ani śledzenia kosztów. Deweloper może przechwytywać zachowanie agenta przez hooki, co daje kontrolę nad każdym etapem pętli agentowej.

    OpenAI postawiło na piaskownice. W zaktualizowanym Agents SDK agenci działają w izolowanych środowiskach wykonawczych – mogą czytać i zapisywać pliki, instalować zależności, uruchamiać kod. SDK wprowadza abstrakcję Manifestu, która opisuje workspace agenta. Oficjalne materiały nie potwierdzają jednak konfigurowalnej pamięci, agentów głosowych opartych na GPT Realtime ani montowania danych z S3, GCS i R2 jako funkcji opisanej w artykule.

    Wyzwalacze zamiast czatu

    Wyzwalacze zamiast czatu
    Źródło: cursor.com

    Agent SDK Cursora został zaprojektowany jako system zdarzeniowy. Agent reaguje na pull requesty i komentarze z GitHuba – dostępne materiały potwierdzają kanały komunikacji, wdrażanie agentów oraz szablony dla PR autofixera, triagera Linear/Jira i agenta polityk ownerskich. Nie potwierdzają jednak pełnego zestawu integracji z GitLabem, Bitbucketem, Slackiem, cronem ani zdarzeniami CI. Sesja jest trwała – kolejne wiadomości w wątku PR czy Slacka wznawiają tę samą konwersację.

    To zmiana filozofii. Agent nie czeka na wezwanie w oknie czatu. Działa w tle repozytorium: przegląda PR-y, naprawia błędy zgłoszone przez CI, egzekwuje polityki ownerskie, triażuje zgłoszenia z Jiry czy Lineara. Zespoły web-dev i DevOps mogą zautomatyzować te powtarzalne czynności bez pisania własnych botów od podstaw.

    Cursor umożliwia także delegowanie zadań do agentów chmurowych – osobnych instancji działających na checkoutcie repozytorium, które tworzą branche, wprowadzają zmiany i zgłaszają pull requesty. Mechanizm agenta-nadzorcy, który może przeglądać konwersację, sprawdzać status i zatrzymywać inne instancje, nie został jednak potwierdzony w dostępnych materiałach.

    Bezpieczeństwo i ograniczenia

    Bezpieczeństwo i ograniczenia
    Źródło: cursor.com

    Producenci nie ukrywają, że agenci z dostępem do repozytoriów i zewnętrznych usług niosą ryzyko. Cursor ostrzega, że evale mogą wykonywać rzeczywiste narzędzia, więc przed uruchomieniem w środowisku testowym należy zabezpieczyć operacje zapisu. OpenAI separuje warstwę sterującą od piaskownicy wykonawczej, aby dane uwierzytelniające nie wyciekły do kodu generowanego przez model. Wszystkie trzy SDK oferują mechanizmy weryfikacji i walidacji przed wdrożeniem.

    Nie ma jeszcze informacji o wycenie. Cursor nie opublikował szczegółów dotyczących kosztów wdrożeń Agent SDK, ani nie podał wyników wydajnościowych czy metryk adopcji. Anthropic i OpenAI również nie ujawniają wszystkich szczegółów rozliczeniowych dla swoich agentowych rozszerzeń.

    Podsumowanie

    Sytuacja na rynku agentowych SDK przypomina wczesne dni chmury: infrastruktura dojrzała na tyle, aby przestać być wewnętrznym eksperymentem i stała się dostępna dla szerszego grona zespołów.


    Źródła

  • Claude z niewidzialnym podpisem – Anthropic rozszerza znakowanie tekstu na kolejne modele

    Claude z niewidzialnym podpisem – Anthropic rozszerza znakowanie tekstu na kolejne modele

    Anthropic wprowadził tekstowy znak wodny w modelach Claude Mythos 5, Opus 4.7 i Sonnet 4.6, co zostało ogłoszone w notatkach do platformy Claude opublikowanych 3 listopada 2026. To pierwsza tak szeroka implementacja tej technologii, obejmująca zarówno najnowsze, jak i starsze generacje modeli.

    Co warto wiedzieć o aktualizacji

    • Tekstowy watermark to niewidoczny wzorzec statystyczny osadzony w doborze słów, który nie dodaje tokenów ani ukrytych znaków.
    • Modele objęte zmianą to Claude Mythos 5, Claude Opus 4.7 oraz Claude Sonnet 4.6, zgodnie z dokumentacją platformy.
    • Sonnet 4.6 może stracić znak wodny, jeśli w zapytaniu API ustawiono niestandardowe wartości parametrów temperature, top_p lub top_k.
    • System nie przechowuje danych o użytkowniku – znak wodny nie zawiera informacji o osobie, organizacji ani pochodzeniu zapytania.
    • Wykrywanie działa probabilistycznie – wskazuje prawdopodobieństwo udziału Claude'a, ale nie daje absolutnej pewności autorstwa.

    Jak działa mechanizm znakowania

    Anthropic opisuje watermark jako „niewidoczny wzorzec w doborze słów”. Nie zmienia on znaczenia, jakości ani czytelności generowanego tekstu. Nie pojawia się jako etykieta, specjalny znak czy pole metadanych – jest osadzony bezpośrednio w strukturze wypowiedzi modelu.

    Co istotne, system działa na poziomie samego modelu, a nie pojedynczej aplikacji. Oznacza to, że tekst wygenerowany przez Claude API, aplikację Claude, Claude Code, Claude Cowork czy Claude Tag będzie zawierał ten sam typ oznaczenia. Dla zespołów deweloperskich ma to znaczenie przy generowaniu dokumentacji, komentarzy w kodzie, commit message'ów czy treści na blogi – wszystko, co przechodzi przez Claude'a, potencjalnie nosi ten niewidzialny podpis.

    Pułapka w parametrach API

    Największą uwagę przykuwa zastrzeżenie dotyczące Claude Sonnet 4.6. Anthropic informuje, że ustawienie któregokolwiek z parametrów próbkowania – temperature, top_p lub top_k – na wartość inną niż domyślna może wyłączyć watermark.

    Problem jest szczególnie istotny dla narzędzi do vibe codingu, frameworków agentowych i bibliotek klienckich. Często ustawiają one te parametry automatycznie, więc deweloper może nieświadomie generować tekst bez znaku wodnego, nawet jeśli sam nie zmieniał żadnych ustawień. Anthropic zaleca pomijanie tych trzech parametrów, jeśli zespół polega na detekcji watermarku w Sonnecie 4.6.

    Kontekst regulacyjny i praktyczne ograniczenia

    Firma łączy rozszerzenie znakowania z wymogami przejrzystości narzuconymi przez unijny AI Act. Podkreśla, że watermark działa globalnie – nie tylko dla użytkowników podlegających europejskim regulacjom. To ruch wyprzedzający, ale także sygnał dla branży: podobne rozwiązania wdrażają już inni duzi dostawcy modeli AI.

    Warto jednak zrozumieć, czego watermark nie gwarantuje. Wykrycie wzorca może sugerować, że Claude brał udział w tworzeniu tekstu, ale nie wskaże konkretnej osoby, organizacji ani promptu. Nie odpowie też na pytanie, czy człowiek później znacząco edytował treść. Tekst bez znaku wodnego nie jest dowodem na brak udziału Claude'a, zwłaszcza przy zmienionych parametrach API lub późniejszej obróbce.

    Anthropic podkreśla, że to raczej sygnał probabilistyczny niż twardy dowód. Mimo to dla wydawców i zespołów technicznych pracujących z dużymi wolumenami generowanego tekstu – od CMS-ów po repozytoria kodu – ta aktualizacja wprowadza nową warstwę identyfikowalności, która wcześniej po prostu nie istniała.


    Źródła

  • Anthropic udostępnia API do analityki użycia i kosztów w wersji beta

    Anthropic udostępnia API do analityki użycia i kosztów w wersji beta

    Anthropic wprowadził w wersji beta Usage and Cost Analytics API, nowy zestaw endpointów, który umożliwia organizacjom korzystającym z Claude Console i Claude Enterprise dostęp do szczegółowych danych dotyczących zużycia tokenów oraz wydatków. Użytkownicy mogą teraz korzystać z elastycznego narzędzia do filtrowania i grupowania danych według modelu, workspace'a czy klucza API, zamiast polegać na sztywnych, predefiniowanych raportach.

    Najważniejsze fakty

    • Nowe endpointy /v1/organizations/analytics/usage i /v1/organizations/analytics/cost zwracają dane o tokenach i kosztach w USD.
    • API wymaga nagłówka beta anthropic-beta: analytics-usage-cost-2026-08-24 oraz klucza z uprawnieniem read:analytics.
    • Stare endpointy – Usage and Cost API oraz raporty Enterprise Analytics – przechodzą do statusu legacy.
    • Grupowanie możliwe jest po wymiarach takich jak model, workspace, klucz API czy użytkownik.
    • Dane kosztowe raportowane są w dolarach amerykańskich z możliwością podziału na przedziały czasowe.

    Co dokładnie mierzy nowe API

    Endpoint Usage pokazuje liczbę tokenów i żądań w wybranym zakresie dat. API potrafi rozbić zużycie na kategorie tokenów wejściowych – zwykłych, użytych do tworzenia cache oraz odczytanych z cache – oraz tokenów wyjściowych. Dodatkowo, dostarcza liczbę żądań.

    Endpoint Cost działa podobnie, ale operuje na kwotach w dolarach. Oba endpointy wspierają parametr time_bucket_width, co pozwala na grupowanie danych w interwały czasowe – godziny, dni, czy inne, które pasują do wewnętrznych raportów. Duże odpowiedzi API są obsługiwane przez paginację, co eliminuje ryzyko, że zapytanie utknie na wielomiesięcznym zakresie danych.

    Wynik to jedna linia na każdą kombinację wymiarów z aktywnością w zadanym okresie. Jeśli nie podasz żadnego grupowania, otrzymasz jeden zagregowany wiersz.

    Koniec starych raportów

    Anthropic oznaczył poprzednie API jako legacy. Dotyczy to zarówno całego Usage and Cost API, jak i czterech konkretnych endpointów Enterprise Analytics: usage_report, cost_report, user_usage_report oraz user_cost_report.

    Stare endpointy nadal działają, ale zespół Anthropic zachęca do migracji. Dla zespołów DevOps to sygnał, że nowe dashboardy, systemy chargebacków i alerty budżetowe warto budować na nowym API. Stare integracje mogą jeszcze funkcjonować, ale kierunek rozwoju jest jasny.

    Przejście z kilku osobnych raportów na dwa endpointy analityczne upraszcza architekturę po stronie klienta. Zamiast osobnych zapytań o raport organizacyjny, per-user i per-koszt, można teraz korzystać z jednego źródła i wybierać tylko te wymiary, które są naprawdę potrzebne.

    Dlaczego to ma znaczenie dla zespołów technicznych

    Największą zmianą jest możliwość integracji danych tokenowych i kosztowych bezpośrednio z istniejącym toolchainem. Monitoring, FinOps, pipeline'y CI/CD – wszystko, co już działa w organizacji, może teraz korzystać z tych danych bez konieczności ręcznego eksportowania CSV z konsoli.

    Grupowanie po kluczu API, workspace lub tożsamości serwisowej jest szczególnie przydatne. Umożliwia to powiązanie wydatków na Anthropic z konkretnymi aplikacjami, środowiskami czy zespołami. Choć API nie jest jeszcze w pełni zgodne ze specyfikacją FOCUS, kierunek rozwoju jest zbieżny z innymi platformami chmurowymi.

    API jest w fazie beta, co oznacza, że mogą wystąpić zmiany przed stabilizacją interfejsu. Integracje produkcyjne powinny być przygotowane na aktualizacje, zanim Anthropic zakończy fazę beta. Mimo to, kierunek jest jasny: precyzyjna kontrola kosztów AI staje się standardem dostępnym przez API, a nie tylko przywilejem największych klientów.


    Źródła

  • Claude Opus 5 zadebiutował z milionowym oknem kontekstu i domyślnym myśleniem

    Claude Opus 5 zadebiutował z milionowym oknem kontekstu i domyślnym myśleniem

    Anthropic wprowadził 24 lipca 2026 roku nowy model językowy Claude Opus 5, który wprowadza znaczące zmiany techniczne w porównaniu do poprzedniej wersji. Model ten charakteryzuje się większymi możliwościami przy niższych kosztach. Jest dostępny przez API Claude’a oraz na głównych platformach chmurowych.

    • Claude Opus 5 oferuje domyślnie 1 milion tokenów kontekstu i do 128 tysięcy tokenów wyjściowych.
    • Myślenie działa od razu po wywołaniu – model sam decyduje, kiedy poświęcić dodatkową moc obliczeniową na trudniejsze zadania.
    • Cennik pozostał bez zmian: 5 dolarów za milion tokenów wejściowych i 25 dolarów za milion wyjściowych.
    • Model jest dostępny w API Claude, Amazon Bedrock, Google Cloud oraz Microsoft Foundry.
    • Identyfikator modelu to claude-opus-5, a data graniczna wiedzy przypada na maj 2026 roku.

    Co naprawdę zmieniło się względem Claude Opus 5

    Najważniejszą nowością jest ogromne okno kontekstu – milion tokenów pozwala zmieścić w jednym zapytaniu całe repozytorium kodu, rozbudowaną dokumentację czy wieloetapową historię zadań agenta. Warto jednak przemyśleć, co faktycznie trafia do promptu, aby uniknąć wysokich kosztów tokenów i opóźnień.

    Domyślne myślenie to kolejna nowość. Model ocenia, czy zadanie wymaga głębszej analizy i przeznacza na nie dodatkowy czas obliczeniowy. Przy prostych pytaniach działa szybko, natomiast przy bardziej złożonych zadaniach, takich jak kodowanie czy planowanie, przechodzi w tryb rozumowania bez potrzeby dodatkowej konfiguracji ze strony programisty. 128 tysięcy tokenów outputu umożliwia generowanie długich fragmentów kodu lub szczegółowych analiz technicznych bez dzielenia odpowiedzi na części.

    Znaczenie dla web developerów i DevOps

    Znaczenie dla web developerów i DevOps

    Dla osób pracujących w web developmencie i vibe codingu kluczowe jest rozszerzone okno kontekstu. Można wprowadzić do promptu kod źródłowy z wielu plików, wyniki testów, logi błędów i konfigurację wdrożeniową w jednym ciągu. Agent kodujący zyskuje szerszy obraz sytuacji, co pozwala uniknąć gubienia wątków po kilku interakcjach.

    Z perspektywy DevOps model sprawdzi się przy przeglądaniu repozytoriów infrastructure-as-code, analizie incydentów na podstawie obszernych logów oraz generowaniu konfiguracji CI/CD. Długie odpowiedzi umożliwiają stworzenie kompletnego pliku Terraform lub manifestu Kubernetesa bez potrzeby łączenia fragmentów. Wsparcie dla Bedrock, Google Cloud i Microsoft Foundry ułatwia także dostęp do modelu w ramach istniejących polityk bezpieczeństwa organizacji.

    Ile to kosztuje przy pełnym kontekście

    Ile to kosztuje przy pełnym kontekście

    Przy maksymalnym wykorzystaniu okna kontekstu pojedyncze zapytanie z milionem tokenów wejściowych kosztuje 5 dolarów, a wygenerowanie miliona tokenów outputu – 25 dolarów. To wartości graniczne, które nie są zalecane jako standardowe rozmiary promptów. W praktyce koszty mogą szybko rosnąć, szczególnie gdy agenci wielokrotnie przesyłają zawartość repozytorium i wyniki narzędzi w pętli.

    Anthropic utrzymał ceny z modelu Claude Opus 5, mimo że nowy model oferuje wyraźnie większe możliwości. Późniejsza wersja Claude Opus 5 już otrzymała niższe stawki – 4 dolary za milion tokenów wejściowych i 20 za milion wyjściowych – co wskazuje na kierunek ewolucji cenowej w nadchodzących miesiącach.

    Ryzyka i ograniczenia

    Mimo zapowiedzi dotyczących drabiny wysiłku i zmian narzędzi w trakcie konwersacji, dostępna dokumentacja potwierdza przede wszystkim podstawowe parametry: okno kontekstu, domyślne myślenie, limit outputu, ceny i dostępność na platformach chmurowych. Niektóre funkcje, takie jak zarządzanie Claude Managed Agents czy serwerowe fallbacki, mogą pochodzić z osobnych notatek do platformy, a nie z głównego ogłoszenia modelu.

    Warto także sprawdzić aktualność dat – dokumentacja techniczna Anthropica często wyprzedza publikację wielu raportów branżowych. Przed wdrożeniem Claude Opus 5 w produkcji należy zweryfikować, czy parametry i limity nie uległy zmianie po premierze wersji Claude Opus 5. Model, w oparciu o dostępne informacje, stanowi solidny krok naprzód – zwłaszcza dla zespołów, które potrzebują jednego, spójnego kontekstu do pracy z dużymi bazami kodu.


    Źródła

  • Claude Managed Agents zyskują poziomy wysiłku, webhooki i seeding sesji

    Claude Managed Agents zyskują poziomy wysiłku, webhooki i seeding sesji

    Anthropic wprowadził 22 lipca 2026 roku aktualizację Claude Managed Agents, która zmienia sposób pracy z zarządzanymi agentami. Deweloperzy zyskali nowe narzędzia do kontrolowania intensywności rozumowania agenta, uruchamiania zadań natychmiast po utworzeniu sesji oraz reagowania na zdarzenia cyklu życia bez potrzeby ciągłego odpytywania API. Te zmiany mają znaczący wpływ na koszty operacyjne i architekturę integracji.

    Kluczowe fakty

    • Konfigurowalny poziom wysiłku – parametr effort w konfiguracji modelu agenta kontroluje głębokość rozumowania; niższe wartości zazwyczaj prowadzą do szybszych odpowiedzi przy niższym koszcie.
    • Webhooki dla środowisk i pamięci – cztery zdarzenia środowiskowe i trzy zdarzenia magazynu pamięci umożliwiają automatyzację procesów związanych z deploymentem, czyszczeniem i synchronizacją.
    • Seeding sesji – POST /v1/sessions przyjmuje teraz do 50 początkowych zdarzeń w polu initial_events, typu user.message i user.define_outcome, co uruchamia pętlę agenta w momencie utworzenia sesji.
    • Event deltas w strumieniach – parametry event_deltas[] pozwalają na stopniowe pobieranie treści zdarzeń w strumieniu sesji oraz strumieniach wątków agentów podrzędnych; obejmują zdarzenia event_start i event_delta, które umożliwiają podgląd tekstu przed nadejściem pełnego zdarzenia agent.message.
    • Elastyczne wersjonowanie agentów – aktualizacje wprowadzają nowe funkcje wersjonowania.

    Konfigurowalny wysiłek – kiedy szybciej znaczy taniej

    Nowy parametr effort, umieszczany w konfiguracji model agenta, to prosty sposób na dostosowanie kosztów do wymagań zadania. Niższy wysiłek sprawdza się w rutynowych operacjach – agent odpowiada szybciej, a koszty związane z tokenami są zazwyczaj mniejsze, chociaż ostateczny koszt zależy od konkretnego modelu, liczby tokenów i charakterystyki zadania. Wyższy poziom warto zarezerwować dla bardziej złożonych analiz, gdzie głębsze rozumowanie przekłada się na lepsze wyniki.

    To zmiana, która może nie być zauważalna w dokumentacji, ale może znacząco wpłynąć na miesięczne rozliczenia. Zespoły zarządzające wieloma agentami w środowiskach produkcyjnych mogą teraz świadomie decydować, które zadania wymagają pełnej mocy modelu.

    Webhooki zamiast pollingu

    Rozszerzenie webhooków o zdarzenia cyklu życia środowisk (environment.created, environment.updated, environment.archived, environment.deleted) oraz magazynów pamięci (memory_store.created, memory_store.archived, memory_store.deleted) eliminuje potrzebę ciągłego odpytywania API.

    Dla zespołów infrastrukturalnych oznacza to możliwość integracji procesów związanych z deploymentem, czyszczeniem zasobów, indeksowaniem czy unieważnianiem cache bezpośrednio z zdarzeniami cyklu życia. To koniec z pisaniem kodu, który co 30 sekund sprawdza, czy zaszły jakieś zmiany.

    Seeding sesji i strumieniowanie delta

    Mechanizm seeding zmienia sposób, w jaki agenci są uruchamiani. Zamiast tworzyć pustą sesję i następnie wysyłać pierwszą wiadomość, można dostarczyć początkowe zdarzenia już w momencie tworzenia sesji przez POST /v1/sessions, przekazując je w polu initial_events. Limit wynosi 50 zdarzeń, które mogą mieć tylko typy user.message i user.define_outcome.

    W praktyce oznacza to, że agent może rozpocząć pracę natychmiast, z predefiniowanymi instrukcjami lub oczekiwanymi rezultatami. Jest to szczególnie przydatne w systemach orkiestracji zadań, gdzie sesja jest tworzona automatycznie przez inny komponent.

    Z kolei event deltas, dostępne przez parametr event_deltas[] na strumieniu zdarzeń sesji oraz endpointach strumieniowych wątków, rozwiązują problem podglądu częściowych wyników. Zamiast czekać na pełne zdarzenie, klient otrzymuje przyrostowe fragmenty treści w trakcie ich generowania – zdarzenia event_start i event_delta umożliwiają podgląd tekstu przed nadejściem pełnego agent.message. To przydaje się do pokazywania postępów agenta w interfejsie webowym, aktualizacji wskaźników podczas długotrwałych zadań oraz zmniejszania odczuwalnego opóźnienia.

    Zmiany w Memory API

    Aktualizacja wprowadza nowy nagłówek beta agent-memory-2026-07-22 dla endpointów magazynu pamięci, zastępujący managed-agents-2026-04-01. Wysłanie obu nagłówków jednocześnie skutkuje błędem 400. Warto jednak wiedzieć, że tego samego dnia starszy nagłówek managed-agents-2026-04-01 przyjął takie samo zachowanie listowania pamięci, więc nie wszystkie opisane zmiany wymagają przejścia na nowy nagłówek. Dodatkowo order_by i order są teraz ignorowane, depth akceptuje tylko 0, 1 lub wartość pominiętą, a path_prefix musi kończyć się ukośnikiem i dopasowuje pełne segmenty ścieżki.

    Co to znaczy w codziennej pracy

    Zmiany z 22 lipca odpowiadają na konkretne wyzwania, z jakimi borykają się zespoły dev ops i web dev – koszty operacyjne, responsywność integracji oraz czas uruchamiania agentów. Konfigurowalny wysiłek pozwala na kontrolę wydatków, webhooki umożliwiają budowanie infrastruktury reagującej na zdarzenia, a seeding sesji upraszcza orkiestrację. Aktualizacja wprowadza także możliwość użycia do 500 umiejętności (skills) na sesję, co zwiększa elastyczność konfiguracji. Projektanci integracji muszą jednak pamiętać, że webhooki nie dostarczają pełnych danych obiektów i wymagają osobnych żądań GET po szczegóły.


    Źródła

  • Koniec legacy Workbench i eksperymentalnych narzędzi do promptów — Anthropic wyznacza datę na 17 sierpnia 2026

    Koniec legacy Workbench i eksperymentalnych narzędzi do promptów — Anthropic wyznacza datę na 17 sierpnia 2026

    Anthropic ogłosiło, że wycofa starszy interfejs Workbench w Claude Console oraz trzy eksperymentalne endpointy API do pracy z promptami. Termin zamknięcia dostępu wyznaczono na 17 sierpnia 2026 roku. Po tej dacie zarówno interfejs, jak i API przestaną działać, a zapisane dane staną się niedostępne. Zespoły deweloperskie, które oparły swoje przepływy pracy na tych narzędziach, powinny podjąć działania już teraz.

    Najważniejsze informacje

    • Anthropic zamyka legacy Workbench i trzy eksperymentalne API do promptów 17 sierpnia 2026 roku
    • Zapisane prompty, zmienne i ewaluacje nie są przenoszone do nowego Workbencha — trzeba je wyeksportować ręcznie
    • Endpointy /v1/experimental/generate_prompt, /improve_prompt i /templatize_prompt po wycofaniu będą zwracać błędy
    • Nowy Workbench jest bezstanowy — nie przechowuje danych na serwerach Anthropic i nie oferuje zamienników dla wycofywanych funkcji API
    • Zespoły DevOps i web dev muszą przejrzeć skrypty CI/CD i narzędzia wewnętrzne pod kątem wywołań do starych endpointów

    Co dokładnie znika

    Wycofanie obejmuje dwie powiązane części ekosystemu Anthropic. Pierwsza to legacy Workbench, dostępny pod adresem platform.claude.com/workbench, który służył do tworzenia promptów, definiowania zmiennych i uruchamiania ewaluacji. Nowi użytkownicy nie mieli do niego dostępu od pewnego czasu, ale dotychczasowi wciąż mogli z niego korzystać. To się zmieni 17 sierpnia 2026.

    Druga część to trzy eksperymentalne endpointy API, które od początku były oznaczone jako „eksperymentalne”, co oznaczało brak gwarancji długoterminowego wsparcia. Teraz ta etykieta nabiera konkretnego znaczenia:

    • POST /v1/experimental/generate_prompt — generował prompt na podstawie opisu zadania
    • POST /v1/experimental/improve_prompt — poprawiał istniejący prompt z wykorzystaniem technik chain-of-thought
    • POST /v1/experimental/templatize_prompt — przekształcał prompt w szablon z możliwością wielokrotnego użycia ze zmiennymi

    Po dacie wycofania każdy request do tych endpointów zwróci błąd. Nie będzie przekierowania ani okresu przejściowego. Anthropic nie dostarcza też bezpośrednich zamienników API — funkcjonalność po prostu znika.

    Dane, które trzeba uratować

    To najpilniejsza sprawa dla każdego, kto korzystał z legacy Workbencha. Wszystkie zapisane prompty, zmienne i konfiguracje ewaluacji nie przechodzą automatycznie do nowego interfejsu. Gdy stara wersja zostanie wyłączona, dane przepadną.

    Eksport można wykonać na dwa sposoby: przez baner widoczny w starym Workbenchu lub przez Ustawienia organizacyjne w Claude Console. Jest to szczególnie istotne dla zespołów, które zbudowały infrastrukturę testów regresyjnych na zapisanych ewaluacjach — nowy Workbench nie ma odpowiednika tej funkcji, więc trzeba znaleźć inne miejsce na testy.

    Warto również przejrzeć repozytoria kodu, skrypty budowania, narzędzia do automatyzacji promptów i wewnętrzne platformy deweloperskie. Wywołania do trzech eksperymentalnych endpointów mogą być ukryte głęboko w konfiguracjach CI/CD, gdzie łatwo je przeoczyć.

    Nowy Workbench — prostszy, ale uboższy

    Zastępczy interfejs jest celowo odchudzony. Nowy Workbench działa bezstanowo — nic nie jest przechowywane na serwerach Anthropic. Zbudowano go bezpośrednio na publicznym Messages API, co oznacza, że request skonstruowany w interfejsie jest dokładnie tym samym requestem, który można wysłać w kodzie produkcyjnym. Jedno kliknięcie eksportuje go jako snippet w Pythonie lub JavaScripcie.

    Czego nie ma: zapisanych promptów, zmiennych, ewaluacji. Nie ma też żadnego odpowiednika trzech wycofywanych endpointów na poziomie API. Anthropic pozycjonuje nowe narzędzie jako środowisko do testowania i debugowania, a nie platformę do zarządzania promptami.

    Dla zespołów, które używały legacy Workbencha jako lekkiego repozytorium promptów, naturalnym kierunkiem jest przeniesienie ich do Gita. Jeśli potrzebne jest wersjonowanie i zaawansowane ewaluacje, rynek oferuje dedykowane platformy — ale Anthropic samo w tym kierunku nie idzie.

    Co z kodem korzystającym ze starych endpointów

    Zespoły techniczne mają w zasadzie dwie opcje: usunąć wywołania do eksperymentalnych endpointów albo odtworzyć ich działanie za pomocą standardowego Messages API. Funkcjonalność improve_prompt jest nadal dostępna w nowym interfejsie Workbench, ale tylko przez UI — nie przez API.

    Dla zautomatyzowanych pipeline'ów poprawiania promptów jedyną drogą naprzód jest samodzielne zbudowanie warstwy, która wysyła prompt do Messages API z odpowiednim system promptem. To nie jest skomplikowane technicznie, ale wymaga czasu i testów — a terminu nie da się przesunąć.

    Podsumowanie

    17 sierpnia 2026 to ostateczny termin. Anthropic konsoliduje narzędzia wokół Messages API, a legacy Workbench i eksperymentalne endpointy do promptów nie pasują już do tej wizji. Dla deweloperów oznacza to konieczność ręcznego eksportu danych, audytu kodu i ewentualnego przepisania fragmentów automatyzacji. Im szybciej zespoły zaczną ten proces, tym mniejsze ryzyko, że w sierpniu 2026 coś istotnego zostanie utracone.


    Źródła

  • Claude zyskał komunikaty systemowe w środku rozmowy – większa kontrola nad agentami AI

    Claude zyskał komunikaty systemowe w środku rozmowy – większa kontrola nad agentami AI

    Anthropic wprowadził nową funkcję, która umożliwia deweloperom wstrzykiwanie komunikatów systemowych w trakcie rozmowy z modelami Claude. Ta opcja jest już dostępna przez API Claude’a oraz na platformach Amazon Bedrock i Google Cloud, obejmując modele Claude, Claude i Claude.

    Ta zmiana upraszcza kontrolowanie zachowania asystentów kodujących i długodziałających agentów AI, eliminując potrzebę przerywania cache’a promptów oraz przepisywania całej historii rozmowy.

    • Komunikaty systemowe można teraz umieszczać w dowolnym momencie rozmowy, a nie tylko na jej początku.
    • Późniejsze instrukcje mają pierwszeństwo przed wcześniejszymi, w tym nadpisują główne pole system.
    • Cache promptów pozostaje nienaruszony, co pozwala na dynamiczne zmiany kontekstu bez utraty wydajności.
    • Tymczasowe instrukcje na jedną turę są dostępne przez opcję clear_at: "next_user_message".
    • Enterprise Admin API pojawia się w dokumentacji jako mechanizm do zarządzania użytkownikami, rolami i grupami, chociaż szczegóły wdrożenia są nadal niejasne.

    Jak to działa technicznie

    Mechanizm jest prosty. Deweloper dodaje do tablicy messages nowy wpis z "role": "system" w miejscu, gdzie nowa instrukcja staje się istotna. Nie ma potrzeby edytowania głównego pola system na początku żądania.

    Przykład z dokumentacji wygląda następująco:

    {
      "role": "system",
      "content": "W tej turze użyj narzędzia do przeszukiwania repozytorium, zanim zaproponujesz zmianę w kodzie."
    }

    Istnieją jednak ograniczenia. Komunikat systemowy nie może być pierwszą wiadomością w konwersacji – musi pojawić się po turze użytkownika. Główne pole system jest przeznaczone do instrukcji obowiązujących od początku, podczas gdy komunikaty w trakcie rozmowy dotyczą tych, które nabierają znaczenia później.

    Nowe instrukcje nie unieważniają zapisanego cache’a promptów, co jest korzystne dla agentów działających przez dłuższy czas. Mogą one zmieniać tryb pracy, na przykład z planowania na implementację, bez konieczności przeliczania całego prefiksu.

    Tymczasowe instrukcje na jedną turę

    Tymczasowe instrukcje na jedną turę

    Opcja clear_at wprowadza dodatkowe możliwości. Ustawienie clear_at: "next_user_message" sprawia, że instrukcja działa tylko w bieżącej turze, a po następnej wiadomości użytkownika przestaje być aktywna. Zostaje w historii rozmowy, ale nie zużywa tokenów wejściowych.

    To przydatne w scenariuszach, takich jak tymczasowe przełączenie agenta kodującego w tryb przeglądu – „tylko recenzuj, nie modyfikuj plików” – lub wymuszenie odpowiedzi w formacie JSON na pojedyncze zapytanie, bez potrzeby edytowania głównych ustawień.

    Co to oznacza dla zespołów DevOps i enterprise

    Nowe komunikaty systemowe rozwiązują konkretny problem: jak zmieniać kontekst działania agenta bez utraty cache’a i produkowania długich, powtarzalnych promptów. Dla zespołów zarządzających złożonymi workflowami z wieloma narzędziami to oszczędność czasu i mniej kodu do zarządzania stanem.

    Dokumentacja Anthropica wspomina o endpointach Enterprise Admin API do zarządzania użytkownikami, rolami i grupami. Materiały sugerują, że takie endpointy istnieją, ale wymagają klucza administratora i nie są jeszcze dostępne w oficjalnych SDK – tylko przez surowe żądania HTTP.

    To rozróżnienie jest istotne. Komunikaty systemowe w trakcie rozmowy kontrolują zachowanie modelu w czasie rzeczywistym, natomiast Admin API, jeśli zostało szeroko udostępnione, kontroluje dostęp organizacyjny i uprawnienia. Te dwie warstwy razem tworzą dojrzałe wdrożenie AI w firmie.

    Możliwość dynamicznego przełączania kontekstu agenta to krok, na który wielu deweloperów czekało. Działanie tej funkcji bez utraty cache’a czyni ją naprawdę użyteczną w praktyce.


    Źródła

  • Anthropic otwiera drzwi do automatyzacji: Admin API dla Claude Enterprise już w becie

    Anthropic otwiera drzwi do automatyzacji: Admin API dla Claude Enterprise już w becie

    Anthropic udostępnił interfejs Admin API dla organizacji korzystających z Claude Enterprise. To umożliwia zarządzanie dostępem przez kod, eliminując potrzebę korzystania z konsoli. Nowe endpointy pozwalają programistycznie dodawać i usuwać użytkowników, zmieniać role, zarządzać grupami RBAC oraz zaproszeniami. Wraz z API wprowadzono klucz audytowy read:org_audit, który umożliwia zespołom bezpieczeństwa dostęp do scentralizowanych logów.

    Kluczowe informacje o Admin API

    • Admin API obejmuje członków organizacji, zaproszenia, grupy i role niestandardowe w Claude Enterprise — funkcjonalność jest już w becie.
    • Klucze z zakresem read:org_audit umożliwiają systemom compliance i monitoringu odczyt danych bez uprawnień do zapisu.
    • Zaproszenia mogą od razu przypisywać użytkowników do grup RBAC, co upraszcza onboarding w dużych zespołach.
    • Endpointy grup i ról niestandardowych nie wymagają już nagłówka beta; anthropic-beta: ce-user-management-2026-07-13 jest teraz opcjonalny.

    Co konkretnie oferuje nowe API

    Admin API działa pod ścieżką /v1/organizations/ i używa klucza API w nagłówku x-api-key. Dla organizacji Claude Enterprise klucz tworzy się bezpośrednio w Claude — nie jest to ogólny klucz platformowy. Anthropic oddziela ten model od dostępu OAuth: tokeny Bearer z zakresem org:admin są dostępne dla członków z rolami administratorskimi w ogólnym Admin API, natomiast Claude Enterprise dostaje własne, zakresowe klucze tworzone w interfejsie.

    Lista możliwości jest konkretna. Można przeszukiwać członków organizacji po adresie e-mail, zmieniać im role, usuwać konta, wysyłać i wycofywać zaproszenia, a także zarządzać grupami oraz odczytywać dostępne role niestandardowe. Dla zespołów DevOps oznacza to integrację z systemami katalogowymi, takimi jak Okta czy Azure AD.

    Role, grupy i automatyzacja onboardingu

    Ciekawym detalem jest zachowanie zaproszeń. Claude Enterprise akceptuje role user i managed, natomiast roli admin nie da się przypisać przez API. To świadoma decyzja, aby nadawanie uprawnień administratorskich pozostawić ludziom.

    Grupy RBAC można przypisywać już na etapie wysyłania zaproszenia. Wystarczy niepusta lista grup i odpowiedni zakres uprawnień (write:rbac_groups). Scenariusz wygląda tak: nowy pracownik pojawia się w systemie HR, webhook uruchamia zaproszenie do Claude Enterprise z przypisaną grupą “zespół-frontendu”, a po akceptacji użytkownik od razu trafia do właściwego workspace’a. Zero ręcznego konfigurowania.

    Audyt bez możliwości zapisu

    Zakres read:org_audit jest przeznaczony wyłącznie do odczytu i obejmuje wszystkie endpointy GET związane z zarządzaniem użytkownikami. Nie daje dostępu do analityki ani limitów wydatków.

    Dla dużych organizacji to sygnał, że Anthropic myśli o Claude jako o infrastrukturze, którą trzeba monitorować. Zespoły SecOps mogą podpiąć własne narzędzia do przeglądania zmian w członkostwie, wykrywać nieaktywne konta albo budować dashboardy bezpieczeństwa — wszystko bez ryzyka przypadkowej modyfikacji.

    SDK, CLI i infrastruktura jako kod

    SDK, CLI i infrastruktura jako kod

    Admin API jest dostępne przez biblioteki SDK w Pythonie, TypeScript, C#, Go, Javie, PHP i Ruby — pod powierzchnią client.organization. W CLI używa się komendy ant organization. Metody obejmują też workspace’y, klucze API, konta serwisowe i konfigurację tożsamości federacyjnej. Ogłoszenie dotyczy przede wszystkim rozszerzenia o członków Claude Enterprise i grupy, ale fundament pod API-driven governance już jest.

    Organizacje mogą teraz traktować dostęp do Claude’a tak samo jak dostęp do AWS czy GitHub Enterprise. Koniec z ręcznym przydzielaniem ról przez admina, który akurat jest na urlopie. Wszystko da się opisać w Terraformie, wpiąć w pipeline onboardingowy albo wystawić przez wewnętrzny portal developerski.

    Co dalej

    Funkcjonalność zarządzania użytkownikami Claude Enterprise — w tym grupy i role niestandardowe — jest już w becie i nie wymaga osobnego nagłówka beta. Anthropic stopniowo wyprowadza z bety kolejne elementy platformy administracyjnej; w dokumentacji widać, że metody organizacyjne w SDK przeszły już z client.beta.organization do stabilnego client.organization.

    Kierunek jest jasny: Claude Enterprise przestaje być zamkniętym narzędziem do konsoli, a zaczyna przypominać normalny komponent infrastruktury — z API, rolą, audytem i integracją. Dla zespołów technicznych to dobra wiadomość. Mniej ręcznej roboty, więcej automatyzacji i sensowne logi bezpieczeństwa.


    Źródła

  • Claude z nowymi narzędziami bezpieczeństwa: wygasanie kluczy API i pełniejszy wgląd w wydarzenia administracyjne

    Claude z nowymi narzędziami bezpieczeństwa: wygasanie kluczy API i pełniejszy wgląd w wydarzenia administracyjne

    Anthropic rozszerzyło dokumentację Access Transparency dla zdarzeń cmek_preserve oraz wprowadziło możliwość ustawiania daty wygaśnięcia kluczy API bezpośrednio w konsoli Claude. Te zmiany, choć mogą wydawać się drobne, przynoszą znaczące korzyści dla zespołów DevOps i platform engineeringu w zakresie zarządzania bezpieczeństwem.

    Co konkretnie się zmieniło?

    • Access Transparency zawiera teraz przykładowy payload zdarzeń cmek_preserve oraz dwa nowe kody przyczyny: policy_violation_investigation i csae_report.
    • Dokumentacja wyjaśnia, że zdarzenie zachowania treści jest rejestrowane niezależnie od tego, czy proces został zainicjowany przez człowieka, czy przez zautomatyzowany pipeline bezpieczeństwa.
    • Klucze API można teraz tworzyć z określoną datą wygaśnięcia – predefiniowaną, niestandardową lub bezterminową.
    • Dla kluczy z okresem życia minimum 7 dni Anthropic wysyła do twórcy powiadomienie e-mail przed wygaśnięciem.
    • Pole expires_at w Admin API oraz tabela kluczy w konsoli pokazują status wygaśnięcia, co ułatwia audyt i rotację.

    Więcej przejrzystości wokół CMEK

    Access Transparency to mechanizm, który umożliwia organizacjom wgląd w to, kiedy i dlaczego Anthropic uzyskuje dostęp do ich treści. Rozszerzenie dokumentacji o filtry i konkretne przykłady payloadów dla zdarzeń cmek_preserve będzie szczególnie przydatne dla zespołów pracujących w regulowanych środowiskach.

    Ważnym uzupełnieniem jest wyjaśnienie dotyczące mechanizmu przechowywania treści. Kiedy organizacja korzysta z kluczy szyfrowania zarządzanych przez klienta (CMEK), zachowana treść jest ponownie szyfrowana poza tym kluczem. Dzięki temu dochodzenie może być kontynuowane niezależnie od tego, czy klient nadal udostępnia swój klucz, co jest istotne w przypadku incydentów bezpieczeństwa.

    W dokumentacji pojawiły się także kody przyczyn zachowania treści: safety_review, incident_response, policy_violation_investigation oraz csae_report. Dla audytorów to konkretna informacja – wiadomo nie tylko, że coś zostało zachowane, ale także dlaczego i czy stało za tym narzędzie automatyczne, czy decyzja człowieka.

    Koniec z wiecznymi kluczami

    Druga zmiana, choć bardziej praktyczna, jest równie istotna. W konsoli Claude można teraz ustawić datę wygaśnięcia klucza API już na etapie jego tworzenia. Użytkownicy mogą wybierać spośród okresów predefiniowanych, niestandardowych lub opcji "Nigdy". Istniejące klucze pozostają bez zmian, co zapobiega problemom z działaniem pipeline'ów.

    Długowieczne klucze API to klasyczny problem bezpieczeństwa – im dłużej klucz istnieje, tym większe ryzyko jego wycieku. Automatyczne przypomnienia e-mail dla kluczy z minimum tygodniowym okresem życia stanowią dodatkową warstwę zabezpieczeń. Jeśli ktoś zapomni o rotacji, system przypomni.

    Dla zespołów zarządzających sekretami i rotacją poświadczeń nowe pole expires_at w Admin API umożliwia budowanie własnych workflow opartych na tych danych. Ręczne śledzenie, który klucz kiedy wygasa, staje się zbędne.

    Co to oznacza w praktyce

    Te zmiany nie są rewolucyjne, ale wskazują na wyraźny trend: Claude z nowymi narzędziami bezpieczeństwa staje się coraz bardziej audytowalny i łatwiejszy do wdrożenia w środowiskach wymagających ścisłej kontroli. Więcej zdarzeń administracyjnych trafia do logów, a operatorzy zyskują narzędzia do zarządzania cyklem życia poświadczeń bez konieczności tworzenia własnych obejść.

    Dla osób wdrażających Claude'a w organizacjach z wymogami compliance, to dwie mniej rzeczy do zmartwień.


    Źródła