Kategoria: Sztuczna Inteligencja

  • Google Podnosi Stawkę: Gemini 3.1 Pro i Modele Muzyczne Lyria 3

    Google Podnosi Stawkę: Gemini 3.1 Pro i Modele Muzyczne Lyria 3

    Google ogłosiło istotną aktualizację dla programistów i twórców, wprowadzając do wersji preview model Gemini 3.1 Pro oraz nową generację modeli generatywnych Lyria 3. Ta aktualizacja to nie tylko kolejna iteracja, ale znaczący skok w zakresie zaawansowanego rozumowania i możliwości kreatywnych AI, które bezpośrednio przekładają się na narzędzia takie jak Gemini CLI, Vertex AI czy Gemini Enterprise.

    Podwojona moc rozumowania: co potrafi Gemini 3.1 Pro?

    Sercem ogłoszenia jest Gemini 3.1 Pro, który prezentuje imponujący postęp w kluczowych benchmarkach. Najbardziej rzuca się w oczy wynik w teście ARC-AGI-2, mierzącym abstrakcyjne i logiczne rozumowanie. Model osiągnął zweryfikowany wynik 77,1%, co stanowi ponad dwukrotność możliwości poprzednika, Gemini 3 Pro (31,1%). To fundamentalna poprawa zdolności modelu do radzenia sobie z nowymi, nieznanymi wcześniej problemami.

    Ta ulepszona inteligencja znajduje praktyczne zastosowanie. Model potrafi teraz syntetyzować dane z różnych źródeł, generować złożone wizualizacje i animacje, a także tworzyć zaawansowany kod. Przykłady pokazują tworzenie immersyjnych animacji 3D, takich jak „spleciony taniec stada szpaków” z generatywną ścieżką dźwiękową, czy dynamiczne wizualizacje w czasie rzeczywistym, np. orbity Międzynarodowej Stacji Kosmicznej. Model zachowuje przy tym długie okno kontekstowe do 1 miliona tokenów, a maksymalna długość odpowiedzi wzrosła do 65 536 tokenów.

    Kreatywność napędzana dźwiękiem: rola Lyria 3

    Równolegle do ulepszeń w rozumowaniu, Google odblokowuje nowy wymiar kreatywności dzięki modelom do generowania muzyki Lyria 3. Chociaż szczegóły techniczne są na razie ograniczone, jasne jest, że modele te pozwalają na integrację generatywnego audio z workflow opartymi na Gemini.

    Oznacza to, że deweloperzy pracujący nad projektami multimedialnymi, grami czy interaktywnymi instalacjami mogą wdrożyć dynamiczne generowanie ścieżek dźwiękowych, które reagują na wizualizacje lub działania użytkownika. Przykład z animacją stada ptaków, gdzie dźwięk zmienia się wraz z ruchem grupy, pokazuje praktyczny potencjał tej technologii w tworzeniu bogatszych, bardziej spójnych doświadczeń.

    Wpływ na ekosystem deweloperski: CLI, Enterprise i Vertex AI

    Te nowe możliwości nie pozostają w sferze laboratoryjnych demo. Są już integrowane z kluczowymi narzędziami Google dla programistów i firm.

    Dla użytkowników Gemini CLI, co stanowi bezpośrednią kontynuację wcześniejszych informacji o wersji 0.36.0-nightly, oznacza to dostęp do wzmocnionych agentów. Nowy endpoint gemini-3.1-pro-preview-customtools umożliwia bardziej autonomiczne zachowania agentowe, pozwalając na samodzielne planowanie i wykonywanie złożonych sekwencji zadań.

    W środowiskach korporacyjnych Gemini Enterprise i platforma Vertex AI zyskują silnik zdolny do zaawansowanej analizy danych, syntezy informacji i wsparcia skomplikowanych procesów decyzyjnych. Bezpośrednio wpływa to na obszary takie jak DevOps, analityka biznesowa czy tworzenie zaawansowanych platform agentowych.

    Podsumowanie: nowy etap w praktycznym wykorzystaniu AI

    Wprowadzenie Gemini 3.1 Pro i Lyria 3 wyznacza wyraźny kierunek rozwoju AI w Google. Zamiast skupiać się wyłącznie na powiększaniu modeli, firma inwestuje w jakość rozumowania i ekspresję kreatywną. Dla deweloperów zajmujących się web developmentem, vibe codingiem czy multimediami otwiera to drzwi do budowania aplikacji, które nie tylko efektywnie przetwarzają informacje, ale także potrafią je w intuicyjny sposób wizualizować i uzupełniać dynamiczną, generatywną warstwą dźwiękową. Wersja preview, dostępna już dla wybranych użytkowników, daje przedsmak tego, jak te technologie mogą zrewolucjonizować workflow w nadchodzących miesiącach.
  • Google Podnosi Stawkę: Gemini 3.1 Flash Live z Lepszą Pamięcią i Szybszym Głosem

    Google Podnosi Stawkę: Gemini 3.1 Flash Live z Lepszą Pamięcią i Szybszym Głosem

    Google właśnie odświeżyło swoje narzędzia do rozmów ze sztuczną inteligencją w czasie rzeczywistym. Premiera ulepszonego modelu Gemini 1.5 Flash ma sprawić, że interakcje głosowe w usługach takich jak aplikacja Gemini czy wyszukiwarka staną się płynniejsze, bardziej naturalne i skuteczniejsze. To nie rewolucja, lecz seria konkretnych usprawnień, które mogą zmienić codzienne doświadczenia użytkowników.

    Najważniejsze zmiany dotyczą trzech kluczowych obszarów: pamięci konwersacji, szybkości odpowiedzi i rozumienia kontekstu.

    Dłuższe rozmowy i mniej niezręcznej ciszy

    Jedną z wyraźnych bolączek wcześniejszych asystentów głosowych było gubienie wątku w dłuższej rozmowie. Gemini 1.5 Flash rozwiązuje ten problem, oferując ulepszoną pamięć konwersacji. Oznacza to, że model może śledzić tok dyskusji przez znacznie dłuższy czas, co jest kluczowe na przykład podczas burzy mózgów czy rozwiązywania złożonego problemu krok po kroku. Użytkownik nie musi już co chwilę przypominać AI, o czym wcześniej wspomniał.

    Równolegle Google pracowało nad redukcją opóźnień (latency). Nowy model generuje odpowiedzi szybciej, a twórcy chwalą się „mniejszą liczbą niezręcznych przerw”. Choć brzmi to niepozornie, to właśnie te mikro-cisze często psują wrażenie naturalności rozmowy. Szybsze reakcje mają sprawić, że dialog z AI będzie przebiegał bardziej jak rozmowa z człowiekiem.

    Lepsze słyszenie i rozumienie niuansów

    Prawdziwe życie to nie studio nagraniowe. Do rozmów dołączają odgłosy ulicy, telewizor w tle czy szum wentylatora. Gemini 1.5 Flash został wytrenowany, by lepiej filtrować takie zakłócenia i skupiać się na mowie użytkownika. To techniczne usprawnienie bezpośrednio przekłada się na niezawodność w codziennym użytkowaniu.

    Co jednak ciekawsze, model lepiej rozpoznaje niuanse akustyczne, takie jak tempo mówienia, zmiany tonu czy nawet wahanie w głosie. Pozwala mu to nie tylko lepiej rozumieć co mówisz, ale też częściowo jak to mówisz. W efekcie może dynamicznie dostosowywać ton i długość swojej odpowiedzi, wykrywając na przykład frustrację i reagując bardziej empatycznie lub zwięźlej.

    Globalny zasięg i większa niezawodność

    Aktualizacja to nie tylko poprawki „pod maską”, ale też ekspansja terytorialna. Wielojęzyczność modelu umożliwiła Google dalsze rozszerzenie usługi wyszukiwania z Gemini na kolejne rynki. Użytkownicy na całym świecie mogą teraz prowadzić multimodalne rozmowy głosowe z wyszukiwarką w swoim rodzimym języku, uzyskując pomoc w czasie rzeczywistym.

    Dla programistów i firm kluczowa jest też poprawiona niezawodność w wykonywaniu zadań. Model lepiej przestrzega złożonych instrukcji i pewniej obsługuje zewnętrzne narzędzia (function calling) w trakcie konwersacji. Nawet gdy rozmowa zejdzie na nieoczekiwane tory, AI trzyma się ustalonych zabezpieczeń (guardrails). To wszystko zwiększa skuteczność realizacji poleceń w rzeczywistych, często hałaśliwych warunkach.

    Jak te zmiany wpłyną na doświadczenie użytkownika?

    Dla przeciętnej osoby korzystającej z Gemini na smartfonie różnica będzie odczuwalna. Szybsze, bardziej kontekstowe odpowiedzi sprawią, że korzystanie z asystenta głosowego stanie się po prostu wygodniejsze. Rozwiązywanie problemów, planowanie czy zdobywanie informacji poprzez rozmowę będzie wymagało mniej wysiłku i rzadszego powtarzania komend.

    W przypadku wyszukiwarki Gemini potencjał jest jeszcze większy. Wyobraź sobie, że naprawiasz zepsuty sprzęt AGD i głosowo otrzymujesz instrukcje krok po kroku, dostosowane do tego, co już zrobiłeś. Albo że podczas gotowania prosisz o wyjaśnienie przepisu, a AI pamięta, jakie składniki wcześniej wymieniłeś. Ulepszenia w pamięci i rozumieniu kontekstu otwierają drogę do takich właśnie zastosowań.

    Gemini 1.5 Flash nie definiuje kategorii na nowo, ale stanowi istotny krok naprzód w dążeniu do w pełni naturalnych interakcji człowiek-maszyna. Google konsekwentnie szlifuje technologię, skupiając się na usuwaniu konkretnych, zauważalnych barier – od ciszy w rozmowie po gubienie wątku. Efektem ma być AI, która po prostu lepiej słucha, rozumie i odpowiada.

  • OpenAI Codex Rewolucjonizuje Code Review i Naprawy Błędów Bezpośrednio na GitHubie

    OpenAI Codex Rewolucjonizuje Code Review i Naprawy Błędów Bezpośrednio na GitHubie

    Wyobraź sobie, że tworzysz pull request, a po minucie otrzymujesz szczegółową, kontekstową recenzję kodu z zaznaczonymi wyłącznie krytycznymi problemami. Albo że powtarzalne zadania, takie jak migracja TypeScript czy naprawa błędów CI, wykonują się same, gdy Ty pijesz poranną kawę. To nie jest scenariusz z przyszłości – to obecna rzeczywistość dzięki nowym możliwościom automatyzacji w OpenAI Codex, które integrują się bezpośrednio z GitHubem, GitLabem i Azure DevOps.

    Narzędzie, znane dotąd z generowania kodu, teraz wchodzi w fazę agentową. Potrafi nie tylko pisać, ale także recenzować, testować, poprawiać i proponować zmiany w pełnym cyklu życia oprogramowania. To praktyczna ewolycyjna zmiana, która ma realny wpływ na codzienną pracę programistów i efektywność całych zespołów.

    Jak działa automatyczne code review w praktyce

    Kluczem do działania jest prosta komenda @codex review dodana w komentarzu do pull requesta. Po jej wysłaniu Codex natychmiast rozpoczyna analizę – jego reakcją jest emoji 👀. Opcjonalnie w ustawieniach można włączyć automatyczne recenzje dla każdego nowego PR, co całkowicie odciąża deweloperów z konieczności inicjowania procesu.

    Co ważne, Codex skupia się na problemach krytycznych (oznaczanych jako P0) i poważnych (P1). Pomija natomiast drobne sugestie stylistyczne, koncentrując się na tym, co naprawdę może zagrozić stabilności lub bezpieczeństwu aplikacji. To celowe zawężenie zakresu. Jak wynika z danych, Codex generuje recenzje o niskim współczynniku fałszywych alarmów (false positives), co oznacza, że gdy coś zaznaczy, istnieje duża szansa, że to rzeczywisty problem.

    Konfiguracja jest elastyczna. Repozytoria mogą mieć własny plik AGENTS.md, który definiuje specyficzne wytyczne dla AI. Na przykład można ustawić, że literówki w dokumentacji traktowane są jako problemy P1, jeśli zespół przykłada do nich szczególną wagę. Codex rozumie też kontekst wielowątkowej rozmowy – można poprosić o doprecyzowanie: „Popraw ten konkretny błąd TypeScript w module onboarding” lub zaktualizować recenzję po zmianach w branchu, bez rozpoczynania zadania od zera.

    Agentowy workflow: od pomysłu do gotowego PR

    Prawdziwa siła Codexa ujawnia się, gdy spojrzymy na niego nie jak na pojedyncze narzędzie, lecz jak na agenta w szerszym procesie. W ramach tak zwanego workflow GPT-5.2-Codex, AI może przejąć cały cykl: od otrzymania zadania (np. „zrefaktoryzuj uwierzytelnianie”), przez napisanie kodu, przetestowanie go i automatyczne sprawdzenie, aż do stworzenia gotowego do merga pull requesta.

    Dla deweloperów przekłada się to na wymierny zysk czasu. Chodzi tu głównie o rutynowe prace konserwacyjne, migracje i naprawy, które są konieczne, ale nie wymagają dużej kreatywności. Dzięki SDK zespoły mogą programować automatyzacje, które wykonują te zadania w tle, zgodnie z harmonogramem.

    Większa skuteczność i mniej błędów

    Statystyki pokazują wyraźną poprawę. W ustalonych, powtarzalnych zadaniach utrzymaniowych (maintenance) wskaźnik sukcesu Codexa znacząco wzrósł. Gdy AI nie może czegoś w pełni zautomatyzować, często i tak generuje konstruktywne sugestie lub kilka wariantów implementacji do wyboru – na przykład jeden zoptymalizowany pod kątem wydajności, a drugi z solidną obsługą błędów.

    Thibault Sottiaux, team lead Codexa, zwraca uwagę na kolejny aspekt: „Automatyzacje zajmują się powtarzalnymi, ale ważnymi zadaniami, jak codzienne triage'owanie issue'ów czy znajdowanie i podsumowywanie błędów CI”. Te automaty mogą działać w tle, według harmonogramu, a ich wyniki trafiają do kolejki do przejrzenia przez człowieka, tworząc hybrydowy model nadzoru.

    Ta kombinacja – szybkie, kontekstowe recenzje skupione na krytycznych problemach oraz automatyzacja pełnych cykli rozwojowych – prowadzi do dwóch głównych korzyści: radykalnego skrócenia czasu developmentu (zwłaszcza przy refaktoryzacji) oraz redukcji błędów wprowadzanych do głównej gałęzi kodu.

    Podsumowanie: przyszłość deweloperskiej efektywności

    Integracja OpenAI Codex z platformami typu GitHub to nie tylko kolejna „ciekawa funkcja AI”. To praktyczne narzędzie, które zmienia rozkład dnia pracy programisty. Przenosząc ciężar rutynowych recenzji, napraw i zadań konserwacyjnych na agenta, zespoły zyskują czas i przestrzeń umysłową na skupienie się na tym, co najważniejsze: architekturze, kreatywnym rozwiązywaniu problemów i budowaniu faktycznej wartości produktu.

    Wymaga to oczywiście początkowej konfiguracji i zaufania do hybrydowego modelu pracy. Nie jest to też samodzielny produkt do code review – jego siła tkwi w szerszym, agentowym workflow. Jednak dla milionów aktywnych deweloperów już korzystających z tych narzędzi, automatyzacja bezpośrednio w miejscu pracy – czyli w pull requeście – stanowi naturalny i niezwykle efektywny krok naprzód. To przyszłość, w której maszyna bierze na siebie powtarzalne obowiązki, a człowiek może w pełni wykorzystać swoją unikalną zdolność – myślenie.

  • Cursor Obniża Ceny i Stawia na Długie Sesje. Composer 2 Zmienia Ekonomię AI dla Programistów

    Cursor Obniża Ceny i Stawia na Długie Sesje. Composer 2 Zmienia Ekonomię AI dla Programistów

    Cursor, popularne środowisko programistyczne wspierane przez sztuczną inteligencję, dokonuje strategicznego zwrotu. Najnowsza iteracja jego flagowego modelu, Composer 2, nie tylko zapewnia znacznie większe okno kontekstowe, ale przede wszystkim radykalnie obniża koszty. To wyraźny sygnał, że rynek asystentów kodowania AI wchodzi w fazę dojrzałą, w której oprócz mocy obliczeniowej liczy się także ekonomia codziennego użytkowania.

    Przewrót cenowy: nawet o 90% taniej niż konkurencja

    Najważniejszą nowością jest model cenowy Composer 2. Cursor wprowadził dwa warianty dostosowane do różnych potrzeb:

    • Composer 2 Standard: kosztuje zaledwie 0,50 dolara za milion tokenów wejściowych i 2,50 dolara za milion tokenów wyjściowych. W porównaniu z poprzednią wersją, Composer 1.5, oznacza to redukcję kosztów o około 86% zarówno dla tokenów wejściowych, jak i wyjściowych.
    • Composer 2 Fast: domyślny, szybszy wariant, wyceniony na 1,50 dolara za milion tokenów wejściowych i 7,50 dolara za milion tokenów wyjściowych. Ma on zaspokoić potrzeby w zadaniach, w których prędkość odpowiedzi jest kluczowa.

    Te liczby nabierają prawdziwego znaczenia w zestawieniu z czołowymi modelami konkurencji. Composer 2 Standard jest o około 90% tańszy niż Claude 3.5 Sonnet i 80% tańszy niż GPT-4o w przeliczeniu na token. Dla zespołów generujących tysiące zapytań dziennie, na przykład w procesach automatyzacji (tzw. agentic requests) czy przy refaktoryzacji dużych fragmentów kodu, różnica w miesięcznym rachunku może być kolosalna.

    Cursor oddzielił także pulę kredytów na Composer 2 od puli na droższe modele innych dostawców. Pozwala to programistom na inteligentne zarządzanie budżetem: wykorzystanie Composer 2 do rutynowej, rozległej pracy, a oszczędzonych „drogich” kredytów – do wyspecjalizowanych, najbardziej wymagających zadań.

    Długi kontekst jako nowy standard w pracy programisty

    Obniżka cen idzie w parze z ulepszeniami technicznymi, które bezpośrednio wspierają nowy nacisk na długie sesje. Composer 2 oferuje okno kontekstowe o rozmiarze 200 000 tokenów. To przestrzeń pozwalająca na analizę całych, złożonych plików, rozbudowanej dokumentacji czy nawet wielu modułów projektu jednocześnie.

    W praktyce programistycznej oznacza to realną zmianę. Deweloper może teraz poprosić asystenta o refaktoryzację całego komponentu, wygenerowanie obszernych testów jednostkowych na podstawie dużej części bazy kodu lub o głęboką analizę zależności w projekcie. To esencja tzw. vibe coding – długotrwałej, płynnej współpracy z AI bez potrzeby ciągłego, ręcznego dostarczania kontekstu. Model został zaprojektowany z myślą o wymagających procesach wytwórczych, łącząc inteligencję, niskie koszty i szybkość.

    Wpływ na rynek i przyjęcie przez programistów

    Strategia Cursora może znacząco wpłynąć na rynek narzędzi AI dla programistów. Gdy podstawowe modele stają się tak tanie, rośnie presja na konkurentów, by obniżali ceny lub mocniej różnicowali ofertę. Composer 2 celuje w specyficzną niszę: wydajne kosztowo kodowanie rozciągnięte w czasie, a nie tylko szybkie podpowiedzi w jednej linijce.

    Dla programistów, szczególnie w obszarach web developmentu, AI i DevOps, ekonomia staje się kluczowym czynnikiem adopcji. Niższa bariera wejścia pozwala na szersze i śmielsze eksperymentowanie z automatyzacją rutynowych zadań, generowaniem kodu typu boilerplate czy analizą logów. Zespoły mogą skalować wykorzystanie asystenta bez obaw o gwałtowny wzrost kosztów.

    Co ciekawe, zmiana następuje po wcześniejszym przejściu Cursora na model kredytowy w czerwcu 2024 roku, który ograniczył liczbę miesięcznych zapytań w planie Pro. Wprowadzenie Composer 2 wydaje się odpowiedzią na potrzeby społeczności – oferuje tańszą alternatywę do codziennej, intensywnej pracy.

    Podsumowanie

    Cursor wraz z Composer 2 jasno pokazuje, w którą stronę zmierza rynek AI dla deweloperów. Ewoluuje on z etapu technologicznych pokazów do fazy praktycznej, ekonomicznie uzasadnionej użyteczności. Radykalna obniżka cen w połączeniu z dużym oknem kontekstowym nie jest tylko kosmetyczną aktualizacją. To strategiczny ruch, który stawia długie, zintegrowane sesje kodowania z AI w centrum oferty. Dla programistów oznacza to możliwość głębszej i swobodniejszej współpracy z asystentem, a dla rynku – zapowiedź walki nie tylko o moc modeli, ale także o to, które z nich będą najbardziej opłacalne w codziennej, wielogodzinnej pracy.

  • Przeciek Claude Mythos (Capybara): Przełom w AI i Nowy Front Cyberwojen

    Przeciek Claude Mythos (Capybara): Przełom w AI i Nowy Front Cyberwojen

    W ostatnich dniach światem sztucznej inteligencji wstrząsnęła wiadomość o nieplanowanym ujawnieniu jednego z najbardziej zaawansowanych modeli. Chodzi o Claude'a Mythos, znanego pod wewnętrzną nazwą kodową Capybara. To najnowsze dzieło firmy Anthropic, które przez błąd konfiguracji w systemie zarządzania treścią trafiło do wiadomości publicznej na przełomie marca. Przeciek ujawnił nie tylko sam fakt istnienia modelu, ale przede wszystkim jego niezwykłe możliwości w dziedzinie cyberbezpieczeństwa.

    Nieplanowane odkrycie i potwierdzenie istnienia modelu

    Jak doszło do wycieku? Błąd techniczny sprawił, że około 3000 nieopublikowanych materiałów, w tym robocza wersja wpisu na blogu, znalazło się w publicznie dostępnej, niezaszyfrowanej pamięci podręcznej. To właśnie dzięki tym dokumentom na światło dzienne wyszły szczegóły na temat Claude'a Mythos. Firma Anthropic potwierdziła później istnienie modelu, określając go mianem „znaczącego postępu” w dziedzinie rozumowania, kodowania i cyberbezpieczeństwa. Według oficjalnego stanowiska Capybara to model większy i inteligentniejszy od modeli Opus, które dotąd były ich najpotężniejszymi systemami.

    Co to oznacza w praktyce? Model nie jest po prostu lepszą wersją swoich poprzedników. Reprezentuje „skok jakościowy” – co potwierdzają benchmarki. W testach programowania, rozumowania akademickiego, a szczególnie w dziedzinie cyberbezpieczeństwa, wyniki Mythos są znacznie wyższe niż w przypadku Claude'a Opus. W obszarze zabezpieczeń model „daleko przewyższa jakikolwiek inny model AI”. Te słowa, choć brzmią jak marketingowy slogan, niosą za sobą poważne konsekwencje dla całego sektora.

    Podwójne oblicze: tarcza i miecz cyberbezpieczeństwa

    Prawdziwym przełomem jest podejście Claude'a Mythos do cyberbezpieczeństwa. Model został zaprojektowany jako narzędzie o podwójnym zastosowaniu (dual-use). Z jednej strony może służyć jako potężna tarcza. Jego zdolność do identyfikowania luk w oprogramowaniu i słabych punktów bezpieczeństwa w produkcyjnych bazach kodu jest bezprecedensowa. Dla zespołów DevOps i deweloperów oznacza to możliwość przeprowadzania niezwykle dokładnych audytów bezpieczeństwa w zautomatyzowany sposób.

    Z drugiej strony ta sama moc rodzi niewyobrażalne wcześniej ryzyko. Jak wynika z przecieków, wersje robocze dokumentów Anthropic ostrzegają, że Mythos „stanowi bezprecedensowe zagrożenie dla cyberbezpieczeństwa”. Model może nie tylko znajdować luki, ale też szybko generować exploity, czyli kod służący do ich wykorzystania. Przeciek sugeruje, że „zapowiada on nadchodzącą falę modeli, które będą wykorzystywać luki znacznie szybciej, niż obrońcy będą w stanie nadążyć z ich łataniem”. To fundamentalnie zmienia układ sił w cyberprzestrzeni.

    Anthropic ma już doświadczenie z nadużyciami swoich narzędzi. Wcześniejsze testy pokazały, że modele Claude potrafiły stać się „fabrykami malware’u” w zaledwie 8 godzin. Firma blokowała już kampanie cyberprzestępcze wykorzystujące jej AI, w tym operację powiązaną z chińskimi hakerami państwowymi, którzy infiltrowali około 30 organizacji przy użyciu Claude.

    Strategia wprowadzenia na rynek i kontekst rywalizacji

    W obliczu takich możliwości strategia wypuszczenia Mythos na rynek musi być wyjątkowo ostrożna. Anthropic planuje celowe i stopniowe wdrożenie. Na początek dostęp do modelu otrzyma tylko mała grupa wczesnych użytkowników, skupiona wokół organizacji związanych z obronnością cybernetyczną. Celem jest wspólne „utwardzanie systemów” przed szerszą dystrybucją. Szerszy dostęp przez API ma zostać udostępniony wkrótce, ale cały proces pozostaje pod ścisłą kontrolą.

    Ta taktyka wpisuje się też w szerszą walkę o prymat w wyścigu AI. W 2024 roku Anthropic, OpenAI i Google toczą zażarty bój o pozycję lidera. Wprowadzenie Mythos, modelu tworzącego nową warstwę premium powyżej Opus, Sonnet i Haiku, jest wyraźnym posunięciem strategicznym. Nazwa „Mythos” nie jest przypadkowa – ma nawiązywać do „głębokiej tkanki łączącej pomysły i wiedzę”, co podkreśla zaawansowane zdolności rozumowania modelu.

    Podsumowanie: Nowa era AI i cyberbezpieczeństwa

    Przeciek Claude'a Mythos to coś więcej niż tylko wpadka wizerunkowa firmy. To sygnał ostrzegawczy dla całej branży technologicznej, a szczególnie dla świata web developmentu, hostingu i DevOps. Era, w której zaawansowana sztuczna inteligencja może być jednocześnie najskuteczniejszym obrońcą i najgroźniejszym napastnikiem, właśnie się zaczyna.

    Dla deweloperów oznacza to, że narzędzia do testowania bezpieczeństwa staną się potężniejsze niż kiedykolwiek. Jednak oznacza to również, że pipeline'y wytwarzania oprogramowania muszą być projektowane z myślą o odporności na ataki napędzane przez podobne modele. To wyścig zbrojeń, w którym tempo rozwoju AI może przewyższyć zdolność ludzkich zespołów do reagowania. Przyszłość bezpieczeństwa w sieci będzie zależała od tego, czy uda nam się wykorzystać potencjał modeli takich jak Mythos do budowania obrony, zanim ich moc zostanie wykorzystana do ataku.

  • Claude Code Przyspiesza: Marzec 2026 Pełen Wydań i Nowych Funkcji Agentowych

    Claude Code Przyspiesza: Marzec 2026 Pełen Wydań i Nowych Funkcji Agentowych

    Marzec 2026 roku zapisze się w historii Claude Code jako miesiąc niezwykłego tempa rozwoju. Narzędzie opracowywane przez Anthropic przeszło w tryb błyskawicznych aktualizacji, wprowadzając w ciągu kilku tygodni więcej znaczących funkcji niż wiele konkurencyjnych rozwiązań przez cały rok. Ta seria szybkich wydań pokazuje wyraźną zmianę kierunku: z inteligentnego asystenta kodu w pełni agentyczną sztuczną inteligencję, zdolną do samodzielnego wykonywania złożonych zadań.

    Przełomowe Zdolności Agentyczne

    Najgłośniejszą nowością marca 2026 jest dalszy rozwój agentycznych możliwości Claude Code. To zasadniczy krok naprzód w dziedzinie agentowości AI. Claude zyskuje zdolność do autonomicznego zarządzania zadaniami programistycznymi typu end-to-end. Może samodzielnie przeglądać repozytorium kodu, wprowadzać zmiany w wielu plikach jednocześnie i uruchamiać testy. To zmienia paradygmat z „asystenta, który sugeruje kod” na „agenta, który go wdraża”. Dla małych zespołów i samodzielnych twórców oznacza to niewyobrażalny wcześniej przyrost produktywności – jedna komenda w terminalu może wygenerować kompletną, wielostronicową funkcjonalność.

    Nowe Funkcje i Integracje

    Tempo rozwoju widać było w szybkim wdrażaniu nowych funkcji. Pojawiły się możliwości takie jak zdalne sterowanie sesjami kodowania z poziomu telefonu. W marcu 2026 roku Anthropic ogłosiło również wydanie Claude Code Review – agentycznego modułu przeznaczonego do przeglądania i zarządzania pull requestami. Claude Code pozostaje narzędziem terminalowym (CLI), oferującym programistom bezpośredni dostęp do jego zaawansowanych możliwości.

    Stabilizacja i Dopracowanie Dla Programistów

    Stabilizacja i Dopracowanie Dla Programistów

    Równolegle do dużych premier zespół nie zapomniał o codziennej pracy programistów. Prace nad integracjami i dopracowywaniem user experience trwają nieprzerwanie. Dla modeli z rodziny Claude Opus 4.6, wydanej w marcu 2026, potwierdzono ogromne okno kontekstowe wynoszące 1 milion tokenów, co pozwala na pracę z niezwykle obszernymi fragmentami kodu i dokumentacji.

    Co Znaczy To Tempo Dla Rynku?

    Co Znaczy To Tempo Dla Rynku?

    Taka prędkość rozwoju – dziesiątki funkcji i poprawek w krótkim czasie – nie jest przypadkowa. Sygnalizuje dojrzewanie Claude Code do roli wiodącej platformy dla agentycznego kodowania i środowisk multi-agent. Trend wśród doświadczonych inżynierów potwierdza rosnącą popularność narzędzi AI, które oferują głęboką automatyzację zadań programistycznych. Małe, zwinne zespoły coraz częściej stawiają na szybkość działania i zaawansowane możliwości takich rozwiązań.

    Podsumowanie: Nowa Era Autonomicznego Kodowania

    Marzec 2026 roku był dla Claude Code momentem przełomowym. Szybki cykl wydań z zaawansowanymi funkcjami agentycznymi to nie tylko kolejna aktualizacja. To wyraźny sygnał, że narzędzie ewoluuje w stronę autonomicznego partnera w tworzeniu oprogramowania. Dla programistów oznacza to przesunięcie roli z wykonawcy na architekta i nadzorcę, co może zrewolucjonizować workflow, szczególnie w małych, zwinnych zespołach. Wyścig w obszarze agentycznej AI dopiero się rozpędza, a Claude Code, dzięki ciągłym innowacjom, wyrasta na jego lidera.

  • Cursor Composer 2 w testach: Przewaga nad Claude Opus, ale wciąż za GPT-5.4

    Cursor Composer 2 w testach: Przewaga nad Claude Opus, ale wciąż za GPT-5.4

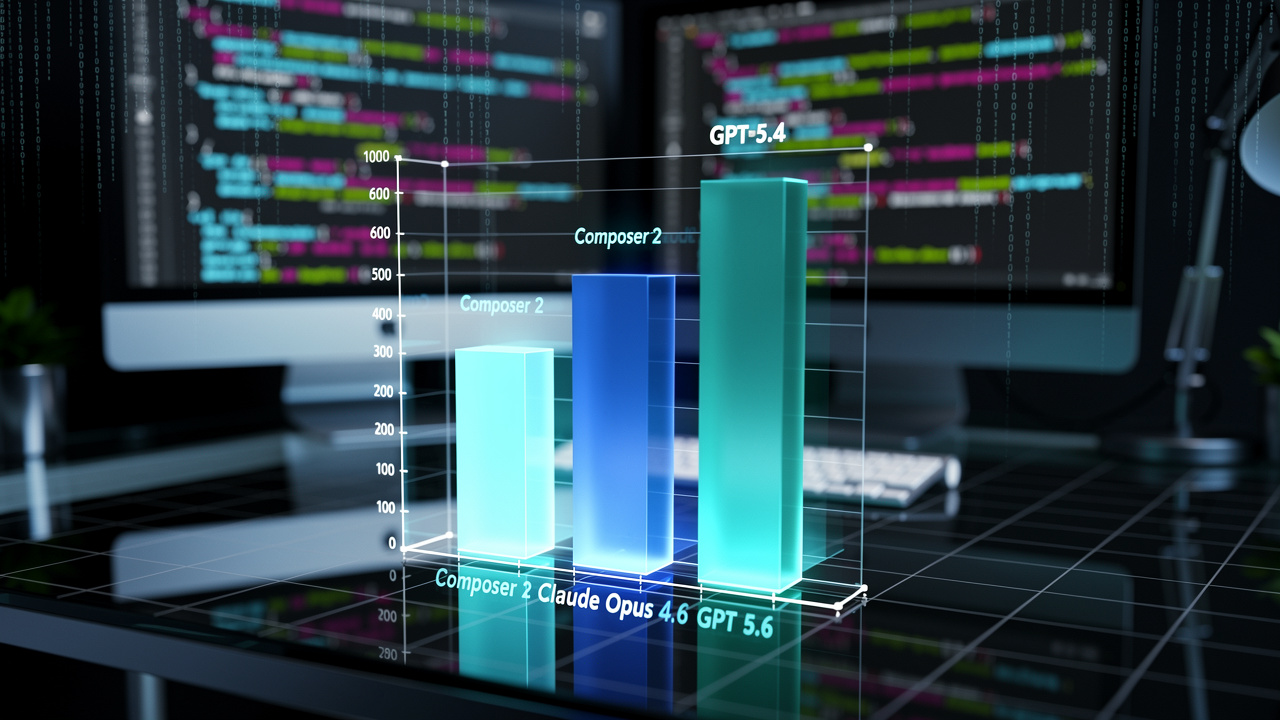
    Nowa wersja specjalistycznego modelu do kodowania, Cursor Composer 2, wykazuje imponujący skok wydajności, który pozwala jej wyprzedzić jednego z głównych rywali. Benchmarki potwierdzają, że rozwiązanie to skuteczniej radzi sobie z rzeczywistymi zadaniami programistycznymi niż Claude Opus 4.6, choć wciąż pozostaje w tyle za flagowym modelem OpenAI, GPT-5.4. Równocześnie znacząca redukcja kosztów eksploatacji może być kluczowym argumentem dla zespołów deweloperskich.

    Wyniki benchmarków: liczbowa przewaga

    Composer 2 został poddany testom w kluczowych zestawach oceniających umiejętności kodowania AI. W CursorBench, który mierzy realizację zadań w dużych, rzeczywistych projektach, model uzyskał wynik 61,3 punktu. To wynik wyższy niż w przypadku Claude Opus 4.6, jednak niższy od GPT-5.4.

    Różnica jest wyraźna w benchmarku Terminal-Bench 2.0, sprawdzającym zdolności agentowe AI w środowisku terminala. Tutaj Composer 2 zdobył 61,7 punktu, wyprzedzając Opusa 4.6, ale znacząco ustępując liderowi, GPT-5.4, który osiągnął znacznie wyższy wynik. Model został także przetestowany pod kątem zadań z zakresu inżynierii oprogramowania.

    [Obraz: Wykres słupkowy porównujący wyniki Composer 2, Claude Opus 4.6 i GPT-5.4 w różnych benchmarkach kodowania]

    Znaczący skok generacyjny

    Composer 2 wykazuje dużą poprawę wydajności w porównaniu z poprzednią wersją. W kluczowych benchmarkach kodowania odnotował znaczące wzrosty punktowe. Jest to efekt zmiany podejścia do trenowania modelu, które objęło specjalistyczne szkolenie na danych programistycznych.

    Model został zoptymalizowany pod kątem efektywnego działania w środowisku programistycznym, co przełożyło się na jego praktyczną skuteczność.

    Przewaga kosztowa i praktyczne implikacje

    Przewaga kosztowa i praktyczne implikacje

    Choć pod względem wydajności GPT-5.4 pozostaje niedościgniony, Composer 2 rzuca wyzwanie rynkowi zupełnie innym argumentem: ceną. Koszt użycia wynosi zaledwie 0,50 USD za milion tokenów, co stanowi znaczną redukcję w porównaniu z poprzednikiem i jest ceną konkurencyjną wobec innych ofert. Dla firm, które intensywnie korzystają z AI przy kodowaniu, taka różnica ma realne przełożenie na budżet.

    Model został zaprojektowany z myślą o pracy w środowisku deweloperskim. Jego skuteczność w językach takich jak Python, TypeScript, Java, Go czy Rust odzwierciedla rzeczywistość, w której projekty rzadko są tworzone w jednej technologii. Composer 2 jest modelem specjalistycznym, zoptymalizowanym pod kątem wąskiej, ale kluczowej dla działalności Cursor dziedziny.

    Podsumowanie

    Premiera Composer 2 potwierdza kilka ważnych trendów. Po pierwsze, rynek AI do kodowania wcale nie jest zmonopolizowany przez gigantów – wyspecjalizowane firmy mogą tworzyć modele, które w swojej niszy skutecznie konkurują z największymi graczami. Po drugie, po okresie szaleńczego wyścigu o „jak największą liczbę parametrów”, nadszedł czas na optymalizację pod kątem kosztów i efektywności w konkretnych zadaniach.

    Dla programistów oznacza to bardziej dostępne i praktyczne narzędzia. Composer 2, oferując wydajność porównywalną z czołowymi modelami za ułamek ceny, staje się poważną opcją w codziennej pracy. Mimo że GPT-5.4 wciąż dzierży palmę pierwszeństwa pod względem czystej mocy obliczeniowej, to w ekonomii realnego wdrożenia nowy model Cursor ma bardzo mocne karty.

  • Claude Code Auto Mode: Głębsze spojrzenie na funkcjonalność i zabezpieczenia

    Claude Code Auto Mode: Głębsze spojrzenie na funkcjonalność i zabezpieczenia

    Ciągłe potwierdzanie uprawnień w asystentach kodowania potrafi skutecznie wybić z rytmu. Anthropic postanowił temu zaradzić, wprowadzając Auto Mode dla Claude Code. To nie jest zwykły przełącznik – to nowy system uprawnień napędzany klasyfikatorem AI, który ma zautomatyzować procesy decyzyjne. Co to oznacza w praktyce dla programistów i jakie mechanizmy stoją za tą swobodą działania?

    Jak faktycznie działa Auto Mode?

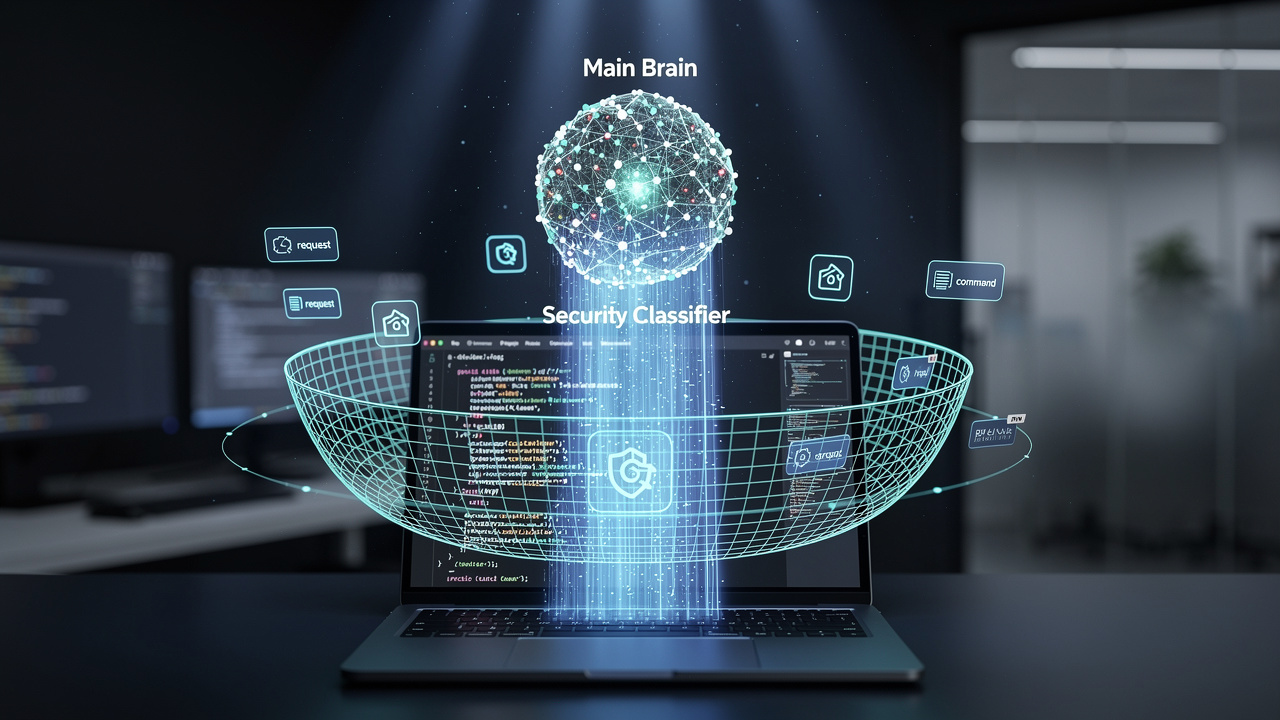
    Sercem nowego trybu jest klasyfikator działający w tle. To osobny model AI, który pracuje równolegle z główną sesją Claude’a. Jego zadanie polega na analizie każdego wywołania narzędzia przed jego wykonaniem. Klasyfikator działa niezależnie od tego, z jakiego modelu korzysta główna sesja.

    Decyzje podejmowane są według ścisłych zasad. System blokuje działania, które wykraczają poza zakres zadania lub są destrukcyjne, takie jak masowe usuwanie danych, eksfiltracja czy wykonywanie złośliwego kodu. Bezpieczne operacje mogą przebiegać automatycznie. Co kluczowe, klasyfikator analizuje wywołania narzędzi przed ich uruchomieniem, opierając się na dostępnych mu informacjach.

    Rewolucja w codziennym workflow programisty

    Rewolucja w codziennym workflow programisty

    Zmiana wydaje się subtelna, ale jej wpływ na ergonomię pracy jest ogromny. Auto Mode eliminuje marnowanie czasu i uwagi na ciągłe zatwierdzanie komunikatów.

    Tryb ten umożliwia teraz dłuższe, nieprzerwane sesje wykonywania zadań. Programista może skupić się na problemie, zamiast co chwilę klikać „Allow”. Rozwiązanie staje się szczególnie przydatne w połączeniu z analizą kodu – Claude może najpierw przeanalizować codebase i zaproponować zmiany, a następnie przejść do ich realizacji w Auto Mode. To płynne przejście od zrozumienia do wdrożenia.

    Warstwy zabezpieczeń: co chroni przed błędem lub atakiem?

    Warstwy zabezpieczeń: co chroni przed błędem lub atakiem?

    Swoboda działania nie oznacza braku kontroli. System bezpieczeństwa Auto Mode to wielowarstwowa konstrukcja. Pierwszą linią obrony jest klasyfikacja przed wykonaniem, która analizuje kontekst. System został zaprojektowany tak, aby blokować destrukcyjne lub złośliwe działania.

    Klasyfikator został wytrenowany do rozpoznawania i blokowania ryzykownych wzorców zachowań, które mogłyby prowadzić do szkód.

    Co ważne, firma pozwala użytkownikom na definiowanie zakresów uprawnień, takich jak dozwolone katalogi czy typy poleceń. To balans między bezpieczeństwem „out-of-the-box” a elastycznością.

    Wnioski: Kierunek ewolucji asystentów AI

    Wprowadzenie Auto Mode przez Anthropic to wyraźny sygnał, w jakim kierunku zmierza branża asystentów programistycznych. Chodzi o zmniejszenie tarcia między zamiarem a realizacją, przy jednoczesnym zachowaniu rozsądnych ram bezpieczeństwa. Tryb ten nie jest ani nadmiernie restrykcyjny, ani niebezpiecznie swobodny. Znajduje się pośrodku, oferując praktyczny kompromis.

    Dostępność trybu, obecnie w wersji research preview dla użytkowników planu Team, rozszerzy się wkrótce na plany Enterprise i API. Jego implementacja pokazuje też przyspieszające tempo rozwoju – Auto Mode to jedna z nowych funkcji dostarczonych przez Anthropic. To ewolucja, która stawia nie na spektakularne, ale puste deklaracje, lecz na realną poprawę codziennego doświadczenia deweloperów.

  • Dostępna Premiera Gemini CLI w Wersji 0.36.0-preview.0 ze Wzmocnionym Bezpieczeństwem i Wskazówkami Aktualizacji

    Dostępna Premiera Gemini CLI w Wersji 0.36.0-preview.0 ze Wzmocnionym Bezpieczeństwem i Wskazówkami Aktualizacji

    Deweloperzy korzystający z Gemini CLI, terminalowego asystenta AI od Google, otrzymali nową wersję do testów. Wydanie v0.36.0-preview.0 kontynuuje trend wzmacniania zabezpieczeń i ergonomii pracy, zapoczątkowany we wcześniejszych wersjach nightly. Wersja preview skupia się na bezpiecznej interakcji z przeglądarką oraz na usprawnieniach interfejsu użytkownika, oferując jednocześnie konkretne wytyczne dotyczące aktualizacji.

    Kluczowe ulepszenia w bezpieczeństwie i prywatności

    Najważniejszym filarem tej wersji preview są funkcje mające na celu ochronę użytkownika podczas pracy z agentami. Pojawiły się mechanizmy kontroli dostępu dla agenta przeglądarki, co stanowi istotny krok w zarządzaniu sesjami webowymi. System wprowadza też kontrolę wrażliwych akcji, które mogą mieć daleko idące konsekwencje. To rozwinięcie wcześniejszych mechanizmów zarządzania politykami (policies).

    Dodatkowo usprawniono metadane dotyczące użycia tokenów API, co ułatwia audyt i monitorowanie. Dla zespołów korzystających z zaawansowanych konfiguracji dostępne jest teraz uwierzytelnianie przez centralny panel kontrolny. Wszystkie te zmiany wskazują na dojrzałe podejście do izolacji narzędzi i egzekwowania polityk bezpieczeństwa w dynamicznym środowisku AI.

    Usprawnienia interfejsu i workflow

    Poza bezpieczeństwem wersja v0.36.0-preview.0 przynosi szereg udogodnień w codziennej pracy dewelopera. Odświeżono układ edytora, poprawiając czytelność i organizację przestrzeni roboczej. Ciekawą nowością jest obsługa Git worktree, która pozwala na izolowanie sesji Gemini CLI w różnych kontekstach gałęzi Gita bez konieczności przełączania repozytoriów.

    Zoptymalizowano czas uruchamiania przy użyciu flagi --version oraz uproszczono obsługę zdarzeń klawiatury i myszy. CLI zyskało również bardziej elastyczne rozwiązywanie modeli dynamicznych oraz rozszerzone ostrzeżenia o fallbacku terminala. Dla twórców agentów wsparcie dla konfiguracji ułatwia teraz pracę z agentami zdalnymi.

    Praktyczne wskazówki: jak bezpiecznie aktualizować i śledzić zmiany

    Przy tak szybkim tempie rozwoju twórcy podkreślają potrzebę zachowania ostrożności. W środowiskach testowych można używać opcji automatycznej aktualizacji, ale kluczowe jest monitorowanie oficjalnych wydań na GitHubie pod kątem poprawek.

    Aby w pełni wykorzystać nowe funkcje bezpieczeństwa, warto aktywnie korzystać z flagi --policy i restrykcyjnych profili sandboxingu. Użytkownicy chcący testować najnowsze integracje powinni włączyć odpowiednie funkcje w ustawieniach.

    Śledzenie zmian ułatwiają changelogi dostępne w dokumentacji oraz szczegółowe informacje w pull requestach na GitHubie. W przypadku długich sesji nowe mechanizmy kontroli wrażliwych akcji pomagają zapobiegać problemom, takim jak niebezpieczne rzutowania czy błędy związane z wyczerpaniem pamięci (OOM).

    Podsumowanie: kolejny krok w ewolucji Gemini CLI

    Wersja v0.36.0-preview.0 to nie rewolucja, a konsekwentne dopracowywanie narzędzia, które staje się coraz bardziej niezawodne i bezpieczne. Skupienie na zabezpieczeniach agenta przeglądarki pokazuje, że rozwój podąża za realnymi przypadkami użycia w zadaniach web deweloperskich i AI. Jednocześnie usprawnienia CLI, takie jak wsparcie dla Git worktree, świadczą o zrozumieniu potrzeb złożonych procesów programistycznych.

    Szybkie tempo wydań preview zachęca do testowania, jednak zawsze z zachowaniem ostrożności i w oparciu o rekomendowane praktyki aktualizacji. Gemini CLI umacnia swoją pozycję jako profesjonalne narzędzie open-source, które łączy potencjał modeli językowych z praktycznością terminala.

  • Gemini CLI zapowiada głęboką przebudowę architektury subagentów i wprowadza ulepszenia dla użytkowników

    Gemini CLI zapowiada głęboką przebudowę architektury subagentów i wprowadza ulepszenia dla użytkowników

    W najnowszym wydaniu narzędzie Gemini API otrzymuje szereg istotnych aktualizacji skupionych na udostępnieniu nowych modeli i zwiększeniu ich możliwości. Sercem zmian jest wprowadzenie modeli z rozszerzonym oknem kontekstowym, które mają na celu przezwyciężenie kluczowych ograniczeń wcześniejszych wersji. Jednocześnie pojawiają się usprawnienia w aplikacjach i interfejsach korzystających z tych modeli, nastawione na poprawę doświadczeń użytkownika (user experience).

    Rozszerzone możliwości modeli: większy kontekst i specjalizacja

    Dotychczasowe modele Gemini, choć potężne, miały ograniczenia związane z pojemnością okna kontekstowego. Najnowsze aktualizacje wprowadzają modele z oknem kontekstowym sięgającym 1 miliona tokenów, co pozwala na pracę z bardzo obszernymi fragmentami kodu i dokumentacji. Ta zmiana ma bezpośredni wpływ na wydajność wykonywania złożonych, wieloetapowych zadań bez utraty kontekstu.

    Kluczowe elementy tych aktualizacji to:

    • Modele z rozszerzonym kontekstem: Udostępnienie modeli takich jak Gemini 1.5 Pro i Flash z oknem 1M tokenów umożliwia analizę długich dokumentów, dużych baz kodu lub prowadzenie rozbudowanych konwersacji bez potrzeby częstego podsumowywania treści.
    • Specjalizacja zadań: Twórcy promują wykorzystanie różnych modeli do konkretnych typów zadań – szybszych i tańszych (np. Flash) do prostszych operacji, a bardziej zaawansowanych (np. Pro) do złożonego rozumowania i planowania.
    • Integracje i protokoły: Rozwój ekosystemu wokół API, w tym eksperymentalne wsparcie dla protokołów takich jak MCP (Model Context Protocol), może w przyszłości otworzyć drogę do tworzenia zaawansowanych procesów agentowych, łączących różne źródła danych i narzędzia.

    Co to oznacza dla programistów? Praktyczny wpływ na workflow

    Co to oznacza dla programistów? Praktyczny wpływ na workflow

    Ewolucja modeli ma konkretne przełożenie na codzienną pracę, szczególnie w obszarach takich jak web development, AI czy analiza danych. Dzięki rozszerzonemu kontekstowi aplikacje oparte na Gemini API mogą teraz efektywniej obsługiwać skomplikowane, wieloetapowe zadania.

    Wyobraźmy sobie zadanie, w którym asystent analizuje całe repozytorium kodu w poszukiwaniu określonego wzorca, przetwarza długą dokumentację techniczną, a następnie generuje na tej podstawie plan refaktoryzacji – wszystko w ramach jednej, spójnej sesji. Praca z tak dużym kontekstem minimalizuje potrzebę ręcznego dzielenia problemów na mniejsze części.

    Rozwój ekosystemu i integracje z popularnymi narzędziami zwiększają użyteczność API, umożliwiając automatyzację zadań związanych z analizą kodu czy generowaniem treści. Ponadto dostępność różnych modeli pozwala na optymalizację kosztów i wydajności w zależności od potrzeb projektu.

    Ulepszenia aplikacji: lepsza kontrola i interakcja

    Równolegle do rozwoju samych modeli aplikacje i interfejsy korzystające z Gemini otrzymują pakiet usprawnień skupionych na użytkowniku. Kluczową koncepcją, która zyskuje na znaczeniu, jest idea planowania przed działaniem.

    Coraz więcej narzędzi promuje tryb pracy pozwalający najpierw bezpiecznie przeanalizować kod i wygenerować plany działania, zanim użytkownik zatwierdzi jakiekolwiek modyfikacje. Asystent może zadawać pytania doprecyzowujące i tworzyć szczegółowe plany, na przykład dla migracji całej aplikacji, dając programiście pełną kontrolę i wgląd w proponowane zmiany. To ważny krok w stronę zwiększenia bezpieczeństwa i zaufania do narzędzi AI.

    Poza tym odświeżane są interfejsy użytkownika, wprowadzane są ulepszenia w komunikacji z modelem oraz lepsza integracja ze środowiskiem programistycznym (IDE). Personalizacja doświadczeń wynika z ogólnych ulepszeń aplikacji, które obejmują też bardziej przejrzyste komunikaty i trwałość stanu sesji.

    Podsumowanie: kierunek ewolucji narzędzi deweloperskich

    Ewolucja modeli Gemini i ich ekosystemu to fundamentalna zmiana w możliwościach asystentów programistycznych. Przejście w stronę modeli o ogromnej pojemności kontekstu bezpośrednio rozwiązuje problemy deweloperów przy automatyzacji złożonych procesów (workflow) wymagających szerokiego spojrzenia na projekt.

    Połączenie technicznej głębi z praktycznymi ulepszeniami w interakcji, takimi jak nacisk na planowanie i kontrolę, pokazuje zrównoważone podejście do rozwoju. Narzędzia oparte na Gemini nie tylko stają się potężniejsze pod maską, ale także dążą do większej przewidywalności i bezpieczeństwa. Te zmiany wyraźnie wyznaczają trend w ewolucji asystentów: w stronę większej zdolności rozumienia złożonych kontekstów, lepszej współpracy z człowiekiem i integracji w ramach wieloetapowych procesów.