Kategoria: Sztuczna Inteligencja

  • Anthropic wprowadza narzędzie Advisor: strategiczny doradca dla agentów AI

    Anthropic wprowadza narzędzie Advisor: strategiczny doradca dla agentów AI

    Anthropic udostępniło w publicznej betie nowe narzędzie Advisor na platformie Claude, które ma na celu poprawę działania długoterminowych, autonomicznych agentów AI. Narzędzie łączy szybki model wykonawczy, taki jak Sonnet czy Haiku, z modelem doradczym, jak Opus, oferując strategiczne wskazówki podczas generowania odpowiedzi. Dzięki temu złożone zadania agentów mogą osiągać jakość porównywalną do tej, którą zapewnia Opus, przy znacznie niższych kosztach, ponieważ drogi model doradza tylko w razie potrzeby.

    Kluczowe fakty o Advisor

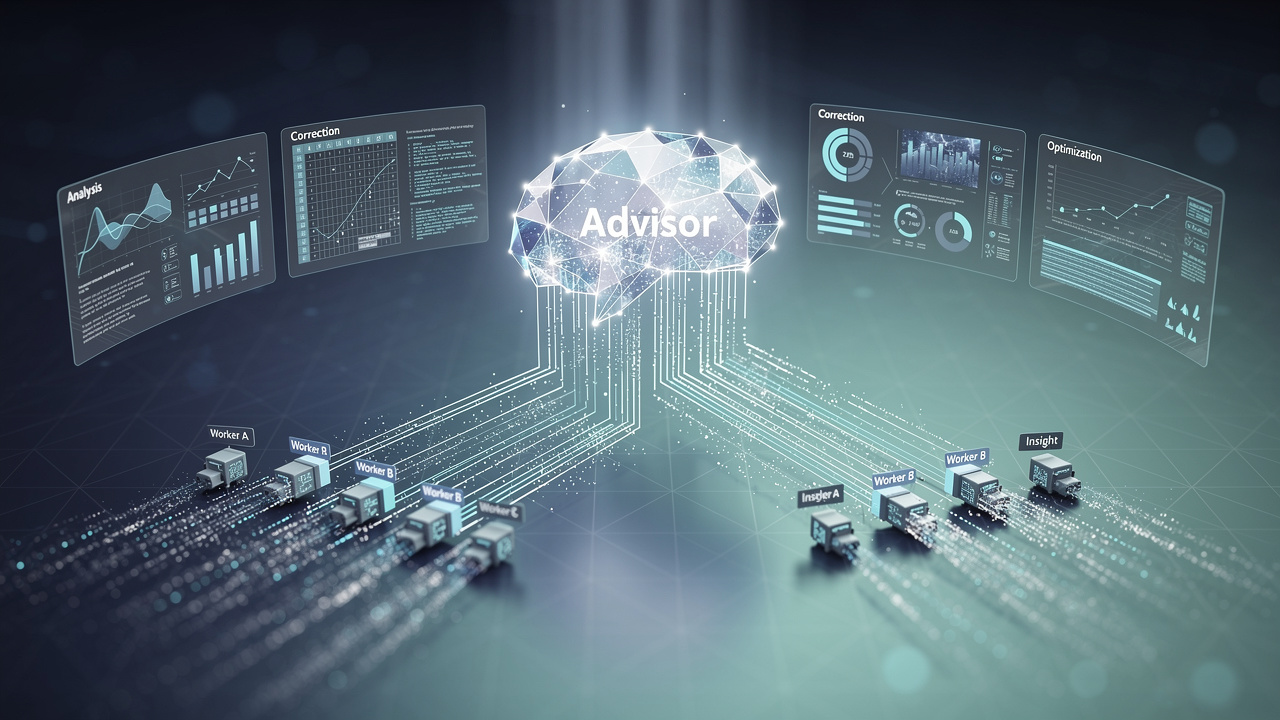
    • Mechanizm działania: Główny, szybki model wykonawczy (worker) współpracuje z modelem doradczym (advisor), który pełni rolę nadzorcy strategicznego. Doradca interweniuje w kluczowych momentach, korygując kierunek działania.
    • Korzyści ekonomiczne: Zapewnia inteligencję na poziomie Opus za ułamek kosztu, ponieważ większość tokenów generuje tańszy model wykonawczy, a droższy doradca jest konsultowany oszczędnie.
    • Integracja z ekosystemem: Narzędzie działa jako server tool na infrastrukturze Anthropic i zostało ogłoszone równolegle z Claude Managed Agents – platformą do budowy i zarządzania agentami w chmurze.
    • Cel zastosowań: Ma na celu rozwiązanie problemu agentów, które "schodzą na złą drogę" podczas długich zadań, co wymaga ręcznych poprawek i generuje dodatkowe koszty. Skupia się na złożonych automatyzacjach biznesowych.
    • Dostępność: Advisor jest dostępne na Claude Platform API. Aby z niego skorzystać, należy dodać odpowiedni nagłówek do żądań API.

    Jak działa nowy mechanizm doradczy?

    Innowacja polega na podziale ról. Wyobraźmy sobie agenta AI, który ma zaplanować i wykonać wieloetapową analizę danych, generując kod i raporty. Tradycyjnie używalibyśmy jednego, potężnego modelu (np. Opus) przez cały czas trwania zadania. Advisor zmienia tę logikę.

    W nowym podejściu codzienna praca spoczywa na szybkim i ekonomicznym modelu wykonawczym, takim jak Claude Sonnet. To on generuje kod, przetwarza dane i pisze wstępne fragmenty. W tle czuwa model Opus w roli doradcy. Gdy wykonawca napotyka punkt decyzyjny, może zwrócić się do doradcy o konsultację. Doradca analizuje sytuację, sugeruje najlepszy kierunek działania, a wykonawca kontynuuje pracę. W efekcie jakość całego procesu jest bliska tej, którą zapewnia Opus, ale koszt jest zbliżony do użycia Sonneta.

    Kontekst szerszej strategii Anthropic: zarządzani agenci
    Kontekst szerszej strategii Anthropic: zarządzani agenci

    Wprowadzenie Advisor jest częścią szerszej strategii Anthropic w obszarze infrastruktury dla agentów AI. Tydzień wcześniej firma ogłosiła publiczną betę Claude Managed Agents.

    To w pełni zarządzane środowisko, które odciąża developerów od infrastruktury. Definiują oni tylko zadanie, narzędzia i zabezpieczenia, a Anthropic zapewnia całą orchestrację: wywołania narzędzi, zarządzanie kontekstem, odzyskiwanie po błędach, bezpieczne sandboxing oraz obsługę wielogodzinnych sesji, które przetrwają nawet rozłączenie. To rozwiązanie ma umożliwić przedsiębiorstwom przejście od prototypu do produkcji w ciągu dni.

    Advisor doskonale wpisuje się w ten ekosystem. Może być używane wewnątrz Managed Agents, dodając im warstwę strategicznego nadzoru. Ceny Managed Agents są oparte na zużyciu: standardowe stawki za tokeny Claude plus opłata za każdą godzinę aktywnej sesji agenta.

    Dla kogo jest to rozwiązanie?
    Dla kogo jest to rozwiązanie?

    Advisor jest skierowane przede wszystkim do developerów i firm budujących zaawansowane automatyzacje, gdzie kluczowa jest niezawodność i redukcja błędów w długich, wieloetapowych procesach. Typowe zastosowania to:

    • Złożona generacja kodu z wieloma zależnościami i wyborami architektonicznymi.
    • Automatyczna analiza biznesowa wymagająca wnioskowania i podejmowania decyzji na podstawie danych.
    • Zaawansowane przetwarzanie dokumentów z potrzebą strategicznego planowania kolejnych kroków.

    Narzędzie odpowiada na realny problem: agenci AI czasami "gubią wątek" w długich zadaniach, co prowadzi do nieprawidłowych wyników, konieczności restartu zadania i marnowania tokenów. Dzięki punktowym interwencjom doradcy ten problem ma być znacząco ograniczony.

    Podsumowanie

    Wprowadzenie Advisor przez Anthropic to odpowiedź na wyzwania związane z ekonomią i niezawodnością agentów AI. Zamiast stawiać developerów przed wyborem: tani i szybki agent lub drogi i mądry, firma proponuje hybrydę. To podejście łączy zalety obu światów. W połączeniu z ofertą Managed Agents, Anthropic pozycjonuje się jako dostawca kompletnych, gotowych do produkcji środowisk dla zaawansowanej automatyzacji opartej na AI. Narzędzie jest już testowane w realnych warunkach, co świadczy o jego praktycznym zastosowaniu.
    Źródła

  • OpenCode v1.4.1: wzmocnienie bezpieczeństwa i ulepszenia dla c/c++

    OpenCode v1.4.1: wzmocnienie bezpieczeństwa i ulepszenia dla c/c++

    OpenCode, znana platforma wspierająca procesy deweloperskie z wykorzystaniem sztucznej inteligencji, zaktualizowała się do wersji v1.4.1. Nowa wersja, dostępna od 9 kwietnia 2026 roku, wprowadza istotne poprawki dotyczące stabilności oraz doświadczenia programistów. Wydanie koncentruje się na lepszej kontroli nad promptami, stabilizacji kluczowych funkcji oraz usprawnieniu środowiska pracy. To kolejny krok w rozwoju otwartego środowiska programistycznego, które integruje sztuczną inteligencję w codziennych zadaniach.

    Kluczowe zmiany w wydaniu v1.4.1

    • Kontrola promptów na desktopie: Wprowadzenie manualnych kontrolek dla promptów w aplikacji desktopowej zwiększa przejrzystość interakcji z AI.
    • Naprawa schematu sesji: Usunięto błąd związany z cyklicznym schematem (circular session schema), który mógł powodować problemy z zarządzaniem sesjami.
    • Usprawnienia LLM Gateway: Optymalizacje i poprawki dla bramki dostawców modeli językowych (LLM Gateway provider) zwiększają jej niezawodność.
    • Ogólne poprawki stabilności: Wprowadzone poprawki w jądrze systemu mają na celu zwiększenie stabilności i wydajności platformy.

    Precyzyjniejsza kontrola nad interakcjami

    W tej wersji szczególną uwagę zwrócono na wzmocnienie kontroli użytkownika nad interakcjami z AI, zwłaszcza w aplikacji desktopowej. Manualne kontrole dla promptów dają programiście lepszy wgląd i zarządzanie tym, jak i kiedy AI jest angażowane. To podejście pokazuje, że sztuczna inteligencja w OpenCode działa jako asystent, a nie autonomiczny aktor – kluczowe decyzje pozostają w rękach użytkownika. Taka transparentność jest istotna w projektach zespołowych oraz przy pracy z wrażliwym kodem, gdzie świadomość wszystkich działań jest kluczowa.

    Stabilność podstawowych funkcji

    Wersja v1.4.1 koncentruje się na solidnym dopracowaniu podstaw platformy. Naprawa krytycznego błędu z cyklicznym schematem sesji eliminuje potencjalne źródło niestabilności w zarządzaniu kontekstem pracy. Usprawnienia w LLM Gateway zapewniają niezawodne połączenie z zewnętrznymi modelami językowymi, co jest kluczowe dla działania całej platformy. Te techniczne poprawki przekładają się na płynniejsze i bardziej przewidywalne doświadczenie deweloperskie, redukując frustrację i przestoje.

    Kierunek rozwoju: solidna i niezawodna podstawa

    OpenCode v1.4.1 ilustruje kierunek, w którym rozwija się branża AI dla deweloperów. Platforma staje się coraz bardziej transparentna, kontrolowana i niezawodna. Poprawki stabilności podstawowych komponentów oraz ciągłe udoskonalanie interfejsu i kontroli użytkownika mają na celu zwiększenie produktywności bez utraty kontroli nad własnym kodem i środowiskiem.

    Dla polskich deweloperów korzystających z OpenCode w codziennej pracy ta aktualizacja może być szczególnie wartościowa. Większa stabilność i precyzyjniejsza kontrola sprawiają, że AI agent w OpenCode staje się bardziej przewidywalnym i kompetentnym partnerem. Warto zaktualizować.


    Źródła

  • Oto ChatGPT Images 2.0: OpenAI prezentuje model, który wreszcie poprawnie renderuje tekst

    Oto ChatGPT Images 2.0: OpenAI prezentuje model, który wreszcie poprawnie renderuje tekst

    OpenAI wprowadziło nową wersję swojego modelu generowania obrazów, Oto ChatGPT Images 2.0. Model jest już dostępny dla użytkowników i odpowiada na jedną z głównych krytyk dotyczących generatywnej sztucznej inteligencji – problem z poprawnym renderowaniem tekstu na grafikach.

    Nowy silnik nie tylko poprawia pisanie, ale także wprowadza ulepszenia w fotorealizmie, edycji i dostosowywaniu rozdzielczości. OpenAI kontynuuje rozwój w dziedzinie generatywnych mediów, koncentrując się na praktycznych zastosowaniach dla twórców i deweloperów.

    Kluczowe fakty o nowym modelu

    • Doskonałe renderowanie tekstu to główna nowość; model integruje napisy, znaki i notatki odręczne w scenach, poprawnie obsługując języki niełacińskie, takie jak japoński, koreański, hindi czy bengalski.
    • Świadomość kontekstu i fizyki pozwala na tworzenie realistycznych scen z wieloma obiektami, z poprawnym oświetleniem i bez typowych błędów, jak nakładanie się elementów.
    • Zaawansowana edycja z maskami umożliwia precyzyjne wypełnianie (inpainting) i rozszerzanie (outpainting) obrazów, zachowując szczegóły takie jak oświetlenie czy twarze, co jest kluczowe przy prototypowaniu UI czy wizualizacji produktów.
    • Nowe możliwości obejmują generowanie obrazów w rozdzielczości do 2K, dostępność wielu formatów, czterokrotnie szybsze tworzenie oraz funkcję "Chronicle" do tworzenia spójnych sekwencji wizualnych.

    Przełom w renderowaniu tekstu i wielojęzyczność

    Najważniejszą funkcją Oto ChatGPT Images 2.0 jest poprawne renderowanie tekstu. Wcześniejsze modele, w tym poprzednia wersja, miały problemy z literami, tworzyły nieczytelne ciągi znaków lub zniekształcały napisy na szyldach czy plakatach. Teraz to się zmienia.

    Model potrafi wkomponować pisany język w scenę – jako etykieta na butelce, znak drogowy, interfejs użytkownika czy kartka z notatkami. Zachowuje poprawną ortografię, spójne odstępy między literami i odpowiednie czcionki. Wsparcie dla skryptów niełacińskich otwiera możliwości dla globalnych projektów.

    Świadome świata obrazy i elastyczna jakość

    Świadome świata obrazy i elastyczna jakość

    Model został wytrenowany na lepszym rozumieniu świata fizycznego. Generowane sceny z wieloma obiektami są spójne – światło pada realistycznie, materiały wyglądają odpowiednio, a obiekty nie przenikają się nawzajem.

    Model oferuje tryby generowania "Instant" i "Thinking", które pozwalają na różnorodność w czasie przetwarzania i szczegółowości wyników. Działa z aktualną wiedzą o świecie, z datą odcięcia w grudniu 2025 roku, co pozwala na tworzenie obrazów odnoszących się do bieżących wydarzeń i trendów.

    Narzędzie dla deweloperów: od prototypów do produkcji

    Dla społeczności web dev i twórców aplikacji AI, Oto ChatGPT Images 2.0 oferuje potężne możliwości przez API (dostępne jako GPT-Image-1.5). Elastyczność rozdzielczości – od presetów po customowe wymiary, z krawędziami do 3840 px i różnymi proporcjami – pozwala generować zasoby dokładnie pod potrzeby projektu, czy to na baner, czy na tło w wysokiej rozdzielczości.

    Endpoint edycji może być najbardziej praktycznym rozwiązaniem dla wielu zastosowań. Możliwość precyzyjnej modyfikacji wybranych regionów obrazu przy użyciu masek to funkcja, na którą czekało wielu designerów. Dzięki niej można iteracyjnie poprawiać mockupy UI, wizualizować zmiany na opakowaniach produktów czy generować warianty grafik bez potrzeby zaczynania od zera.

    Podsumowanie

    Oto ChatGPT Images 2.0 to nie tylko kolejna iteracja, ale odpowiedź na konkretne problemy dotychczasowej technologii. Poprawione renderowanie tekstu ma kluczowe znaczenie dla wielu zastosowań komercyjnych, gdzie poprawny napis na wizualizacji jest istotny. Połączenie tego z lepszym rozumieniem fizyki, zaawansowaną edycją i opcjami dostosowywania jakości sprawia, że model staje się wszechstronnym narzędziem produkcyjnym.

    Dostępność przez API oznacza, że wkrótce możemy zobaczyć jego implementacje w narzędziach do prototypowania, platformach e-commerce czy generatorach treści. OpenAI stawia na użyteczność, a Oto ChatGPT Images 2.0 wydaje się być krokiem w stronę generatywnej AI, która nie tylko imponuje, ale także solidnie pracuje.

  • Bugbot uczy się na błędach i zyskuje wsparcie MCP w najnowszej aktualizacji Cursor

    Bugbot uczy się na błędach i zyskuje wsparcie MCP w najnowszej aktualizacji Cursor

    Cursor, popularne środowisko programistyczne wspomagane sztuczną inteligencją, wprowadziło nowe uaktualnienie dla swojego narzędzia do automatycznej recenzji kodu, Bugbot. Najnowsza wersja umożliwia Bugbotowi samodzielne uczenie się na podstawie informacji zwrotnej z pull requestów oraz dodaje integrację z zewnętrznymi narzędziami poprzez protokół MCP. Te zmiany, w połączeniu z ulepszeniami funkcji Autofix, pozwoliły osiągnąć rekordową skuteczność na poziomie 78% w automatycznym rozwiązywaniu wykrytych problemów.

    Jednym z kluczowych elementów aktualizacji jest mechanizm Learned Rules (wyuczone reguły). Bugbot przestał być statycznym zbiorem zasad i stał się dynamicznym systemem, który analizuje setki tysięcy recenzji dziennie, aby dostosować się do praktyk konkretnego zespołu. Narzędzie obserwuje sygnały z pull requestów, takie jak reakcje programistów na komentarze, odpowiedzi na nie oraz uwagi od ludzkich recenzentów dotyczące przeoczonych problemów. Na tej podstawie generuje kandydackie reguły, które są testowane na kolejnych PR-ach. Reguły, które zbierają pozytywne sygnały, są automatycznie promowane, a te, które nie przynoszą korzyści, są wyłączane.

    Kluczowe informacje o aktualizacji

    • Samouczące się reguły: Bugbot analizuje reakcje, odpowiedzi i komentarze w pull requestach, aby generować i promować własne, dostosowane do projektu reguły recenzji kodu.
    • Wsparcie MCP: Integracja z protokołem MCP (Model Context Protocol) umożliwia Bugbotowi dostęp do zewnętrznych serwerów i narzędzi w trakcie recenzji, co zapewnia głębszy kontekst dla złożonych systemów.
    • Rekordowa skuteczność: Połączenie nowych funkcji z ulepszonym Bugbot Autofix pozwoliło osiągnąć 78% wskaźnik rozwiązywania problemów, co jest najwyższym wynikiem w historii narzędzia.
    • Akcja "Fix All": Programiści mogą zastosować wszystkie sugerowane poprawki za pomocą jednej komendy, co znacznie przyspiesza pracę.

    Drugim istotnym elementem aktualizacji jest wsparcie MCP. Dzięki integracji z tym protokołem, Bugbot ma możliwość odpytywania zewnętrznych narzędzi i baz wiedzy w trakcie procesu recenzji. To rozwiązanie jest szczególnie istotne w przypadku skomplikowanych, rozproszonych architektur, gdzie zrozumienie kontekstu wymaga dostępu do dodatkowych źródeł. Konfiguracja serwerów MCP dla Bugbota jest dostępna przez dedykowany panel w planach Teams i Enterprise.

    Ulepszono także flagową funkcję Bugbot Autofix. Działa ona teraz bardziej precyzyjnie, uruchamiając się tylko dla istotnych znalezisk i stosując wyłącznie odpowiednie reguły. Dodano długo wyczekiwaną akcję „Fix All”, która pozwala zaakceptować i zastosować wiele poprawek jednym kliknięciem. Poprawiono również niezawodność integracji z CI/CD dla pull requestów na GitHubie.

    W kierunku autonomicznych i kontekstowych recenzji

    Te zmiany wpisują się w szerszy trend automatyzacji i personalizacji procesów developerskich. Przejście Bugbota z narzędzia egzekwującego reguły na system uczący się w locie oznacza, że jakość recenzji będzie ewoluować wraz z projektem i zespołem. Zamiast generować nieistotne uwagi, Bugbot ma się koncentrować na problemach, które naprawdę interesują programistów, wyciągając wnioski z ich codziennej pracy.

    Dostęp do zewnętrznego kontekstu za pośrednictwem MCP to krok w stronę recenzji, które rozumieją nie tylko sam kod, ale także jego otoczenie – zależności, konfigurację infrastruktury czy specyfikę domeny biznesowej. W praktyce może to przełożyć się na wykrywanie subtelniejszych błędów, które wymagają wiedzy wykraczającej poza pojedynczy plik źródłowy.

    Podsumowanie

    Aktualizacja Bugbota w Cursor to znaczący krok naprzód dla automatycznej recenzji kodu. Połączenie samouczenia z głębszym kontekstem od zewnętrznych narzędzi tworzy silną synergię. Rekordowy wskaźnik skuteczności napraw na poziomie 78% pokazuje, że te zmiany mają realny, pozytywny wpływ na codzienną pracę programistów. Dla zespołów korzystających z Cursor oznacza to mniej rutynowej pracy przy recenzjach i więcej czasu na rozwiązywanie złożonych problemów.


    Źródła

  • Gemini CLI v0.39.0-nightly.20260409: lepsza kontrola i wydajność dla nocnej wersji

    Gemini CLI v0.39.0-nightly.20260409: lepsza kontrola i wydajność dla nocnej wersji

    Google wydało nową nocną wersję swojego narzędzia AI działającego w terminalu — Gemini CLI v0.39.0-nightly.20260409. Aktualizacja koncentruje się na zwiększeniu kontroli użytkownika nad agentem, poprawie wydajności systemu oraz usunięciu kilku kluczowych błędów, które utrudniały pracę. Dla deweloperów i entuzjastów web devu oraz AI oznacza to bardziej stabilne i przewidywalne środowisko pracy bezpośrednio z linii poleceń.

    Wśród najważniejszych zmian widać wyraźny nacisk na bezpieczeństwo operacji. Tryb Plan, w którym AI może autonomicznie planować zadania, teraz wymaga od użytkownika ręcznego potwierdzenia przed aktywacją każdej umiejętności. To istotna zmiana, która pozwala na lepszą kontrolę nad bardziej złożonymi, automatycznymi workflow. Dopracowano także formatowanie wyjścia narzędzi oraz obsługę klawiszy w Windows Terminal, rozwiązując problem z usuwaniem całych słów za pomocą Ctrl+Backspace.

    Kluczowe zmiany w nocnej wersji 0.39.0

    • Wzmocniona kontrola w trybie Plan: Wprowadzono obowiązkowe potwierdzenie użytkownika dla aktywacji umiejętności, co daje większą władzę nad działaniami agenta.
    • Poprawki dla Windows Terminal i stabilności sesji: Naprawiono błąd uniemożliwiający usuwanie całych słów (Ctrl+Backspace) w Windows Terminal oraz problemy z wznawianiem zawieszonych sesji.
    • Wydajność i optymalizacja: Dodano nowe mechanizmy testowania zużycia pamięci i CPU, aby zapobiegać regresjom wydajności.
    • Bezpieczeństwo sandboxa: Wdrożono refaktoryzację sandboxa Seatbelt dla macOS oraz naprawiono problemy z symlinkami na Windows, co zwiększa izolację i bezpieczeństwo wykonywanych operacji.

    Ta nocna wersja to nie tylko poprawki, ale także rozwój infrastruktury testowej. Zespół dodał zaawansowane testy integracyjne mierzące zużycie pamięci i wydajność procesora, co pokazuje dbałość o długoterminową stabilność projektu.

    Dla użytkowników oznacza to bardziej responsywne działanie CLI. Szczególnie ważna dla programistów pracujących na Windowsie jest poprawka w Windows Terminal, która przywraca intuicyjne edytowanie linii poleceń.

    Rozwój ekosystemu i przyszłość

    Wydanie wpisuje się w szerszy trend rozwoju Gemini CLI jako platformy. Widać inwestycję w rozszerzalność i dalsze prace nad integracją z MCP serverami. Projekt, będący open source, aktywnie rozwija społeczność, co potwierdza długa lista pull requestów od wielu kontrybutorów.

    Choć wersja nightly jest przeznaczona dla użytkowników chcących testować najnowsze, czasem niestabilne funkcje, to wprowadzone w wersji 0.39.0 poprawki są niezwykle praktyczne. Niektóre z nich, jak naprawa Ctrl+Backspace na Windowsie, były wyczekiwane przez długi czas. To pokazuje, że zespół nie tylko dodaje nowe, eksperymentalne możliwości, ale także słucha społeczności i troszczy się o codzienny komfort pracy.

    Dla deweloperów zainteresowanych AI, web devem czy automatyzacją zadań devopsowych, Gemini CLI staje się coraz bardziej dojrzałym narzędziem. Ta nocna aktualizacja, skoncentrowana na kontroli i wydajności, to krok w kierunku zapewnienia stabilności potrzebnej do profesjonalnego wykorzystania AI w terminalu. Warto obserwować dalsze zmiany, zwłaszcza w stabilnych wydaniach, które powinny wkrótce wchłonąć te ulepszenia.


    Źródła

  • Kimi K2.6 Moonshot AI: Nowa Potęga wśród Modeli Kodujących Niszczy Rywali

    Kimi K2.6 Moonshot AI: Nowa Potęga wśród Modeli Kodujących Niszczy Rywali

    Moonshot AI oficjalnie wprowadził Kimi K2.6 – nową, zaawansowaną wersję swojego flagowego modelu sztucznej inteligencji, który jest przystosowany do zadań związanych z kodowaniem i działaniem jako agent. Model uzyskuje wysokie wyniki w benchmarkach, konkurując z takimi modelami jak Claude 3.5/3.7 Opus, GPT-4o/4.1 oraz Gemini 2.0/2.5 Pro. Oferuje przy tym efektywność w tworzeniu aplikacji z jednego promptu, a jego koszty są znacznie niższe niż u konkurencji. Kimi K2.6 ma potencjał, aby stać się jednym z najskuteczniejszych narzędzi dla programistów.

    Jednym z kluczowych elementów Kimi K2.6 jest jego architektura Mixture-of-Experts (MoE), która zawiera bilion parametrów, z których 32 miliardy są aktywne podczas każdego przebiegu. Taka konstrukcja zapewnia modelowi dużą wydajność i szybkość. Innowacją jest także natywna multimodalność, dzięki integracji z Kimi-VL, co umożliwia generowanie kodu na podstawie projektów UI lub zrzutów ekranu. Model obsługuje kontekst do 262 144 tokenów, co jest istotne dla złożonych, wieloetapowych zadań programistycznych.

    Kluczowe informacje

    • Wysoka wydajność: Kimi K2.6 uzyskuje konkurencyjne wyniki w benchmarkach kodowania, takich jak SWE-Bench Verified (około 60.4% dla pokrewnego modelu) oraz LiveCodeBench.
    • Architektura dla profesjonalistów: Model oparty na MoE z bilionem parametrów i 262K tokenami kontekstu, z natywną wizją lub integracją Kimi-VL do generowania kodu z projektów graficznych.
    • Moc agentów i niski koszt: Obsługuje do 100 równoległych sub-agentów oraz do 1500 wywołań narzędzi, przy koszcie inferencji zaczynającym się od około $0.0006 za 1K tokenów wejściowych na zewnętrznych platformach.

    Rewolucja vibe coding i full-stack development

    Kimi K2.6 został zaprojektowany z myślą o vibe codingu – procesie, w którym programista opisuje swoją wizję, a AI przekształca ją w kompletną, działającą aplikację. Model został zoptymalizowany do tworzenia pełnych rozwiązań full-stack z jednego, dobrze skonstruowanego promptu. Już teraz demonstruje swoje możliwości w generowaniu zaawansowanych animacji frontendowych, w tym wideo jako tła czy elementów 3D, oraz w budowaniu całych symulacji, takich jak przeglądarkowy system operacyjny czy symulator deskorolki w C++.

    Kimi K2.6 potrafi koordynować pracę grupy agentów. Do 100 równoległych sub-agentów może współpracować nad rozwiązywaniem złożonych problemów w całym repozytorium, automatycznie poprawiając błędy lub implementując nowe funkcjonalności. Model jest w stanie zarządzać długoterminowymi projektami, utrzymując spójność i kontekst przez cały proces.

    Szczegóły techniczne i wydajność

    Szczegóły techniczne i wydajność

    W porównaniu do konkurencji, Kimi K2.6 prezentuje się bardzo dobrze. W benchmarku SWE-Bench Verified, który ocenia zdolność do rozwiązywania rzeczywistych problemów z GitHub, uzyskuje wysokie wyniki. Na LiveCodeBench, oceniającym umiejętność kodowania w oparciu o najnowsze, niestandardowe problemy, model również osiąga dobre noty. Niski wskaźnik błędów przy edycjach diff w rzeczywistym kodzie pokazuje, że model dobrze rozumie kontekst i nie wprowadza przypadkowych zmian.

    Koszt inferencji jest znacznie niższy niż w przypadku komercyjnych API od OpenAI czy Anthropic. Dla deweloperów i firm, które chcą wdrożyć model, dostępność przez API (np. OpenRouter, Moonshot platform) zapewnia dużą elastyczność.

    Perspektywy dla branży deweloperskiej

    Wprowadzenie Kimi K2.6 przez Moonshot AI wskazuje na rozwój wyspecjalizowanych, potężnych i tanich modeli AI dla deweloperów. Model dorównuje czołowym, zamkniętym rozwiązaniom w kluczowych zadaniach koderskich, a jego użytkowanie jest znacznie tańsze. To narzędzie, które może przyspieszyć prototypowanie, automatyzować rutynowe zadania i umożliwić małym zespołom realizację projektów, które wcześniej wymagałyby znacznie większych zasobów.

    Integracja z istniejącymi workflow'ami jest prosta dzięki oficjalnemu SDK (npm install @moonshotai/kimi-sdk) oraz dedykowanemu CLI. Dla osób zajmujących się web developmentem, DevOps czy tworzeniem gier, Kimi K2.6 oferuje konkretną, praktyczną wartość już teraz.

  • Claude Managed Agents i nowe CLI: Nowa era agentów AI w platformie Anthropic

    Claude Managed Agents i nowe CLI: Nowa era agentów AI w platformie Anthropic

    Anthropic, firma odpowiedzialna za Claude, wprowadziła 8 kwietnia 2026 roku Claude Managed Agents w publicznej becie. To zestaw funkcji, który umożliwia uruchamianie autonomicznych agentów AI. To wydanie znacząco rozszerza możliwości platformy, koncentrując się na workflowach agentowych oraz efektywności pracy deweloperów.

    Claude Managed Agents: Nowe możliwości dla długoterminowych zadań

    Głównym elementem tego wydania są Claude Managed Agents. To nowa abstrakcja, która zmienia sposób wykorzystania Claude do złożonych, długoterminowych operacji.

    Kluczowe fakty

    • Publiczna beta: Claude Managed Agents są dostępne od 8 kwietnia 2026 w postaci publicznej bety; wymagają klucza API Claude oraz nagłówka managed-agents-2026-04-01.
    • Stabilne środowisko: Oferują w pełni zarządzany "harness", który automatyzuje agent loop, wykonywanie narzędzi, sandboxing oraz utrzymywanie stanu.
    • Mocne modele: Obsługiwane są Claude Sonnet 4.6, Claude Opus 4.6 (z domyślnym kontekstem 1M tokenów) oraz Claude Haiku 4.5.
    • Struktura workflow: Proces tworzenia agenta obejmuje definicję modelu, prompta systemowego, narzędzi oraz serwerów MCP; następnie tworzenie środowiska z kontenerem (z pre-instalowanym Pythonem, Node.js, Go).
    • Cel aplikacji: Idealne dla asynchronicznych, długoterminowych zadań, batch jobs oraz workflowów agentowych, gdzie stan musi być utrzymywany między sesjami.

    Claude Managed Agents rozwiązują problem, który wielu deweloperów próbowało rozwiązać samodzielnie: budowanie własnego runtime'u dla agenta, który może bezpiecznie wykonywać kod, przeglądać internet, czytać pliki i zarządzać stanem. Teraz dostępny jest zestaw REST API, który to wszystko zapewnia. To znaczące ułatwienie dla tworzenia asynchronicznych agentów backendowych, które mogą pracować przez długi czas, automatycznie generować raporty, scaffoldować kod czy wykonywać zadania z użyciem wielu narzędzi.

    Porównanie z istniejącym Messages API jest istotne. Messages API daje deweloperom pełną kontrolę nad loopem i narzędziami, ale wymaga utrzymania stanu po stronie klienta. Managed Agents przejmują tę odpowiedzialność na serwer, oferując persistencję stanu oraz historii w filesystemie. To sprawia, że są bardziej odpowiednie dla zadań wymagających ciągłości i długotrwałych operacji.

    Potencjalne zastosowania w web dev i vibe coding

    Potencjalne zastosowania w web dev i vibe coding

    Dla deweloperów webowych oraz osób zajmujących się vibe coding, Managed Agents otwierają nowe możliwości. Możemy teraz tworzyć agenta, który będzie asynchronicznym backendowym pomocnikiem – na przykład automatycznie generować dokumentację projektu na podstawie commitów, monitorować i analizować logi, scaffoldować nowe komponenty w różnych frameworkach, czy przeprowadzać automatyczne testy i raportowanie.

    Sandboxowane kontenery z pre-instalowanymi językami umożliwiają agentowi bezpieczne wykonywanie kodu. A persistencja stanu oznacza, że możemy wysłać agenta do pracy nad dużym zadaniem, a po kilku godzinach sprawdzić jego postępy bez potrzeby restartowania wszystkiego. To idealne rozwiązanie dla DevOpsowych workflowów, gdzie automatyzacja długoterminowych procesów jest kluczowa.

    Warto zauważyć, że niektóre funkcje są jeszcze w fazie research preview, takie jak outcomes, multiagent czy memory. Dostęp do nich wymaga dodatkowych requestów. Platforma ewoluuje, więc dostępność tych funkcji może się zmieniać w kolejnych wydaniach.

    Wprowadzenie do nowej ery agentów AI

    Claude Managed Agents pokazują, że Anthropic koncentruje się na rozwoju platformy nie tylko jako narzędzia do chatu, ale jako kompleksowego środowiska dla zaawansowanych agentów AI. Managed Agents dostarczają infrastruktury, która była często problematyczna dla deweloperów próbujących tworzyć autonomiczne systemy.

    To wydanie wpisuje się w trendy vibe coding oraz rozwój AI w DevOps. Sandboxing, persistencja stanu i zarządzana infrastruktura pozwalają deweloperowi skupić się na logice i zadaniu agenta, a nie na skomplikowanej orchestracji. W efekcie, budowanie zaawansowanych, długoterminowych pomocników AI staje się bardziej dostępne i efektywne.


    Źródła

  • Google Antigravity 1.22.2: Wprowadza Nowy System Uprawnień Agentów

    Google Antigravity 1.22.2: Wprowadza Nowy System Uprawnień Agentów

    Google opublikowało aktualizację 1.22.2 dla środowiska programistycznego Antigravity. Główną zmianą jest wprowadzenie systemu uprawnień dla agentów AI, który zastępuje dotychczasowe rozwiązania w zakresie bezpieczeństwa i kontroli nad automatyzacją kodu. Aktualizacja trafia do użytkowników etapami.

    Nowy mechanizm pozwala precyzyjnie określić, jakie działania agent może podejmować w imieniu programisty. Każda operacja – od wpisywania komend w terminalu po interakcje z przeglądarką i generowanie plików – jest teraz traktowana jako osobny zasób uprawnień. Dzięki temu użytkownicy mają większy wpływ na to, co dzieje się w ich lokalnym środowisku.

    Kontrola nad zadaniami agenta

    Agent w wersji 1.22.2 to system wnioskowania korzystający z modeli językowych klasy frontier. Narzędzie tworzy listy zadań, plany wdrożeń oraz nagrania z sesji w przeglądarce. Wcześniej zarządzanie tymi procesami było mało dokładne, co zmienia obecna aktualizacja.

    W panelu Agent Manager oraz w ustawieniach systemowych pojawiły się trzy główne zasady kontroli. Pierwsza z nich, polityka przeglądu artefaktów (Artifact Review Policy), określa sytuacje, w których agent musi zatrzymać pracę i poczekać na akceptację człowieka. Użytkownik może wybrać tryb „Always Proceed”, aby przyspieszyć proces, co jednak wiąże się z mniejszym nadzorem nad wynikami.

    Druga zasada dotyczy wykonywania poleceń w terminalu. Wykorzystuje ona listy dozwolonych i zabronionych komend (allowlists/blocklists). Pozwala to na automatyczne uruchamianie bezpiecznych operacji, takich jak npm install, przy jednoczesnym blokowaniu ryzykownych skryptów. Trzecia funkcja to polityka JavaScriptu w przeglądarce, która uniemożliwia uruchamianie niezaufanego kodu JS. Ma to chronić przed atakami typu prompt injection podczas testowania aplikacji.

    Naprawione błędy i problemy techniczne

    Wersja 1.22.2 eliminuje błąd, który powodował wyświetlanie zbędnych próśb o dostęp do terminala, nawet jeśli użytkownik zaznaczył opcję „Always run”. Dokumentacja potwierdza naprawę tej usterki, choć monity dotyczące adresów URL w przeglądarce mogą nadal występować.

    Wdrożenie nowych zabezpieczeń wiąże się też z pewnymi trudnościami. Wprowadzony wcześniej sandboxing (w wersji 1.21.6) wywołał u części osób problemy z uprawnieniami Dockera, głównie na systemie macOS. Ponieważ system wymusza aktualizacje do najnowszej wersji, niektórzy specjaliści DevOps nie mogą wrócić do starszego, stabilnego wydania. Odnotowano również przypadki błędów weryfikacji konta u użytkowników z aktywną subskrypcją, co prawdopodobnie wynika z przebudowy systemu autoryzacji.

    Bezpieczeństwo w pracy z AI i DevOps

    Nowy system uprawnień to kolejny etap rozwoju narzędzia w stronę bezpiecznego programowania wspomaganego przez AI. Dla osób pracujących w modelu „vibe coding” lub automatyzujących procesy DevOps, szczegółowe definiowanie uprawnień agenta ogranicza ryzyko przypadkowego usunięcia danych, uruchomienia złośliwego skryptu czy wejścia na niebezpieczną stronę podczas testów.

    Zmiany w wersji 1.22.2 przygotowują grunt pod dalszy rozwój autonomii agentów. Google dąży do modelu, w którym samodzielność sztucznej inteligencji jest ograniczona konkretnymi ramami ustawionymi przez człowieka. Dla zespołów zajmujących się tworzeniem stron internetowych i rozwojem AI oznacza to bardziej przewidywalne warunki pracy przy testowaniu nowych metod budowania aplikacji.


    Źródła

  • Claude Code Wraca na Tropy: Wersja 2.1.96 Naprawia Krytyczny błąd Uwierzytelniania w AWS Bedrock

    Claude Code Wraca na Tropy: Wersja 2.1.96 Naprawia Krytyczny błąd Uwierzytelniania w AWS Bedrock

    Zespół Claude Code wydał aktualizację oprogramowania. Wersja 2.1.96 usuwa błąd uwierzytelniania w AWS Bedrock, który pojawił się w wydaniu 2.1.94. Ta usterka uniemożliwiała wielu osobom połączenie z usługą, co zmusiło programistów do przygotowania poprawki w krótkim czasie.

    Problem objawiał się komunikatami HTTP 403 o treści "Authorization header is missing". Błąd występował u użytkowników konfigurujących dostęp przez zmienne środowiskowe, takie jak AWS_BEARER_TOKEN_BEDROCK lub CLAUDE_CODE_SKIP_BEDROCK_AUTH. W efekcie potoki CI/CD, skrypty automatyzacji oraz osoby korzystające z tych metod autoryzacji straciły dostęp do modeli AI w Bedrock, mimo że wcześniej usługa działała bez zakłóceń.

    Przyczyny problemów w wersji 2.1.94

    Błąd dotyczył konkretnego sposobu logowania. Wersja 2.1.94 wprowadziła zmiany, które powodowały błędne przetwarzanie nagłówków autoryzacji przy aktywnych wspomnianych zmiennych środowiskowych.

    Usterka nie dotyczyła wszystkich metod łączenia się z AWS Bedrock. Osoby korzystające ze standardowych profili AWS CLI lub ról IAM zazwyczaj nie miały problemów. Błąd uderzył w rzadsze scenariusze, takie jak użycie statycznego tokena w zmiennej AWS_BEARER_TOKEN_BEDROCK lub pomijanie autoryzacji przez CLAUDE_CODE_SKIP_BEDROCK_AUTH. Takie ustawienia są często stosowane w zautomatyzowanych środowiskach, na przykład w GitHub Actions, gdzie zarządzanie dynamicznymi poświadczeniami jest trudniejsze.

    Wersja 2.1.96 przywraca właściwą logikę obsługi tych zmiennych. Aby zainstalować poprawkę, należy użyć polecenia npm update @anthropic-ai/claude-code. Warto jednak dodać, że w zgłoszeniach na GitHubie pojawiają się informacje, że niektórzy użytkownicy GitHub Actions nadal widzą błędy 403 po aktualizacji, co może oznaczać, że problem nie został całkowicie rozwiązany w każdym środowisku.

    Znaczenie dla inżynierów AI

    AWS Bedrock jest podstawą dla zespołów budujących przepływy pracy oparte na sztucznej inteligencji w chmurze. Platforma ta pozwala korzystać z modeli Claude bez konieczności zarządzania własnymi serwerami, co ułatwia integrację z usługami AWS.

    W środowiskach DevOps i potokach CI/CD zmienne typu AWS_BEARER_TOKEN_BEDROCK są używane do bezpiecznego przekazywania uprawnień bez zapisywania ich w plikach konfiguracyjnych. Błąd w wersji 2.1.94 mógł więc zatrzymać automatyczne wdrażanie, testy czy procesy generowania kodu.

    Ostatnie wydania przyniosły też inne poprawki dla Bedrock. Rozwiązano problemy z autoryzacją SigV4, które występowały przy ustawianiu nagłówka Authorization przez ANTHROPIC_AUTH_TOKEN lub ANTHROPIC_CUSTOM_HEADERS. Zespół Claude Code regularnie poprawia współpracę z dostawcami chmurowymi, co jest niezbędne w zastosowaniach profesjonalnych.

    Konfiguracja połączenia z Bedrock

    Po przejściu na wersję 2.1.96 ustawienia powinny działać poprawnie. Przykładowa konfiguracja dla środowiska korzystającego z Claude Code i AWS Bedrock wygląda tak:

    export CLAUDE_CODE_USE_BEDROCK=1
    export AWS_REGION=us-east-1
    export AWS_PROFILE=your-profile
    # Jedna z poniższych metod autoryzacji:
    export AWS_BEARER_TOKEN_BEDROCK=your-token
    # Lub:
    export CLAUDE_CODE_SKIP_BEDROCK_AUTH=1

    W przypadku korzystania z własnych bramek lub serwerów proxy można dodatkowo użyć zmiennej ANTHROPIC_BEDROCK_BASE_URL. Taka elastyczność pozwala dopasować narzędzie do zasad bezpieczeństwa wewnątrz firmy.

    Reakcja na błędy

    Wydanie wersji 2.1.96 zaraz po wykryciu błędu pokazuje, że proces rozwoju Claude Code jest sprawny. W branży narzędzi AI, gdzie aktualizacje pojawiają się bardzo często, szybkie usuwanie usterek technicznych jest kluczowe dla zachowania ciągłości pracy użytkowników.

    Dla osób korzystających z Claude Code ta poprawka oznacza możliwość powrotu do pracy z modelami hostowanymi w chmurze. Sytuacja ta przypomina również o tym, jak ważne jest dokładne testowanie systemów uwierzytelniania przy wprowadzaniu zmian w kodzie.


    Źródła

  • Gemini CLI v0.37.0-preview.2: Rozszerzone Statystyki i Ulepszenia Interfejsu

    Gemini CLI v0.37.0-preview.2: Rozszerzone Statystyki i Ulepszenia Interfejsu

    Google udostępniło nową wersję preview swojego terminalowego agenta AI opartego na otwartym kodzie źródłowym. Gemini CLI v0.37.0-preview.2 skupia się na stabilności, nowych metrykach i poprawkach w obsłudze programu. Wydanie to wprowadza funkcje przydatne w pracy programistów, specjalistów DevOps oraz osób zajmujących się sztuczną inteligencją.

    Wersja ta powstała poprzez przeniesienie wybranych zmian (cherry-pick) i zastosowanie łatek do kodu źródłowego. Taka metoda pozwoliła na szybkie wdrożenie konkretnych poprawek bez konieczności przebudowy głównej gałęzi projektu.

    Nowe dane w sekcji /stats

    Główną zmianą jest rozbudowa polecenia /stats. Wyświetla ono teraz dodatkowe dane, które pozwalają monitorować wpływ poszczególnych umiejętności agenta (agent skills) i ustawień na pracę systemu. Jest to pomocne przy wieloetapowych zadaniach, gdzie agent wykonuje skomplikowane operacje.

    Dzięki tym zmianom można precyzyjniej analizować wydajność narzędzia. Dane te ułatwiają optymalizację czasu i zasobów potrzebnych do realizacji zautomatyzowanych procesów.

    Zmiany w interfejsie użytkownika

    W interfejsie wprowadzono funkcję rozwijania wklejanego tekstu (expandable text pastes). Rozwiązuje to problem nadmiaru informacji w oknie konsoli – zamiast wyświetlać długie bloki danych, CLI pokazuje teraz zwinięty, bardziej czytelny widok.

    Ułatwia to pracę z logami, skryptami oraz planami wykonania w trybie plan mode. Użytkownik może skupić się na konkretnych fragmentach bez przewijania setek linii tekstu, co poprawia ergonomię pracy w terminalu.

    Stabilność na systemach Windows i Linux

    Wydanie naprawia błędy występujące na systemach Windows i Linux. Z dokumentacji wynika, że twórcy skupili się także na rozwoju izolacji procesów (sandboxing) oraz zarządzaniu sesjami agenta przeglądarkowego.

    Dla osób pracujących na różnych systemach operacyjnych poprawa stabilności ma duże znaczenie. Błędy w tym obszarze mogą utrudniać automatyzację testów czy procesów wdrożeniowych CI/CD.

    Dopracowanie działania programu

    Program działa teraz stabilniej, a błędy w renderowaniu tekstu zostały ograniczone. Choć są to zmiany techniczne, wpływają one na płynność pracy, szczególnie gdy agent na bieżąco generuje kolejne kroki planu w oknie terminala. Przewidywalne zachowanie interfejsu ułatwia codzienne korzystanie z narzędzia.

    Bezpieczeństwo i telemetria

    Tryb planu otrzymał ulepszenia w zakresie izolowania narzędzi. Projekt kładzie nacisk na bezpieczeństwo, starając się oddzielać uruchamiane skrypty od systemu operacyjnego gospodarza, aby zminimalizować ryzyko niepożądanych zmian.

    W zakresie telemetrii dodano nowe metryki dla agenta przeglądarkowego. Pozwalają one zbierać informacje o wydajności tego modułu, co ułatwia jego dalszy rozwój.

    Zarządzanie konfiguracją

    Twórcy pracują nad bezpieczniejszą obsługą zmiennych środowiskowych i ustawień. Mechanizmy kontroli dostępu mają chronić klucze i hasła przekazywane do agentów działających w piaskownicy. Prawidłowe działanie tych funkcji ogranicza ryzyko wycieku danych.

    Gemini CLI jest dostępne w trzech kanałach: nightly, preview oraz stable. Wersje preview służą do testowania nowych funkcji, takich jak eksperymentalne umiejętności agenta. Narzędzie można zainstalować za pomocą npm lub npx z repozytorium google-gemini/gemini-cli.

    Rozwój agenta CLI

    Wersja v0.37.0-preview.2 pokazuje kierunek rozwoju projektu, stawiając na analitykę, stabilność i bezpieczeństwo. Zmiany te sprawiają, że narzędzie staje się bardziej przewidywalne w zastosowaniach deweloperskich. Kolejne aktualizacje dostarczają więcej danych do analizy i poprawiają komfort pracy z agentem AI w linii komend.


    Źródła