Kategoria: Bezpieczeństwo IT

  • Claude z niewidzialnym podpisem – Anthropic rozszerza znakowanie tekstu na kolejne modele

    Claude z niewidzialnym podpisem – Anthropic rozszerza znakowanie tekstu na kolejne modele

    Anthropic wprowadził tekstowy znak wodny w modelach Claude Mythos 5, Opus 4.7 i Sonnet 4.6, co zostało ogłoszone w notatkach do platformy Claude opublikowanych 3 listopada 2026. To pierwsza tak szeroka implementacja tej technologii, obejmująca zarówno najnowsze, jak i starsze generacje modeli.

    Co warto wiedzieć o aktualizacji

    • Tekstowy watermark to niewidoczny wzorzec statystyczny osadzony w doborze słów, który nie dodaje tokenów ani ukrytych znaków.
    • Modele objęte zmianą to Claude Mythos 5, Claude Opus 4.7 oraz Claude Sonnet 4.6, zgodnie z dokumentacją platformy.
    • Sonnet 4.6 może stracić znak wodny, jeśli w zapytaniu API ustawiono niestandardowe wartości parametrów temperature, top_p lub top_k.
    • System nie przechowuje danych o użytkowniku – znak wodny nie zawiera informacji o osobie, organizacji ani pochodzeniu zapytania.
    • Wykrywanie działa probabilistycznie – wskazuje prawdopodobieństwo udziału Claude'a, ale nie daje absolutnej pewności autorstwa.

    Jak działa mechanizm znakowania

    Anthropic opisuje watermark jako „niewidoczny wzorzec w doborze słów”. Nie zmienia on znaczenia, jakości ani czytelności generowanego tekstu. Nie pojawia się jako etykieta, specjalny znak czy pole metadanych – jest osadzony bezpośrednio w strukturze wypowiedzi modelu.

    Co istotne, system działa na poziomie samego modelu, a nie pojedynczej aplikacji. Oznacza to, że tekst wygenerowany przez Claude API, aplikację Claude, Claude Code, Claude Cowork czy Claude Tag będzie zawierał ten sam typ oznaczenia. Dla zespołów deweloperskich ma to znaczenie przy generowaniu dokumentacji, komentarzy w kodzie, commit message'ów czy treści na blogi – wszystko, co przechodzi przez Claude'a, potencjalnie nosi ten niewidzialny podpis.

    Pułapka w parametrach API

    Największą uwagę przykuwa zastrzeżenie dotyczące Claude Sonnet 4.6. Anthropic informuje, że ustawienie któregokolwiek z parametrów próbkowania – temperature, top_p lub top_k – na wartość inną niż domyślna może wyłączyć watermark.

    Problem jest szczególnie istotny dla narzędzi do vibe codingu, frameworków agentowych i bibliotek klienckich. Często ustawiają one te parametry automatycznie, więc deweloper może nieświadomie generować tekst bez znaku wodnego, nawet jeśli sam nie zmieniał żadnych ustawień. Anthropic zaleca pomijanie tych trzech parametrów, jeśli zespół polega na detekcji watermarku w Sonnecie 4.6.

    Kontekst regulacyjny i praktyczne ograniczenia

    Firma łączy rozszerzenie znakowania z wymogami przejrzystości narzuconymi przez unijny AI Act. Podkreśla, że watermark działa globalnie – nie tylko dla użytkowników podlegających europejskim regulacjom. To ruch wyprzedzający, ale także sygnał dla branży: podobne rozwiązania wdrażają już inni duzi dostawcy modeli AI.

    Warto jednak zrozumieć, czego watermark nie gwarantuje. Wykrycie wzorca może sugerować, że Claude brał udział w tworzeniu tekstu, ale nie wskaże konkretnej osoby, organizacji ani promptu. Nie odpowie też na pytanie, czy człowiek później znacząco edytował treść. Tekst bez znaku wodnego nie jest dowodem na brak udziału Claude'a, zwłaszcza przy zmienionych parametrach API lub późniejszej obróbce.

    Anthropic podkreśla, że to raczej sygnał probabilistyczny niż twardy dowód. Mimo to dla wydawców i zespołów technicznych pracujących z dużymi wolumenami generowanego tekstu – od CMS-ów po repozytoria kodu – ta aktualizacja wprowadza nową warstwę identyfikowalności, która wcześniej po prostu nie istniała.


    Źródła

  • Factory wzmacnia zabezpieczenia w wersji v0.179.0: twardsza izolacja procesów i ochrona macOS

    Factory wzmacnia zabezpieczenia w wersji v0.179.0: twardsza izolacja procesów i ochrona macOS

    Factory wydało wersję Desktop v0.179.0 swojego środowiska programistycznego, koncentrując się na bezpieczeństwie i stabilności, a nie na nowych funkcjach. Aktualizacja z 23 lipca 2026 roku wprowadza dwie kluczowe poprawki bezpieczeństwa oraz sześć napraw błędów, które dotyczą zarówno interfejsu wiersza poleceń, jak i aplikacji desktopowej.

    Główny nacisk położono na wzmocnienie mechanizmów izolacji procesów. Piaskownica komend zyskała lepsze odseparowanie od reszty systemu, a buildy na macOS otrzymały dodatkową warstwę ochrony przed atakami typu code injection. Pozostałe zmiany obejmują poprawki, takie jak prawidłowe wyświetlanie list repozytoriów w GitHub Enterprise Server oraz stabilizację interfejsu dyktowania głosowego.

    • Factory Desktop v0.179.0 wydane 23 lipca 2026 roku z naciskiem na bezpieczeństwo i stabilność
    • Wzmocniona izolacja procesów w piaskownicy komend
    • Ochrona macOS przed atakami code injection
    • Sześć napraw błędów – dwie w CLI i cztery w aplikacji: od zarządzania przeciążeniem modeli AI po stabilność dyktowania
    • Poprawne zakresowanie repozytoriów w GitHub Enterprise Server – organizacje widzą tylko swoje projekty

    Piaskownica z mocniejszymi ścianami

    Factory od początku promowało izolację na poziomie systemu operacyjnego jako swój kluczowy atut w zakresie bezpieczeństwa. W dokumentacji piaskownicy opisano model, w którym komendy powłoki działają w osobnych procesach, a dostęp do plików i sieci jest ograniczany przez polityki jądra systemu.

    Wersja Desktop v0.179.0 wprowadza dodatkowe wzmocnienia w tym obszarze. Zespół Factory informuje o „wzmocnieniu izolacji procesów uruchamianych wewnątrz piaskownicy komend”. Oznacza to, że agent kodujący, który uruchamia narzędzia developerskie, skrypty czy testy, będzie miał teraz bardziej ograniczone granice. Jeśli jakieś narzędzie okaże się wadliwe lub złośliwe, jego wpływ na resztę środowiska zostanie skuteczniej ograniczony.

    Dla zespołów DevOps i inżynierów pracujących z automatyzacją to istotna korzyść.

    Hardening macOS i code injection

    Druga poprawka bezpieczeństwa dotyczy platformy Apple. Factory „utwardziło wydania macOS przeciwko code injection”, czyli atakom, które próbują wstrzyknąć nieautoryzowane instrukcje do działającego procesu.

    To ma szczególne znaczenie w kontekście narzędzi AI do kodowania. Aplikacja Factory ma dostęp do repozytoriów, uruchamia komendy, wywołuje narzędzia deweloperskie i operuje na lokalnych plikach projektu. Przejęcie kontroli nad jej procesem mogłoby prowadzić do poważnych konsekwencji. Dlatego zabezpieczenie samego procesu aplikacji uzupełnia izolację piaskownicy.

    Sześć łatek, które robią różnicę

    Oprócz poprawek bezpieczeństwa, wersja Desktop v0.179.0 wprowadza zestaw usprawnień, które wpływają na codzienne użytkowanie. Dwie z nich dotyczą CLI, a cztery – aplikacji.

    • Zatwierdzanie misji (CLI) zyskało poprawkę renderowania – treść propozycji misji wyświetla się teraz raz, zamiast powielać się podczas zatwierdzania. Dla użytkowników pracujących z agentami to ważne, ponieważ ekran zatwierdzenia jest punktem kontrolnym, w którym przeglądają planowane działania przed wykonaniem.

    • Zarządzanie przeciążeniem modeli (CLI) działa teraz płynniej. Gdy model AI chwilowo nie wyrabia, a nie ma dostępnej alternatywy, interfejs wiersza poleceń wycofuje się w kontrolowany sposób, zamiast przerywać pracę z błędem. To zwiększa odporność na przejściowe problemy infrastruktury modeli.

    • Dyktowanie głosowe (aplikacja) przestało ucinać długie wypowiedzi, co zostało docenione przez osoby opisujące złożone zadania werbalnie.

    • Wizualizacje strumieniowe (aplikacja) nie migoczą już podczas renderowania, a kontrolka autonomii w kompozytorze zachowuje stałą szerokość, co stabilizuje układ interfejsu.

    Wreszcie repozytoria w GitHub Enterprise Server (aplikacja) są teraz prawidłowo zakresowane do organizacji użytkownika. Firmy z własnymi instancjami GitHub, w których pracownicy należą do wielu organizacji, zobaczą tylko te projekty, które są powiązane z ich organizacją.

    Podsumowanie

    Wersja Desktop v0.179.0 nie jest spektakularnym wydaniem pełnym nowych możliwości, ale stanowi solidny krok w kierunku bezpieczeństwa warstwowego. Factory łączy tutaj dwie strategie: wzmacnia piaskownicę i jednocześnie chroni własną aplikację przed atakami na jej proces. Dodatkowo wprowadza zestaw poprawek, które poprawiają komfort pracy z narzędziem – od interfejsu po integrację z GitHub Enterprise.

    Dla zespołów, które codziennie polegają na agencie AI w kwestii wykonywania kodu, każda dodatkowa warstwa izolacji ma znaczenie. Stabilniejsze dyktowanie i poprawne listowanie repozytoriów to drobiazgi, które ułatwiają życie – skutecznie, choć bez rozgłosu. Opisywana wersja pochodzi z lipca 2026 roku i nie jest najnowszą dostępną wersją.


    Źródła

  • Claude Code 2.1.214: załatane obejścia w PowerShell i nowe narzędzie do przerywania toksycznych sesji

    Claude Code 2.1.214: załatane obejścia w PowerShell i nowe narzędzie do przerywania toksycznych sesji

    Anthropic opublikowało 18 lipca 2026 roku wersję 2.1.214 narzędzia Claude Code 2.1.214. Ta aktualizacja koncentruje się na poprawie bezpieczeństwa, w tym na łatanie luk w kontroli uprawnień oraz wprowadzeniu mechanizmów do radzenia sobie z agresywnymi użytkownikami. W wydaniu znajduje się 47 zmian, z czego dziewięć dotyczy bezpieczeństwa, a trzy to nowe funkcje. Choć nie wprowadza spektakularnych wizualnych nowości, dla zespołów korzystających z Claude Code 2.1.214 w produkcji, jest to jedna z istotniejszych aktualizacji w tym roku.

    Kluczowe fakty

    • Data wydania: 18 lipca 2026 — 47 zmian, w tym 9 związanych z bezpieczeństwem i 28 poprawek błędów
    • Główne ryzyko: obejście kontroli uprawnień w Windows PowerShell 5.1 oraz niejednoznaczne reguły w warunkach if: hooków i automatycznym zatwierdzaniu
    • Nowe narzędzie EndConversation: pozwala agentowi zakończyć sesję przy próbie jailbreaku lub wyjątkowo agresywnej interakcji
    • Zmiana wzorców dir/**: wzorzec jako pojedynczy segment (np. w warunkach if: hooków) działa teraz tylko względem bieżącego katalogu, nie całego drzewa
    • Sygnał heartbeat i ulepszone OpenTelemetry: długie zadania przestały udawać zawieszone, a eksport śladów respektuje teraz polityki administratora

    Bash, zsh i niejednoznaczne przekierowania

    Największy blok zmian bezpieczeństwa dotyczy analizy uprawnień w powłoce. Wcześniej Claude Code 2.1.214 mógł w pewnych sytuacjach automatycznie zatwierdzać polecenia, które Bash lub zsh interpretowały inaczej niż własny parser uprawnień narzędzia. Aktualizacja zmienia to zachowanie: jeśli analizator nie ma pewności co do intencji polecenia, zamiast cichej zgody pojawia się monit o akceptację lub odmowę.

    Przykładem są formaty przekierowań deskryptorów plików — konstrukcje poprawne w Bash, ale mylące dla mechanizmu bezpieczeństwa Claude Code 2.1.214. Po aktualizacji takie przypadki wymagają ręcznego zatwierdzenia. Zaktualizowano również obsługę zmiennych i modyfikatorów zsh używanych wewnątrz konstrukcji [[ ]], które wcześniej mogły być traktowane jako nieszkodliwy tekst i przepuszczane bez pytania.

    Wprowadzono także ograniczenie dla bardzo długich poleceń: wszystko powyżej 10 000 znaków wymaga teraz potwierdzenia, co ma na celu zabezpieczenie przed atakami polegającymi na ukrywaniu niebezpiecznych instrukcji w morzu białych znaków lub komentarzy.

    Windows PowerShell 5.1 — obejście, które przestało działać

    Osobnym punktem zapalnym jest PowerShell 5.1 na Windows. Wydanie usuwa obejście kontroli uprawnień dotyczące poleceń wykonywanych w tych sesjach. Problem ten jest istotny, ponieważ PowerShell jest dostępny obok Bash w środowiskach z Git for Windows.

    Dla firm korzystających z Claude Code 2.1.214 na Windows to sygnał do natychmiastowej aktualizacji, zwłaszcza jeśli agenci mają dostęp do kodu produkcyjnego lub infrastruktury przez PowerShell.

    Reguły dir/** działają węziej — sprawdź swoje hooki

    To zmiana, która może niepostrzeżenie wpłynąć na istniejące konfiguracje. Wzorzec dir/** zapisany jako pojedynczy segment — na przykład Edit(src/**) — do tej pory w warunkach if: hooków i regułach automatycznego zatwierdzania dopasowywał katalog src w dowolnym miejscu drzewa katalogów. Po aktualizacji odnosi się wyłącznie do <cwd>/src, czyli katalogu względem bieżącego katalogu roboczego.

    Ta sama zasada dotyczy warunków if: w hookach. Jeśli potrzebujesz dopasowania na dowolnej głębokości, musisz teraz jawnie użyć **/dir/**. Warto poświęcić chwilę na przegląd istniejących reguł, szczególnie tych, które polegały na starym, szerszym dopasowaniu w hookach i automatycznym zatwierdzaniu.

    EndConversation — agent mówi „dość”

    EndConversation — agent mówi „dość”

    Claude Code 2.1.214 wprowadza narzędzie EndConversation, które pozwala asystentowi jednostronnie zakończyć sesję. Funkcja ta istniała już w claude.ai od 2025 roku, ale w narzędziu dla programistów jej brakowało. Teraz agent nie musi kontynuować rozmowy, gdy użytkownik próbuje jailbreaku, obchodzi ograniczenia bezpieczeństwa lub prowadzi wyjątkowo agresywną interakcję.

    Dla codziennej pracy to zabezpieczenie brzegowe — większość użytkowników nigdy go nie zobaczy. Jednak w środowiskach, gdzie Claude Code 2.1.214 jest wystawiony na interakcje z różnymi poziomami uprawnień, to dodatkowa warstwa ochrony przed próbami wymuszenia niebezpiecznych zachowań.

    Heartbeat, OpenTelemetry i porządki w tle

    Długo działające wywołania narzędzi — kompilacje, testy end-to-end, operacje Docker — otrzymują teraz okresowy sygnał postępu. Wcześniej polecenie mogło nie zwracać żadnego wyniku przez wiele minut, co sprawiało, że wyglądało na zawieszone. Heartbeat nie skraca zadania, ale pozwala odróżnić proces działający od zablokowanego.

    W obszarze obserwowalności rozszerzono logowanie OpenTelemetry, a ustawienia użytkownika nie nadpiszą już centralnej polityki wyłączającej eksport śladów. Jeśli administrator skonfigurował otlpEndpoint z wyłączonymi śladami, lokalny plik konfiguracyjny ich nie włączy.

    Dodatkowo wprowadzono poprawki dotyczące zarządzania demonem w tle, cyklu życia sesji i problemów z pamięcią przy długim działaniu. Ulepszono także flagi przekierowujące demony Docker/Podman, które teraz wymagają zgody. Narzędzie Edit zmieniło również zachowanie na literalne zastępowanie dokładnego tekstu zamiast traktowania wzorca jako wyrażenia. Naprawiono również błąd, w którym proces pkill -f nie był poprawnie obsługiwany.


    Źródła

  • Codex 0.141.0: Szyfrowane kanały Noise i wtyczki aktywowane per wątek

    Codex 0.141.0: Szyfrowane kanały Noise i wtyczki aktywowane per wątek

    OpenAI wypuściło Codex 0.141.0, które koncentruje się na bezpieczeństwie zdalnego wykonywania kodu oraz na rozszerzeniu możliwości wtyczek. Najważniejszą nowością jest wprowadzenie uwierzytelnionych, szyfrowanych kanałów Noise relay dla zdalnych executorów. Dodatkowo, poprawiono obsługę ścieżek między platformami, wprowadzono granularne sterowanie wtyczkami oraz wprowadzono szereg poprawek dla systemów Windows i środowisk enterprise.

    Kluczowe zmiany w skrócie

    • Szyfrowane kanały Noise relay zastępują dotychczasowy transport zdalny. Wszystkie komunikaty JSON-RPC, payloady narzędzi i operacje na plikach są przesyłane przez wzajemnie uwierzytelnioną sesję.
    • Aktywacja wtyczek per wątek umożliwia uruchamianie serwerów MCP tylko w konkretnym wątku, co zmniejsza ryzyko i zwiększa kontrolę.
    • Cross-platform paths — executor zachowuje natywne katalogi robocze i shelle podczas przechodzenia między Windows, macOS i Linuxem.
    • Optymalizacje wydajności redukują opóźnienia i zużycie pamięci w intensywnych sesjach narzędziowych dzięki cache'owaniu wyników wyszukiwania narzędzi.

    Noise relay — co to zmienia w praktyce

    Dotychczas zdalny executor komunikował się przez transport, który nie zapewniał szyfrowania na każdym etapie. Teraz warstwa Noise relay szyfruje wszystkie dane, od JSON-RPC po payloady narzędzi i operacje plikowe. Relay nie ma dostępu do danych w formie niezaszyfrowanej.

    Dla zespołów devopsowych oraz korzystających z hostowanych agentów oznacza to mniejsze zaufanie do infrastruktury pośredniej. Gdy agent działa na zdalnym nodzie, dane przesyłane między twoim środowiskiem a tym nodem są chronione od początku do końca, niezależnie od liczby przeskoków sieciowych.

    Przykłady: #26242 i #26245 wprowadzają nową warstwę transportową. Dodatkowo, #28032 i #28122 poprawiają przenoszenie katalogów roboczych między platformami, co często bywa problematyczne w mieszanych flotach testowych.

    Wtyczki: granularność i nowy marketplace

    Kolejną istotną zmianą jest możliwość aktywowania serwerów stdio MCP z poziomu wybranych wtyczek executorów, i to per wątek. Wcześniej wtyczka była aktywna globalnie. Teraz Codex może ją uruchomić tylko tam, gdzie jest potrzebna.

    Na przykład, agent CI w jednym wątku może potrzebować dostępu do bazy danych, a w drugim tylko do repozytorium kodu. Nie ma potrzeby włączania wszystkiego globalnie, co zmniejsza ryzyko przypadkowego wycieku kontekstu.

    Dodatkowo, wprowadzono marketplace "created-by-me", który umożliwia odkrywanie wtyczek stworzonych przez użytkowników oraz katalogi kuratorowane związane z autoryzacją. To krok w stronę lepszej dystrybucji rozszerzeń, co jest istotne dla zespołów współdzielących agentów w środowiskach produkcyjnych. Pull requesty #27870, #27884 i #27893 pokazują, jak to działa od strony technicznej — od odkrywania po aktywację na app-serverze.

    Wydajność i poprawki stabilności

    W sesjach obciążonych dużą liczbą narzędzi Codex 0.141.0 redukuje opóźnienia i zużycie pamięci. Osiągnięto to dzięki cache'owaniu wyników wyszukiwania narzędzi oraz eliminacji zbędnego kopiowania requestów i historii. Użytkownicy pracujący z rozbudowanymi workflow mogą liczyć na szybszą reakcję agenta.

    Wprowadzono również poprawki dotyczące kilku problemów, takich jak poświadczenia sandboksa na Windowsie (w tym automatyczne odzyskiwanie credentiali), wsparcie dla TLS z certyfikatami P-521 w enterprise proxy oraz lepsza widoczność limitów.

    Warto również wspomnieć o klientach realtime, którzy zyskali większą kontrolę nad mową i kontekstem konwersacji, co jest istotne dla integracji głosowych z Codexem.

    Co to znaczy dla web developera i devopsa

    Bezpieczniejszy zdalny executor zmniejsza ryzyko w hostowanych środowiskach deweloperskich i chmurowych agentach. Lepsza obsługa ścieżek między Windows, Linuxem i macOS ułatwia pracę z heterogenicznymi flotami testowymi. Aktywacja wtyczek per wątek daje większą kontrolę w wieloetapowych workflow. Poprawki TLS są istotne dla enterprise z rygorystyczną inspekcją ruchu wychodzącego.

    Wersja 0.141.0 nie wprowadza spektakularnych nowości wizualnych, ale wzmacnia fundamenty, które są kluczowe dla bezpiecznego wdrożenia agenta w produkcji.


    Źródła

  • Factory Release v0.124.0: głębokie Recenzje Bezpieczeństwa i Ulepszony Proces Logowania

    Factory Release v0.124.0: głębokie Recenzje Bezpieczeństwa i Ulepszony Proces Logowania

    Najnowsza aktualizacja platformy Factory, oznaczona numerem v0.124.0, wprowadza szereg zmian, które poprawiają bezpieczeństwo i użyteczność. Deweloperzy i integratorzy AI zyskali nowe narzędzia do analizy kodu, a użytkownicy końcowi mogą korzystać z bardziej intuicyjnego procesu logowania. To nie są jedynie kosmetyczne poprawki, ale istotny krok w kierunku bardziej elastycznego i wydajnego środowiska pracy.

    Kluczowe informacje o aktualizacji

    • Przegląd bezpieczeństwa – komenda /security-review oferuje teraz dwa tryby: głęboki i pobieżny, co pozwala dostosować analizę do potrzeb.
    • Przekierowania po logowaniu – dodano obsługę redirect URI, co umożliwia użytkownikowi powrót do miejsca, w którym przerwał pracę.
    • Wydajność CLI – interfejs wiersza poleceń stał się bardziej responsywny dzięki ulepszonemu wyszukiwaniu rozmytemu i lepszej widoczności zapisywania kontekstu.
    • Optymalizacja historii – wprowadzono ograniczenie rozmiaru historii wznawiania sesji, co zapobiega problemom z wydajnością przy długotrwałym użytkowaniu.

    Dwa wymiary bezpieczeństwa: analiza głęboka i pobieżna

    Centralnym punktem wersji v0.124.0 jest przebudowa komendy /security-review. Dotychczas deweloperzy mieli do dyspozycji jeden tryb skanowania. Teraz mogą wybierać między szczegółową analizą głęboką (deep), a szybszym przeglądem (shallow). Ta zmiana odpowiada na potrzeby zespołów programistycznych, które często muszą balansować między dokładnością a szybkością iteracji.

    Tryb głęboki jest idealny przed kluczowymi wdrożeniami, audytami czy przeglądami krytycznych fragmentów kodu. Umożliwia dokładniejsze prześledzenie zależności, konfiguracji i potencjalnych wektorów ataku, co jest istotne w kontekście bezpieczeństwa aplikacji webowych i integracji AI. Z kolei tryb pobieżny sprawdzi się w codziennej pracy programisty, oferując natychmiastową informację zwrotną na temat najbardziej rażących luk, bez spowalniania tempa pracy. Wprowadzenie tej dualności zwiększa efektywność i pozwala na lepsze zarządzanie ryzykiem w cyklu życia oprogramowania.

    Uwierzytelnianie i powrót do pracy

    Kolejnym ważnym elementem aktualizacji jest poprawa doświadczenia użytkownika związanego z logowaniem. Wprowadzenie obsługi redirect URI eliminuje problem z utratą kontekstu po zalogowaniu. Do tej pory, po przejściu przez proces uwierzytelniania, użytkownik często lądował na domyślnej stronie głównej lub panelu.

    Teraz, gdy użytkownik aplikacji desktopowej lub webowej Factory zostaje poproszony o zalogowanie, system zapamiętuje jego dokładną lokalizację. Po pomyślnej autoryzacji, mechanizm przekierowania natychmiast odsyła go do tego samego widoku, dokumentu czy sesji, nad którą pracował. Ta zmiana ma istotny wpływ na ciągłość pracy i postrzeganą płynność działania narzędzia. Jest to szczególnie ważne w środowiskach, gdzie Factory jest używane jako centralne narzędzie do zarządzania projektami AI, a każda niepotrzebna przerwa może prowadzić do frustracji.

    Ulepszenia wydajności

    Oprócz nowych funkcji, v0.124.0 przynosi szereg poprawek technicznych, które wpływają na komfort codziennego użytkowania. Interfejs wiersza poleceń (CLI) zyskał na responsywności. Ulepszone wyszukiwanie rozmyte (fuzzy search) sprawia, że znajdowanie komend, plików i opcji jest teraz szybsze i bardziej zrozumiałe dla literówek. Użytkownicy zyskali lepszą widoczność momentów, w których system zapisuje kontekst ich pracy, co zwiększa poczucie kontroli i bezpieczeństwa danych.

    Na poziomie infrastrukturalnym wprowadzono mechanizm ograniczania historii wznawiania sesji (bounded resume history). Oznacza to, że Factory przestaje przechowywać nieograniczony dziennik, który mógłby spowalniać działanie aplikacji, szczególnie przy długich projektach AI. To kluczowa optymalizacja dla wydajności, która zapobiega "puchnięciu" pamięci i zapewnia stabilną pracę nawet po wielu godzinach nieprzerwanej sesji. Wraz z ulepszonym procesem wdrażania w aplikacji desktopowej, aktualizacja ta pokazuje, że zespół Factory przykłada równą wagę do nowych funkcji i do fundamentów stabilności oraz szybkości swojego oprogramowania.


    Źródła

  • Claude Code 2.1.92 Wzmacnia Bezpieczeństwo i Przejrzystość Kosztów

    Claude Code 2.1.92 Wzmacnia Bezpieczeństwo i Przejrzystość Kosztów

    Aktualizacja Claude Code do wersji 2.1.92 wprowadza zmiany przydatne dla programistów indywidualnych oraz zespołów w dużych firmach. Deweloperzy skupili się na trzech obszarach: bezpieczeństwie, integracji z chmurą AWS oraz monitorowaniu wydatków na API. Wersja ta dodaje 10 nowych flag i 21 zmian w interfejsie wiersza poleceń (CLI).

    Nowe zasady bezpieczeństwa dla firm

    Najważniejszą zmianą techniczną jest wprowadzenie opcji forceRemoteSettingsRefresh. Działa ona w trybie fail-closed, co jest istotne w korporacjach dbających o spójność konfiguracji. Jeśli ta funkcja jest aktywna, Claude Code 2.1.92 nie uruchomi się, jeżeli nie uda mu się pobrać aktualnych ustawień z serwera.

    W praktyce oznacza to, że aplikacja kończy pracę, zamiast korzystać ze starych danych zapisanych w pamięci lokalnej. Zapobiega to pracy na nieaktualnych uprawnieniach lub błędnych parametrach bezpieczeństwa. Jest to rozwiązanie przygotowane pod wymogi działów compliance w dużych organizacjach.

    Konfiguracja AWS Bedrock w formie kreatora

    Zespoły korzystające z infrastruktury Amazon Web Services mogą teraz użyć interaktywnego kreatora dla usługi Bedrock. Narzędzie to upraszcza proces łączenia Claude Code z chmurą.

    Kreator prowadzi użytkownika przez logowanie do AWS, wybór konkretnego regionu oraz wskazanie modeli, z których chce korzystać. Wcześniej deweloperzy musieli samodzielnie ustawiać zmienne środowiskowe i edytować pliki tekstowe. Teraz proces ten odbywa się automatycznie wewnątrz terminala.

    Kontrola kosztów i optymalizacja prędkości

    Użytkownicy planu Pro mogą teraz dokładniej sprawdzać wydatki za pomocą komendy /cost. Pokazuje ona zużycie środków z rozbiciem na poszczególne modele i uwzględnia oszczędności wynikające z użycia pamięci podręcznej (cache hits). Pozwala to precyzyjnie określić, które zadania generują największe opłaty.

    Dodano również powiadomienia o tokenach. Jeśli sesja zostanie wznowiona po wygaśnięciu pamięci podręcznej promptów, system wyświetli informację o liczbie tokenów, które zostaną ponownie przetworzone. Ułatwia to zarządzanie budżetem projektu.

    Pod kątem wydajności poprawiono narzędzie write tool. Obliczanie różnic w kodzie (diff) jest o 60% szybsze w plikach, które zawierają tabulatory lub znaki specjalne, takie jak & i $. Program zużywa też mniej pamięci RAM, ponieważ pliki gramatyki potrzebne do podświetlania składni są ładowane tylko wtedy, gdy są faktycznie potrzebne.

    Zmiany w interfejsie i stabilność pracy

    Wersja 2.1.92 zawiera kilka poprawek w obsłudze programu. Polecenie /release-notes ma teraz listę wyboru, która pozwala przeglądać opisy poprzednich wersji bezpośrednio w konsoli. Naprawiono też błędy techniczne, w tym problemy z działaniem subagentów wewnątrz sesji tmux, błędy przy przewijaniu tekstu oraz usterki związane z funkcją Stop.

    Limit danych dla narzędzi MCP (Model Context Protocol) został zwiększony do 500 000 znaków. Dzięki temu w kontekście rozmowy można umieścić bardzo duże pliki, takie jak pełna dokumentacja API czy rozbudowane schematy baz danych, bez ryzyka ich ucięcia.

    Podsumowanie

    Claude Code 2.1.92 to aktualizacja nastawiona na praktyczne aspekty pracy programisty. Lepsza kontrola nad kosztami, łatwiejsza konfiguracja AWS oraz mechanizmy wymuszające aktualność ustawień sprawiają, że narzędzie staje się bardziej przewidywalne w profesjonalnych zastosowaniach. Poprawki szybkości działania diffów i stabilności interfejsu odczują wszyscy użytkownicy pracujący z kodem w terminalu.


    Źródła

  • Codex Wdraża Nową Strategię Bezpieczeństwa: Wersja 0.119.0-Alpha.1 Chroni Pliki i Rozbudowuje Workflow

    Codex Wdraża Nową Strategię Bezpieczeństwa: Wersja 0.119.0-Alpha.1 Chroni Pliki i Rozbudowuje Workflow

    Najnowsza wersja alfa Codex, oznaczona jako 0.119.0-Alpha.1, nie wprowadza rewolucyjnych funkcji, ale konsekwentnie buduje fundamenty bezpieczeństwa i stabilności. To właśnie takie wydania często mają największy wpływ na codzienną pracę deweloperów, eliminując subtelne, lecz dokuczliwe problemy oraz wzmacniając ochronę projektu.

    Zaostrzenie polityki sandboxa i sieci

    Kluczowym obszarem poprawy w tej wersji alfa jest sandbox – izolowane środowisko, w którym Codex wykonuje operacje. Wprowadzone zmiany obejmują szereg uściśleń dotyczących sieci oraz obsługi przypadków brzegowych na różnych platformach. Na przykład polityka proxy sieciowego jest teraz odświeżana automatycznie po zmianach w sandboxie, co zapewnia ciągłość bezpiecznych połączeń.

    Co ważne dla użytkowników Windows, poprawiono obsługę adresów w firewallu, co jest kluczowe dla reguł egress (ruch wychodzący) działających wyłącznie przez proxy. Bezpośrednio wpływa to na bezpieczny rozwój aplikacji wymagających kontrolowanej komunikacji sieciowej.

    Naprawiono też błąd krytyczny (panic) klienta HTTP w sandboxie na macOS oraz wyciszono nieistotne ostrzeżenia bubblewrap, co przekłada się na stabilniejszą pracę. Drobna, lecz znacząca poprawka dotyczy też błędów apply_patch w trybie read-only – teraz są one prezentowane w sposób bardziej czytelny.

    Bezpieczeństwo plików projektowych od pierwszej linii

    Jedna z najistotniejszych zmian w zakresie bezpieczeństwa dotyczy ochrony plików .codex w lokalnym projekcie. Dotychczas istniała luka: pierwsze utworzenie takich plików mogło ominąć mechanizm wymagający zatwierdzenia przez użytkownika (approval checks). W tej wersji alfa ta luka została zamknięta. Oznacza to, że nawet inicjalne zapisy do tych kluczowych plików konfiguracyjnych są teraz chronione, co stanowi kolejną barierę przed przypadkowym lub celowym nadpisaniem krytycznych danych projektu.

    Poprawki dotyczą także bardziej zaawansowanych scenariuszy. Naprawiono obsługę uprawnień sandboxa dla symlinkowanych writable roots i carveouts. Bez tej poprawki pewne operacje w powłoce (shell) czy workflow apply_patch mogły kończyć się niepowodzeniem, utrudniając pracę.

    Stabilność TUI, MCP i połączeń sieciowych

    Wydanie przynosi także szereg poprawek zwiększających ogólną stabilność i niezawodność środowiska pracy. Wyeliminowano błędy typu panic przy komendzie codex --remote wss://... poprzez poprawne instalowanie providera kryptograficznego Rustls przed nawiązywaniem połączeń TLS przez WebSocket. Rozwiązuje to problem, który mógł uniemożliwiać korzystanie z funkcji remote.

    W obszarze Model Context Protocol (MCP), dzięki aktualizacji do rmcp 0.8.3, zwiększono niezawodność uruchamiania serwerów MCP. Guardian – system odpowiedzialny za analizę i zatwierdzanie działań – stał się bardziej efektywny dzięki wysyłaniu delt (różnic) w transcriptach zamiast pełnej historii za każdym razem. Dodano też stabilne ID dla recenzji w Guardianie, co ułatwia śledzenie procesów.

    W Tool UI (TUI) zachowano oryginalną kolejność wyników wyszukiwania narzędzi, co jest istotne dla ergonomii pracy – algorytmiczne zmienianie kolejności wyników często dezorientuje użytkowników. Usprawniono też rejestrowanie (recording) dla rolloutów poprzez implementację mechanizmu retry dla nieudanych operacji flush, zmniejszając ryzyko utraty danych diagnostycznych.

    Rozbudowa workflow: autentykacja i komenda exec

    Choć główny nacisk w tym wydaniu położono na bezpieczeństwo i stabilność, nie zabrakło praktycznych usprawnień w workflow. Dodano nowy proces autentykacji dla ChatGPT poprzez device code. To alternatywna, często bezpieczniejsza lub wygodniejsza metoda logowania, szczególnie w środowiskach z ograniczonym dostępem.

    Rozbudowano także możliwości komendy codex exec, która teraz obsługuje piped input. To prosta, lecz bardzo użyteczna zmiana, która pozwala płynniej integrować Codex z istniejącymi potokami (pipelines) deweloperskimi, umożliwiając przekazywanie danych bezpośrednio z innych procesów.

    Podsumowanie: Fundamenty dla Vibe Coding

    Wersja 0.119.0-Alpha.1 Codex to przykład systematycznej pracy nad podstawami. Nie znajdziemy tu spektakularnych nowych modeli AI czy przełomowych interfejsów, ale otrzymujemy solidne wzmocnienie sandboxa, uszczelnienie ochrony lokalnych plików projektu oraz szereg poprawek zwiększających stabilność TUI, MCP i połączeń sieciowych.

    Dla deweloperów pracujących w trybie vibe coding, gdzie płynność i bezpieczeństwo są kluczowe, takie wydania są bezcenne. Eliminują mikroproblemy zakłócające flow i budują środowisko, w którym można skupić się na tworzeniu bez obaw o przypadkowe naruszenie bezpieczeństwa projektu czy nieoczekiwane awarie. To krok w stronę rozwoju Codex nie tylko jako potężnego narzędzia AI, ale także stabilnej i bezpiecznej platformy programistycznej.


    Źródła

  • Cursor Rozszerza Kontrolę: Własne Serwery dla Agentów Chmurowych

    Cursor Rozszerza Kontrolę: Własne Serwery dla Agentów Chmurowych

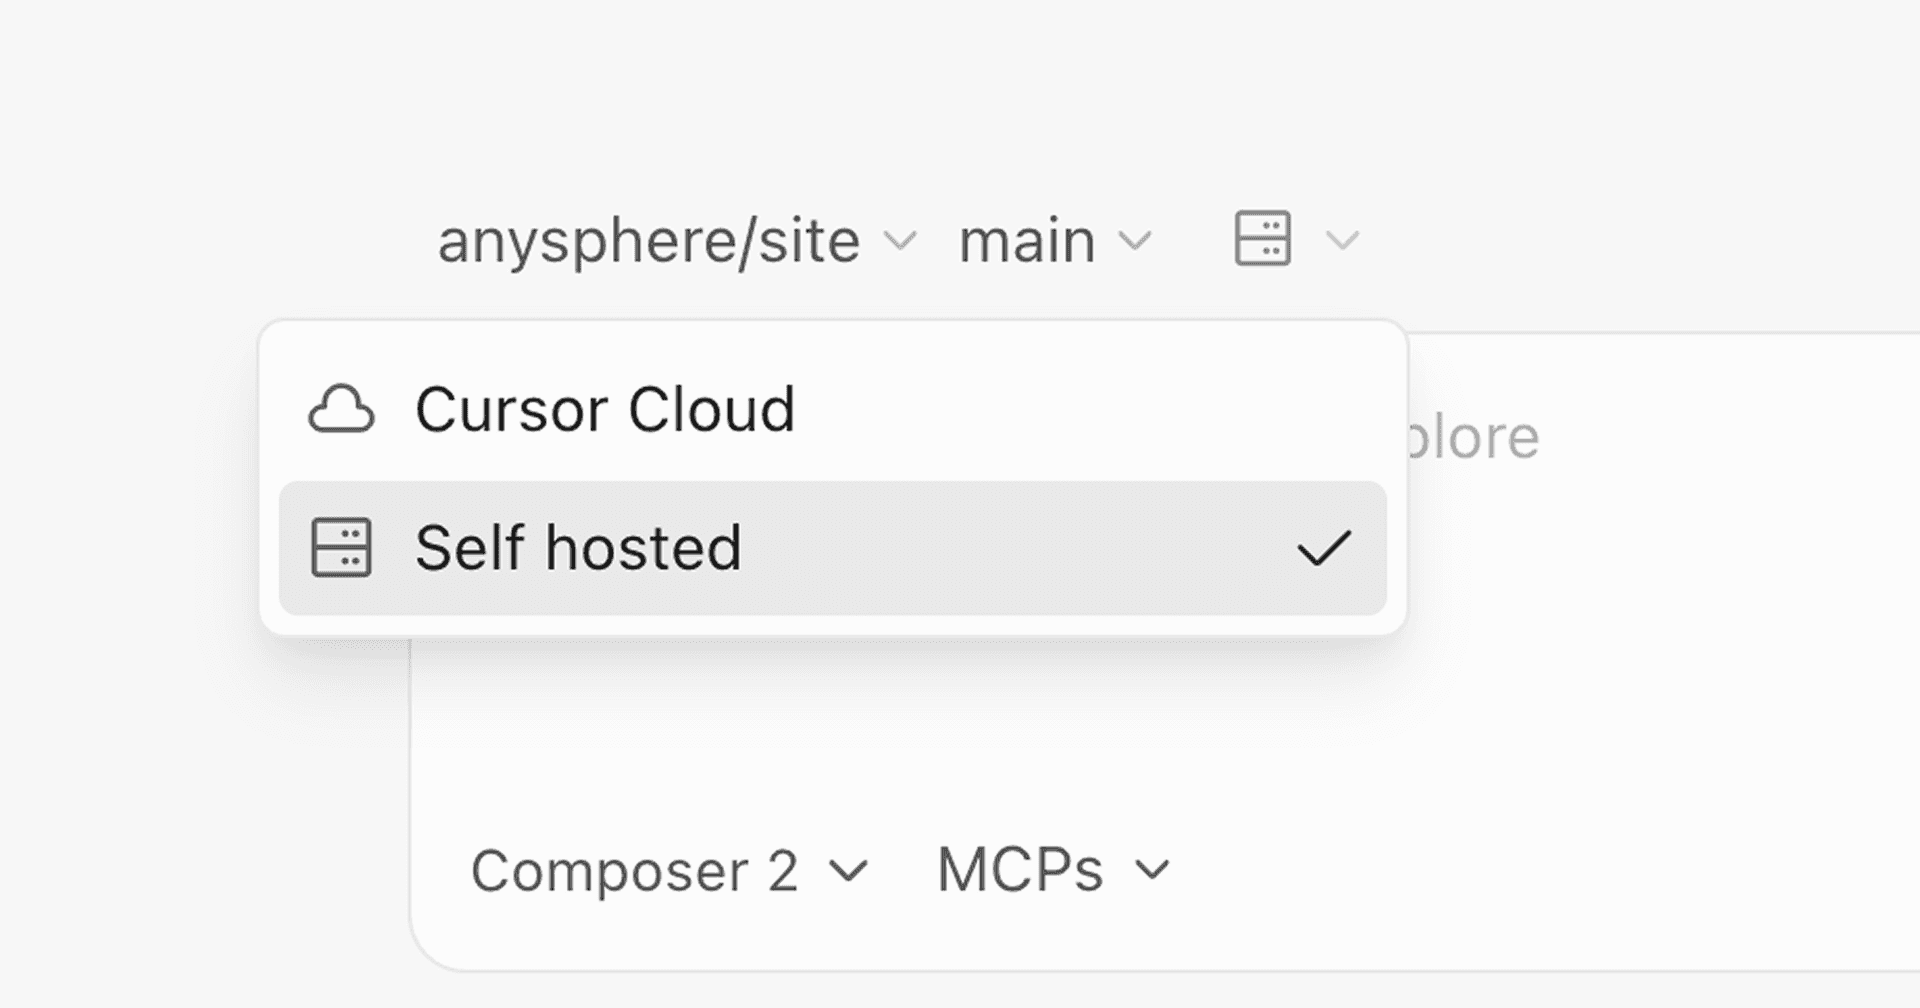
    Dla zespołów deweloperskich, które cenią sobie szybkość sztucznej inteligencji, ale nie chcą rezygnować z kontroli nad wrażliwym kodem, nadchodzi ważna zmiana. Cursor, popularne środowisko programistyczne z wbudowaną AI, wprowadza możliwość samodzielnego hostowania swoich agentów chmurowych. Oznacza to, że cały proces – od kodu źródłowego, przez sekrety, po wyniki buildów – może teraz pozostawać wyłącznie w Twojej infrastrukturze.

    Ta nowa funkcjonalność odpowiada na kluczową potrzebę w branży: jak czerpać korzyści z zaawansowanej automatyzacji AI bez narażania bezpieczeństwa danych. To nie jest okrojona wersja. Agenci hostowani na własnych serwerach oferują identyczne możliwości co ich chmurowe odpowiedniki z infrastruktury Cursor.

    Pełna moc, własna sieć

    Na czym dokładnie polega ta funkcja? Zamiast wysyłać zadania do maszyn wirtualnych zarządzanych przez Cursor, możesz uruchomić tzw. workerów na własnym sprzęcie. Mogą to być serwery on-premise, prywatne chmury w modelu VPC (Virtual Private Cloud) czy instancje u dostawców takich jak Google Compute Engine. Cursor dostarcza specjalny „harness” – zestaw narzędzi do uruchomienia agenta – a reszta pozostaje u Ciebie.

    To rozwiązanie zachowuje wszystkie flagowe możliwości agentów:

    • Izolowane środowiska: Każdy agent działa w dedykowanej maszynie wirtualnej z pełnym dostępem do terminala, przeglądarki i pulpitu. Brak współdzielenia zasobów gwarantuje optymalną wydajność przy równoległym uruchamianiu wielu zadań.
    • Wielomodelowość: Agenci są kompatybilni z nowym Composer 2 od Cursor lub praktycznie z dowolnym modelem klasy „frontier” od głównych dostawców.
    • Rozszerzalność: Wspierane są pluginy, MCP (Model Context Protocol) do integracji z zewnętrznymi narzędziami, subagenci oraz reguły automatyzacji.

    Kluczowa jest tu rola Cursor: platforma nadal odpowiada za interfejs użytkownika, orkiestrację zadań (czyli decydowanie, który agent co wykonuje), dostęp do modeli językowych i dashboard. Cała „robocza” część z kodem i danymi nie opuszcza jednak Twojej sieci.

    Bezpieczeństwo i „vibe coding” w praktyce

    Dla sektorów takich jak finanse, zdrowie czy szeroko pojęty enterprise, gdzie compliance i polityki bezpieczeństwa są priorytetem, ta opcja jest długo wyczekiwaną odpowiedzią. Jak zauważono w materiałach, jeden z dostawców usług finansowych komentuje, że dzięki self-hosted agents może zbudować workflow dla niemal 1000 inżynierów, pozwalający na tworzenie pull requestów bezpośrednio ze Slacka.

    To właśnie jest esencja tzw. vibe coding – koncepcji, w której deweloper staje się bardziej architektem i recenzentem, podczas gdy agenci AI wykonują rutynową lub złożoną pracę programistyczną. Teraz można to robić bez obaw o wyciek własności intelektualnej czy konfiguracji. Zespoły DevOps zachowują pełną kontrolę nad środowiskiem build, siecią wewnętrzną i politykami bezpieczeństwa, jednocześnie odciążając się od zarządzania infrastrukturą pod samą AI.

    Co ciekawe, społeczność już eksperymentuje z zaawansowanymi zastosowaniami, takimi jak uruchamianie agentów z dostępem do potężnych układów GPU Nvidii na GCE w celu przeprowadzania ewaluacji modeli obrazu czy innych wymagających zadań AI.

    Jak zacząć i szerszy kontekst ekosystemu

    Włączenie self-hosted cloud agents jest proste i odbywa się przez Cursor Dashboard. Wszystkie potrzebne instrukcje i dokumentacja są już dostępne.

    To wydanie wpisuje się w szerszą, agentową ewolucję Cursor. Platforma nie jest już tylko edytorem z podpowiedziami, ale warstwą orkiestrującą dla autonomicznych asystentów. Inne niedawne innowacje to Mission Control (dashboard do śledzenia wielu zadań), Cloud Handoff (przekazywanie zadań do chmury jednym znakiem „&”) czy Cursor dla JetBrains poprzez Agent Client Protocol (ACP). Rynek pluginów rozrósł się do ponad 30 pozycji od partnerów takich jak Atlassian czy GitLab, a wbudowani agenci bezpieczeństwa, jak Vuln Hunter, automatycznie skanują kod pod kątem luk.

    Nowy etap w hostowaniu AI dla deweloperów

    Wprowadzenie self-hosted cloud agents przez Cursor to wyraźny sygnał, że przyszłość rozwoju oprogramowania z AI będzie hybrydowa. Nie chodzi o wybór między pełną kontrolą a nowoczesnością, ale o ich połączenie. Dla firm, które do tej pory z rezerwą podchodziły do przetwarzania swojego kodu w zewnętrznych serwisach AI, otwiera to drzwi do bezpiecznego eksperymentowania i produktywnego wdrażania automatyzacji.

    Jest to krok istotny nie tylko dla bezpieczeństwa, ale też dla elastyczności. Pozwala dopasować moc obliczeniową agentów do specyficznych potrzeb projektu – czy to pod kątem specjalistycznego sprzętu, lokalizacji danych, czy integracji z wewnętrznymi narzędziami DevOps. W rezultacie zespoły zyskują potężnego, autonomicznego współpracownika, który działa tam, gdzie one chcą, zachowując pełną zgodność z ich infrastrukturą.


    Źródła

  • Era szybkiego klejenia kodu: jak AI generuje kryzys bezpieczeństwa

    Era szybkiego klejenia kodu: jak AI generuje kryzys bezpieczeństwa

    Kilka tygodni temu internet oszalał na punkcie pewnej platformy społecznościowej zarządzanej wyłącznie przez agentów AI. Boty pisały posty, prowadziły dyskusje, tworzyły własne społeczności. Eksperyment był fascynujący, dopóki nie ujawniono poważnego wycieku danych. Źródłem problemu nie był zaawansowany atak hakerski. Był nim vibe coding – intuicyjne, szybkie klejenie kodu za pomocą AI, które postawiło szybkość działania ponad bezpieczeństwem.

    Ta historia dobrze ilustruje rosnący paradoks współczesnego programowania. Z jednej strony narzędzia AI oferują niewiarygodną wydajność. Z drugiej – bezkrytyczne zaufanie do generowanych przez nie rozwiązań rodzi dług techniczny i bezpieczeństwa na niespotykaną skalę. Badania i dane z pierwszych linii frontu są alarmujące: zbliżamy się do punktu krytycznego.

    Czym naprawdę jest vibe coding i dlaczego jest niebezpieczne?

    Vibe coding to potoczne określenie na szybkie, intuicyjne wykorzystywanie agentów AI i generatywnych modeli (jak GitHub Copilot, ChatGPT) do produkcji kodu. Chodzi o uzyskanie działającego rozwiązania na już, często z pominięciem rygorystycznych recenzji i zasad inżynierii oprogramowania. To jak programowanie „na czuja”, gdzie liczy się głównie to, by błąd zniknął, a funkcjonalność zaczęła działać.

    Problem w tym, że AI optymalizuje pod kątem usunięcia błędu kompilacji lub runtime’u, a nie zapewnienia bezpieczeństwa. Model językowy nie rozumie semantyki ani konsekwencji kodu, który generuje. Dla niego zapora bezpieczeństwa to po prostu kolejna linijka, która może powodować błąd. Jego celem jest dopasowanie się do wzorca, który sprawi, że program się skompiluje.

    Analizy wskazują, że prowadzi to do trzech kluczowych wzorców porażki:

    1. Prędkość ponad bezpieczeństwo: AI często usuwa checksy walidacyjne, polisy dostępu do bazy danych lub mechanizmy uwierzytelniania, po prostu po to, by błąd zniknął.
    2. Brak świadomości efektów ubocznych: Agent pracujący na pojedynczym pliku może nie widzieć kontekstu całej aplikacji. Naprawa buga w jednym miejscu często powoduje wyciek bezpieczeństwa w innym.
    3. Dopasowywanie wzorców, nie osąd: LLM nie wie, dlaczego dana kontrola bezpieczeństwa istnieje. Wie tylko, że jej usunięcie pasuje do składniowego wzorca „naprawy błędu”.

    Twarde dane: skala problemu w liczbach

    Statystyki pochodzące z analiz i ankiet wśród developerów malują niepokojący obraz bliskiej przyszłości. Wiele osób używa narzędzi AI do kodowania, ale zaufanie do generowanego kodu jest ograniczone.

    • Znaczna część nowego kodu jest już generowana przez AI. To nie jest niszowy trend, to nowa norma.
    • Zadania związane z generowaniem kodu przez AI mogą wprowadzać do aplikacji znane luki bezpieczeństwa.
    • Kod AI może zawierać więcej przypadków narażonych na wyciek credentiali (klucze API, hasła) niż kod pisany przez człowieka.
    • Wskaźnik Długu Technicznego (TDR) przekraczający 20% to sygnał ostrzegawczy dla organizacji. Oznacza, że system staje się tak skomplikowany i pełen „kleju”, że prędkość rozwoju (velocity) gwałtownie spada, mimo że kod wciąż jest produkowany.

    Vibe coding generuje tzw. „glue code” – kod, który na sztywno łączy zależności (np. konkretne wersje API), omija warstwy serwisowe i ukrywa się przed aktualizacjami. Eksperci porównują to do „kredytu subprime” w świecie oprogramowania – pozorna płynność dziś, za którą przyjdzie zapłacić ogromnymi kosztami utrzymania (TCO) w przyszłości.

    Prawdziwe bugi z linii frontu: od teorii do praktyki

    Te obserwacje nie są oderwane od rzeczywistości. Przekładają się na konkretne, powtarzalne błędy, które widać w codziennej pracy z agentami. Oto trzy proste, ale bardzo niebezpieczne przykłady:

    1. Wystawione klucze API na frontendzie. Kiedy agent ma problem z wywołaniem zewnętrznego API (np. OpenAI) z kodu React, jego najprostszym „rozwiązaniem” jest często wklejenie klucza bezpośrednio do pliku frontendowego. Klucz widzi potem każdy użytkownik, który użyje „Inspect Element” w przeglądarce.
    2. Publiczny dostęp do całej bazy danych. Gdy zapytanie do bazy (np. Supabase czy Firebase) zwraca błąd „Permission Denied”, AI często sugeruje zmianę polityki dostępu na USING (true). Błąd znika, kod działa. Niestety, cała tabela (lub cała baza) staje się publicznie czytelna z internetu.
    3. Podatności XSS (Cross-Site Scripting). Kiedy trzeba wyrenderować surowy HTML w komponencie React, agent natychmiast podsuwa dangerouslySetInnerHTML. Rzadko kiedy sugeruje najpierw użycie biblioteki do sanityzacji wejścia, jak dompurify. To otwiera furtkę dla ataków, gdzie złośliwe skrypty wykonają się na urządzeniach użytkowników.

    Nadchodzące lata: prognozowany szczyt kryzysu

    Eksperci są zgodni: to nie jest zwykły, stopniowo narastający dług techniczny. Jesteśmy świadkami wykładniczego wzrostu podatności i degradacji jakości kodu.

    Nadchodzące lata są wskazywane jako moment, w którym ten kryzys może osiągnąć apogeum. Dlaczego? Bo dług się kumuluje. Kod generowany dziś, pełen ukrytych zależności i „łatanych” zabezpieczeń, stanie się podstawą kolejnych funkcjonalności jutro. Koszty utrzymania i refaktoryzacji osiągną poziom, który unieruchomi zespoły. Jak trafnie zauważa jeden z analityków: „Kiedy firma stawia na prędkość, a nie na strukturę, pożycza czas od swojej przyszłej wersji. W erze AI to pożyczanie dzieje się z prędkością światła”.

    Dodajmy do tego nowe, specyficzne dla AI zagrożenia:

    • Ataki typu prompt injection, gdzie złośliwe instrukcje w danych wejściowych mogą nakłonić model do ujawnienia informacji lub wygenerowania szkodliwego kodu.
    • Zhalucynowane pakiety i zależności. AI może podać nazwę nieistniejącej biblioteki. Jeśli cyberprzestępca zarejestruje taki pakiet w publicznym repozytorium, dostarczy w ten sposób backdoora prosto do aplikacji.

    Jak vibe codować odpowiedzialnie? Strategie obrony

    Cofanie się i rezygnacja z AI nie jest ani realistyczna, ani pożądana. Narzędzia te oferują ogromny skok produktywności. Kluczem jest zmiana podejścia i wprowadzenie świadomej governancji. Oto trzy filary, na których można oprzeć bezpieczną pracę z agentami:

    • 1. Lepsze prompty i specyfikacje*
      Nie można po prostu napisać „zrób to bezpiecznie”. To za mgliste dla LLM. Zamiast tego trzeba stosować development sterowany specyfikacją. Przed rozpoczęciem pracy z agentem należy mu przekazać jasne, predefiniowane polityki bezpieczeństwa: „Brak publicznego dostępu do bazy, żadnych zahardkodowanych secretów, sanityzacja danych wejściowych, pisanie testów jednostkowych”. Dobrym punktem wyjścia jest OWASP Top 10.
      Badania pokazują też, że prompting metodą łańcucha myśli (Chain-of-Thought) znacząco redukuje ryzyko. Zamiast „napraw błąd”, zapytaj: „Jakie są zagrożenia bezpieczeństwa w tym podejściu i jak zamierzasz ich uniknąć? Opisz swoją logikę krok po kroku.”

    • 2. Recenzje kodu to nowe pisanie kodu*
      Badacze ostrzegają, że bez kontroli agenci mogą po prostu generować „szmelc”. Gdy coraz więcej kodu powstaje automatycznie, podstawową pracą developera staje się jego recenzja. To jak praca z stażystą – nie pozwalasz mu wpuścić kodu do produkcji bez dokładnego przeglądu. Trzeba patrzeć na diffy, sprawdzać testy, oceniać jakość. Pokusa, by zaakceptować sugestię AI po jednym spojrzeniu na działający interfejs, jest ogromna, ale droga do katastrofy.

    • 3. Zautomatyzowane bariery ochronne (guardrails)*
      Przy takim tempie rozwoju człowiek nie jest w stanie wyłapać wszystkiego. Dlatego bezpieczeństwo musi być zautomatyzowane. To oznacza:

    • Skannery w pre-commit hooks i pipeline’ach CI/CD, które automatycznie blokują commity zawierające zahardkodowane sekrety, niebezpieczne wzorce czy publiczne polityki dostępu.

    • Narzędzia takie jak GitGuardian czy TruffleHog do skanowania repozytoriów pod kątem wycieków.

    • Architektury „LLM-in-the-loop”, gdzie model generuje kod, a zestaw deterministycznych narzędzi go weryfikuje. Niebezpieczna zmiana jest odrzucana automatycznie, zanim trafi do recenzji.

    Co ciekawe, organizacje wykorzystujące AI do remediacji są w stanie naprawiać więcej podatności, szybciej niż przy manualnych procesach. AI może być więc zarówno źródłem problemu, jak i częścią rozwiązania – pod warunkiem że jest odpowiednio ukierunkowana.

    Podsumowanie: produktywność z otwartymi oczami

    Vibe coding i agenci AI nie są złem samym w sobie. To potężne narzędzia, które demokratyzują tworzenie oprogramowania i przyspieszają rozwój w niespotykanym dotąd tempie. Prawdziwym wyzwaniem nie jest technologia, ale ludzkie podejście do jej używania.

    Kryzys długu bezpieczeństwa, który rysuje się na horyzoncie, nie jest nieunikniony. Jest konsekwencją wyboru szybkości za wszelką cenę, bez inwestycji w struktury, governancję i kulturę jakości. Jak podsumowano w jednym z raportów: „Obawy dotyczące vibe coding i agentów, że tworzą gigantyczny dług techniczny, nie są przesadzone… ale wymagają od nas otwartych oczu i świadomego zarządzania.”

    Przyszłość należy do tych, którzy potrafią połączyć prędkość generatywnej AI z dyscypliną inżynierii oprogramowania. Bo w świecie, gdzie kod pisze się szybciej niż kiedykolwiek, najcenniejszym zasobem przestaje być czas pisania, a staje się czas na myślenie, recenzję i zabezpieczanie.

  • Umiejętności AI to nowy, niebezpieczny cel ataków – alarmują eksperci

    Umiejętności AI to nowy, niebezpieczny cel ataków – alarmują eksperci

    Organizacje, które korzystają z zaawansowanych asystentów AI, mogą nieświadomie otwierać zupełnie nowe furtki dla ataków. TrendAI opublikowało raport, w którym wskazuje, że "umiejętności AI" stanowią nową, niebezpieczną powierzchnię ataku.

    Co to właściwie są te "umiejętności"? To wykonawcze artefakty, które łączą czytelny dla człowieka tekst z instrukcjami dla dużych modeli językowych (LLM). Chodzi o rzeczy takie jak Agent Skills od Anthropic, GPT Actions od OpenAI czy Copilot Plugin Microsoftu.

    Są one używane do skalowania operacji AI. Jak wyjaśnia raport, umiejętności AI "kapsułkują wszystko, od elementów takich jak ludzka ekspertyza, przepływy pracy i ograniczenia operacyjne, po logikę decyzyjną". Przechwytują tę wiedzę w coś, co można wykonać.

    Dlaczego to taki problem?

    Problem leży w ich naturze. Ponieważ mieszają dane dostarczone przez użytkownika z instrukcjami, a definicje umiejętności mogą również mieszać zarówno dane, jak i instrukcje i mogą odnosić się do zewnętrznych źródeł danych, jak pisze TrendAI.

    To połączenie danych i logiki wykonywalnej tworzy niejednoznaczność. W rezultacie narzędziom obronnym, a nawet samemu silnikowi AI, trudno jest bezpiecznie odróżnić prawdziwe instrukcje analityka od treści dostarczonych przez atakującego. Stąd niezdolność do obrony przed atakami typu injection.

    Jeśli atakujący uzyska dostęp do logiki stojącej za umiejętnością, może to dać mu znaczną możliwość wykorzystania – ostrzega raport. Atakujący może też po prostu zdecydować się na handel lub wyciek pozyskanych danych, ujawniając w ten sposób wrażliwe informacje organizacyjne.

    Potencjalne skutki są poważne. Z dostępem do danych operacyjnych i logiki biznesowej, przeciwnicy mogliby zakłócać usługi publiczne, sabotować procesy produkcyjne, kraść dane pacjentów i wiele więcej. Właściwie wyobraź sobie, że ktoś przejmuje kontrolę nad AI zarządzającą systemem energetycznym albo procesem medycznym. To potencjalne scenariusze.

    SOC-y z AI w szczególnym niebezpieczeństwie

    Raport wskazuje, że ryzyko jest szczególnie duże dla centrów operacji bezpieczeństwa (SOC) wykorzystujących sztuczną inteligencję, z eskalacją od kompromitacji taktycznej po strategiczną, umożliwiającą tworzenie cyfrowych bliźniaków. Zagrożenie polega na tym, że agenci zagrożeń mogliby identyfikować i wykorzystywać martwe punkty wykrywania w SOC. To naprawdę niepokojące, biorąc pod uwagę, że te zespoły są pierwszą linią obrony.

    Wyzwanie dla obrońców sieci polega na tym, że wiele ich narzędzi bezpieczeństwa nie jest w stanie skutecznie wykrywać, analizować i łagodzić zagrożeń ze strony nieustrukturyzowanych danych tekstowych, którymi są umiejętności AI. Tradycyjne zabezpieczenia po prostu tego nie widzą.

    Jak się bronić?

    Raport sugeruje konkretne działania. Zaleca monitorowanie integralności umiejętności, szukanie manipulacji logiką SOC oraz polowanie na anomalie w wykonaniu, dostępie do poświadczeń i przepływie danych. Przedstawia nawet nowy, ośmiofazowy model łańcucha zabójczego specyficzny dla umiejętności AI, pokazujący, gdzie są nowe możliwości wykrywania złośliwej aktywności.

    Ale kluczowe wydają się być podstawowe zasady. TrendAI rekomenduje traktowanie umiejętności jako wrażliwej własności intelektualnej, z odpowiednią kontrolą dostępu, wersjonowaniem i zarządzaniem zmianami. Warto też oddzielić logikę i dane umiejętności od niezaufanych danych dostarczonych przez użytkownika, które mogą prowadzić do możliwości wykorzystania.

    Kolejna rada to ograniczenie uprawnień wykonawczych poprzez stosowanie zasad najmniejszych przywilejów podczas projektowania umiejętności. Ograniczenie kontekstu wykonania do minimalnych wymaganych uprawnień ma zapobiec ruchom bocznym. To bardzo klasyczne podejście do bezpieczeństwa, ale tutaj nabiera nowego znaczenia.

    Raport kończy się dwoma kluczowymi zaleceniami. Po pierwsze, przed wdrożeniem należy przetestować, jak przeciwnicy mogliby wykorzystać logikę operacyjną. Po drugie, monitorowanie, rejestrowanie i audytowanie musi być ciągłe, tak jak w przypadku każdego procesu biznesowego. Jest to szczególnie ważne w środowiskach z obsługą AI, gdzie tradycyjne granice bezpieczeństwa się zacierają.

    TrendAI podkreśla, że te zasady to po prostu dobre praktyki bezpieczeństwa, ale teraz trzeba je zastosować do zupełnie nowej kategorii zasobów. Ignorowanie tego ryzyka może kosztować organizacje nie tylko dane, ale także ciągłość działania. A w niektórych sektorach, jak ochrona zdrowia czy infrastruktura krytyczna, konsekwencje mogą być znacznie poważniejsze.

    Źródła